快速掌握
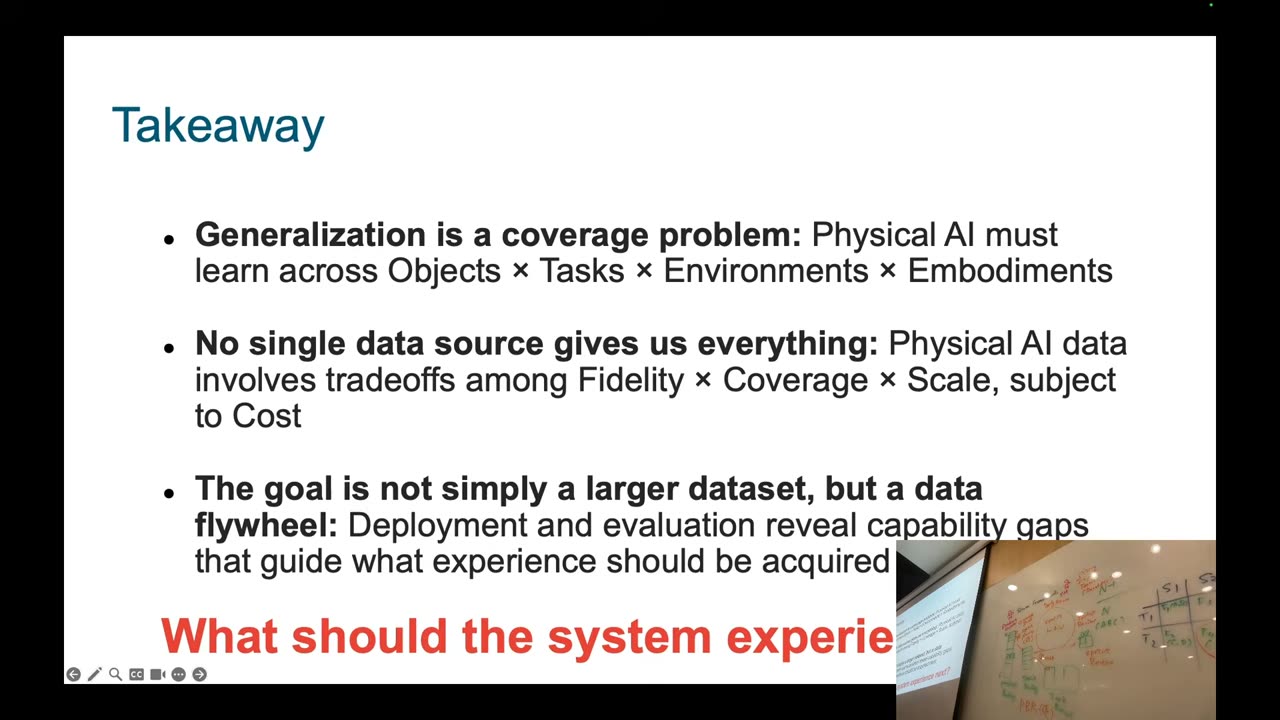
本講核心:Physical AI 的瓶頸不只是模型,而是資料。真正重要的不是「資料夠不夠多」,而是資料是否涵蓋目標任務需要的物件、任務、環境與實體形式;部署後是否能辨識能力缺口,再回頭收集最有價值的新經驗。
- 資料量只是第一層問題;更重要的是資料涵蓋度與品質。
- 資料飛輪不是一直收集更多資料,而是從部署與評估找到能力缺口,再收集能補缺口的資料。
- coverage 會隨物件、任務、環境、實體形式組合爆炸,因此必須由評估目標引導。
- 資料取得策略要在擬真度、涵蓋度、規模與成本之間取捨。
三個研究問題:資料是通用 Physical AI 的核心瓶頸
看老師講解(Part 1 · 19:10)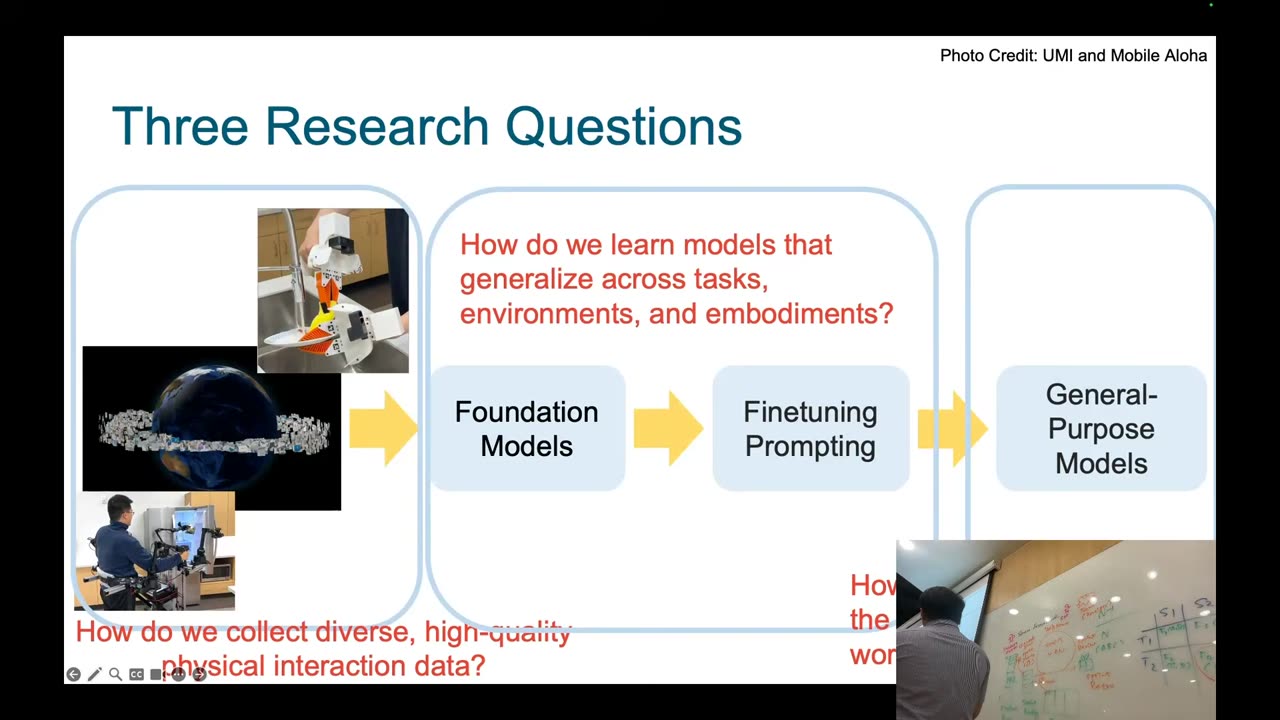
如果想建立 general-purpose model,不能只問模型架構。必須先問:物理互動資料如何取得?資料是否足以涵蓋真實世界變化?訓練出的系統又如何透過部署與評估確認有效?這些問題導向本講主題:資料飛輪。
三層資料思維:從資料量走向資料價值
看老師講解(Part 1 · 20:15)
機器學習專案常被問「資料集夠大嗎?」但在 Physical AI 裡,單純追求資料量很容易失焦。資料量再大,如果只涵蓋單一任務、單一物件或單一環境,部署後仍可能失敗。講者因此引入第二層:資料涵蓋度;以及第三層:哪些資料最有價值。
資料集思維 vs 資料飛輪
看老師講解(Part 1 · 25:30)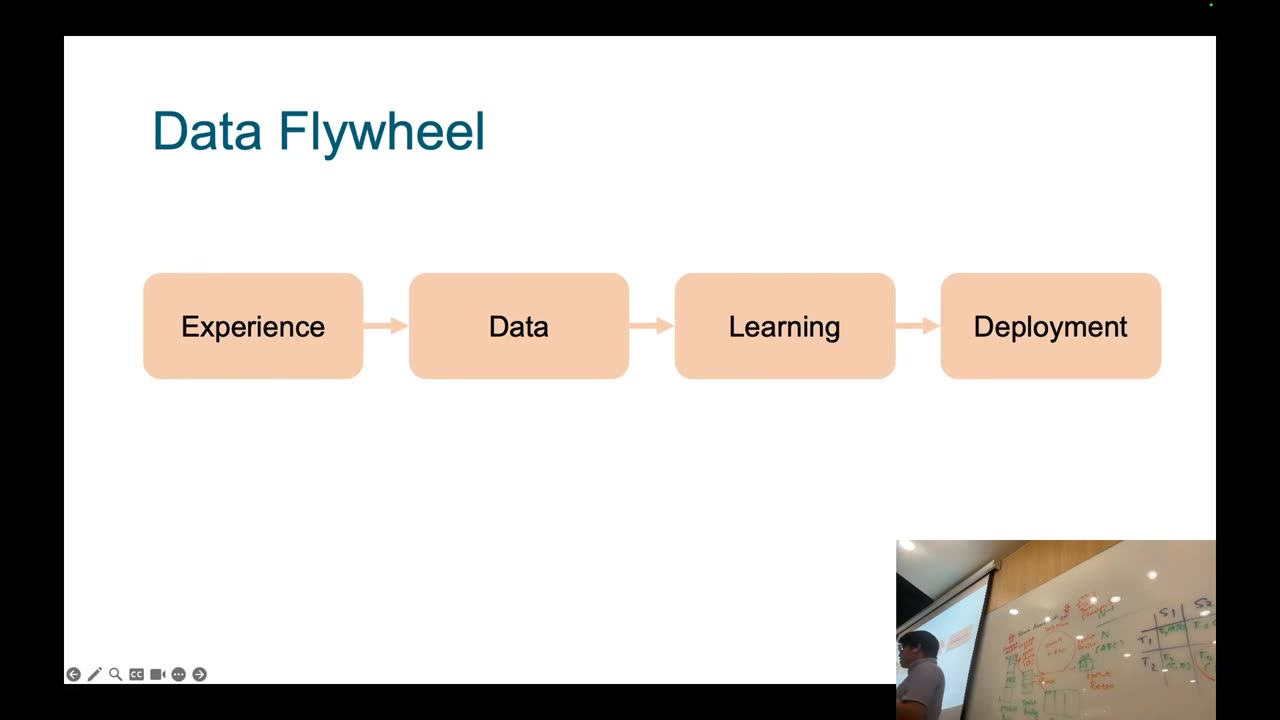
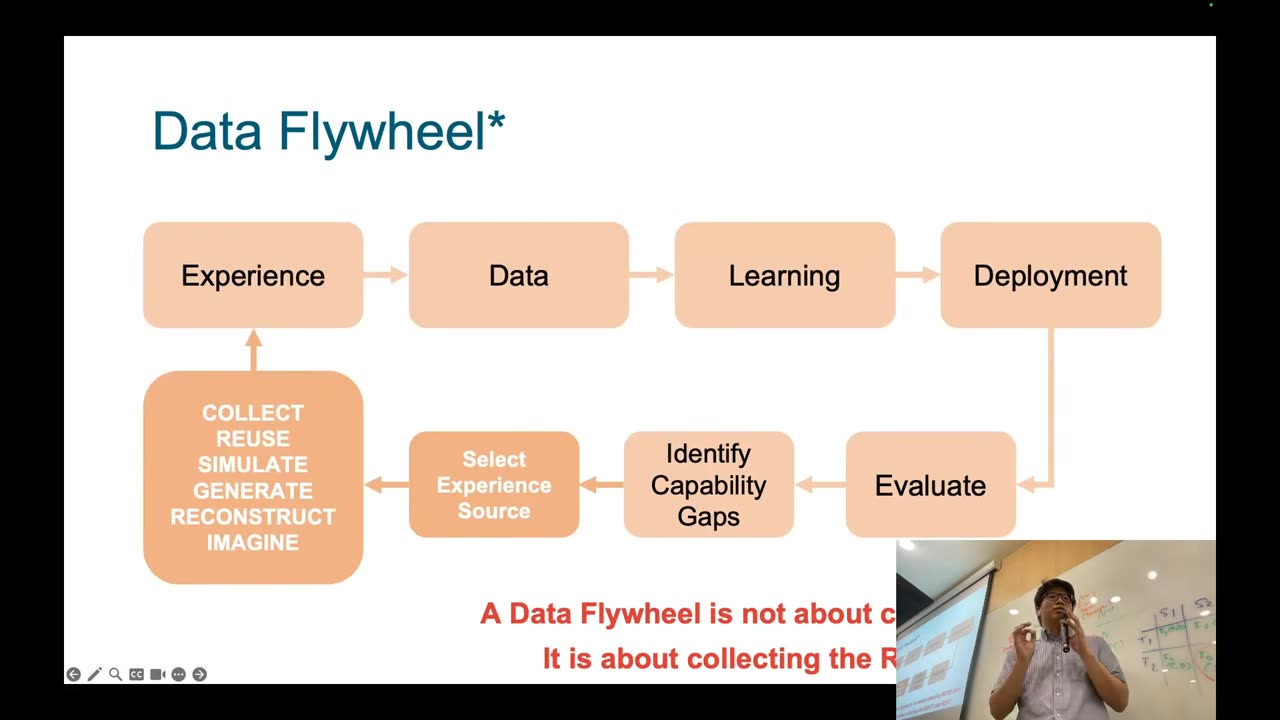
傳統資料集思維常是:收集資料、訓練模型、在 benchmark 上比前人好 5%,然後結束。但 Physical AI 面對真實世界時,需要持續回答:模型在哪些條件下失敗?失敗代表缺少哪種經驗?下一步應該收集什麼資料?
資料涵蓋度:物件 × 任務 × 環境 × 實體形式
看老師講解(Part 1 · 31:30)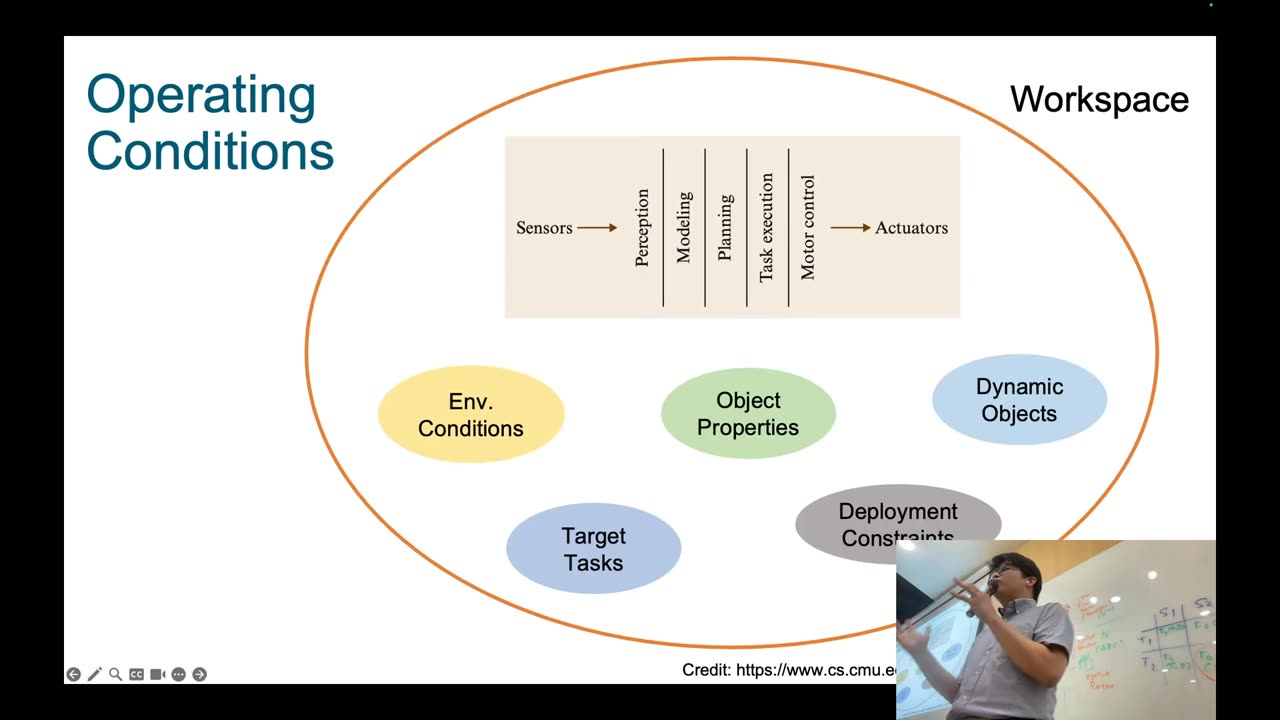
涵蓋度不是抽象名詞,而是要具體問:資料涵蓋哪些物件?哪些任務?哪些環境?哪些機器人或實體形式?如果只收集很多房間 layout,可能只增加 layout 多樣性,卻沒有增加物件、任務或動態互動的涵蓋度。
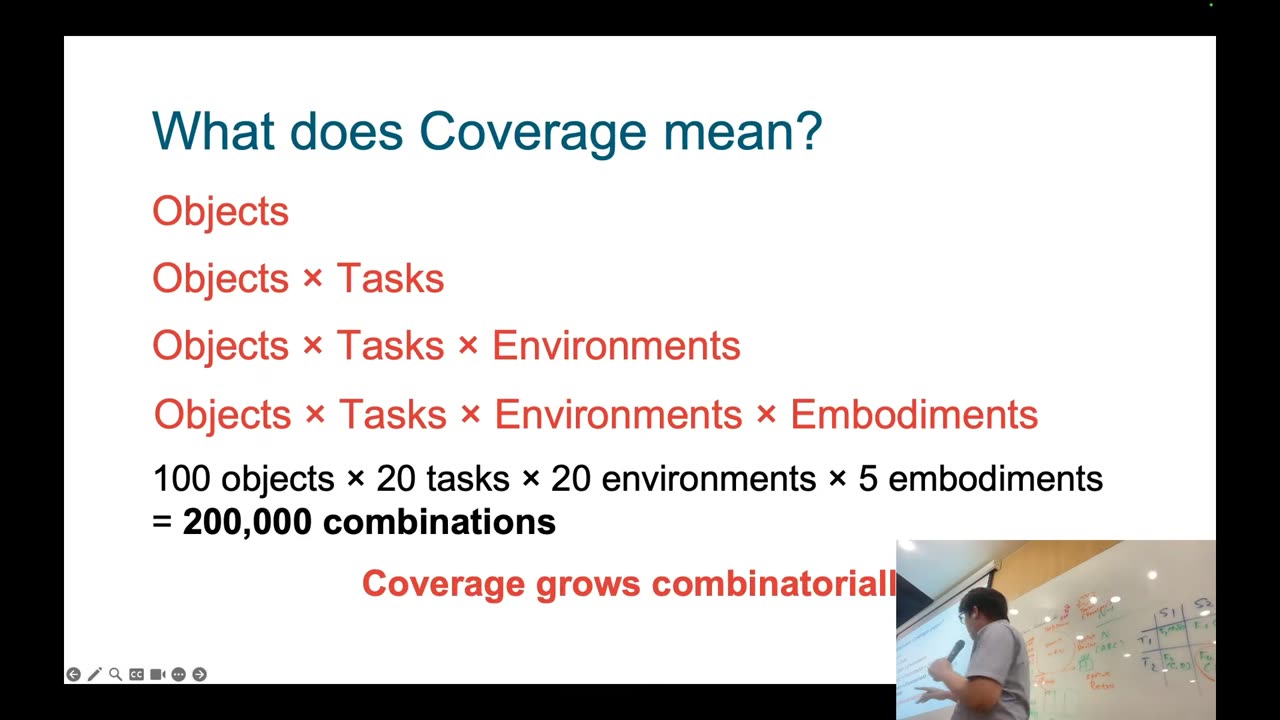
這也是為什麼不能盲目收集全部資料。組合數成長太快,必須用評估目標決定哪些維度最重要:是物件變化?任務變化?環境變化?還是機器人 embodiment 變化?
能力缺口:下一筆資料應該收集什麼?
看老師講解(Part 1 · 50:30)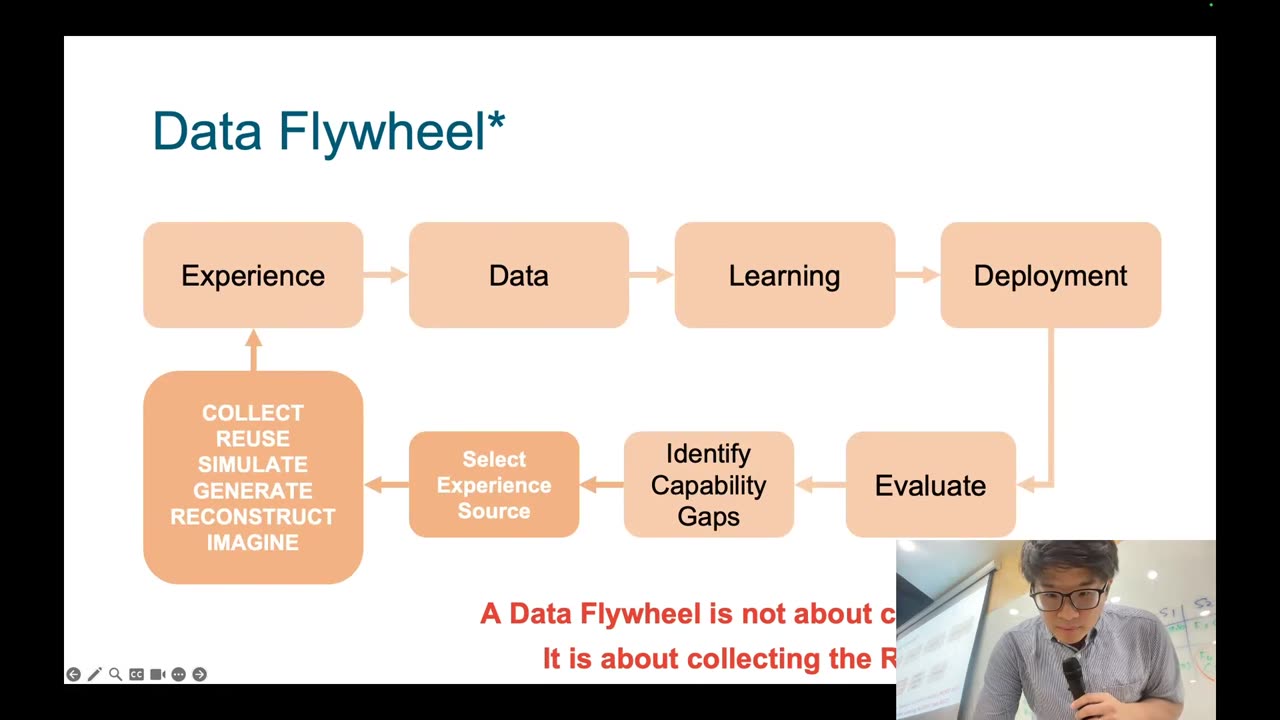
部署與評估會回傳失敗訊號。這些失敗不是單純扣分,而是指向下一輪資料收集策略:要從真實世界收集?在模擬中產生?重建場景?生成變化?還是想像更多條件?資料飛輪的價值在於把失敗轉成下一步資料取得的決策。
資料取得策略:擬真度、涵蓋度、規模與成本
看老師講解(Part 1 · 53:30)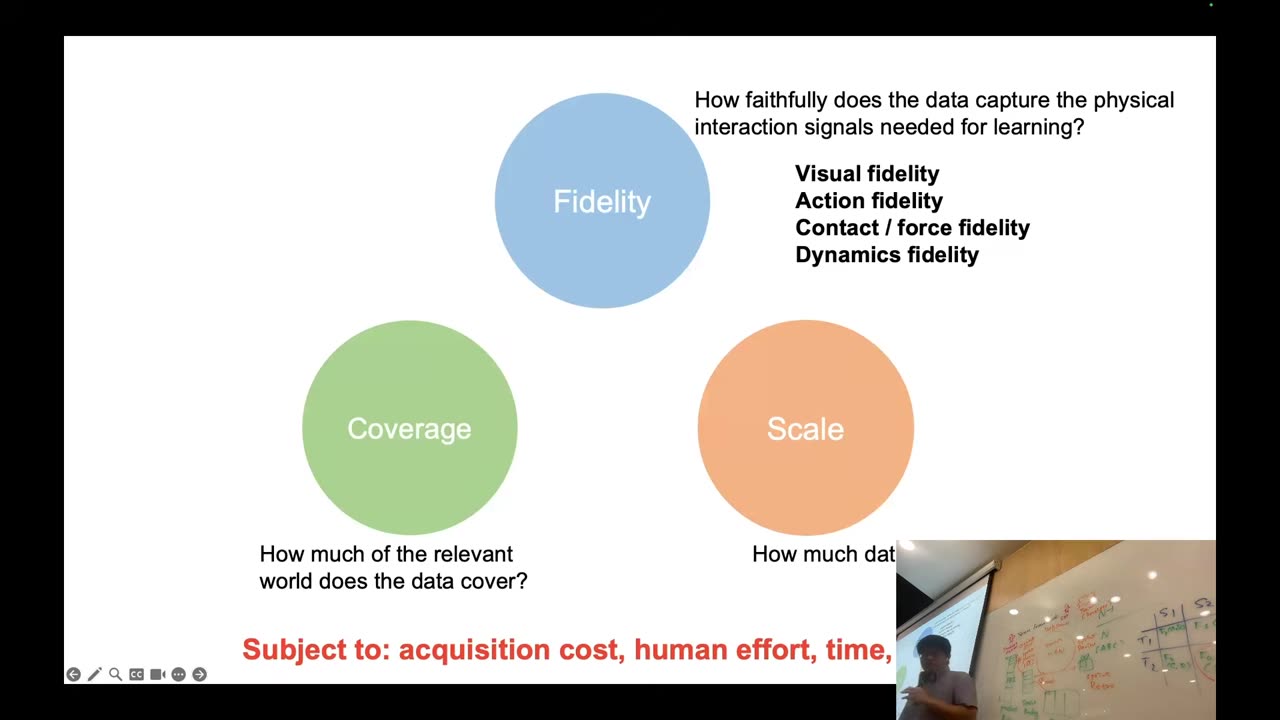
真實機器人資料擬真度高,但成本高、速度慢、風險大。模擬或生成資料規模較容易擴大,涵蓋度也能設計,但可能缺少真實物理互動訊號。選擇資料策略時,必須回到評估目標:目前能力缺口需要的是高擬真度、更多涵蓋度,還是更大規模?
七種資料取得策略:不是只有真實機器人收資料
看老師講解(Part 2 · 5:00)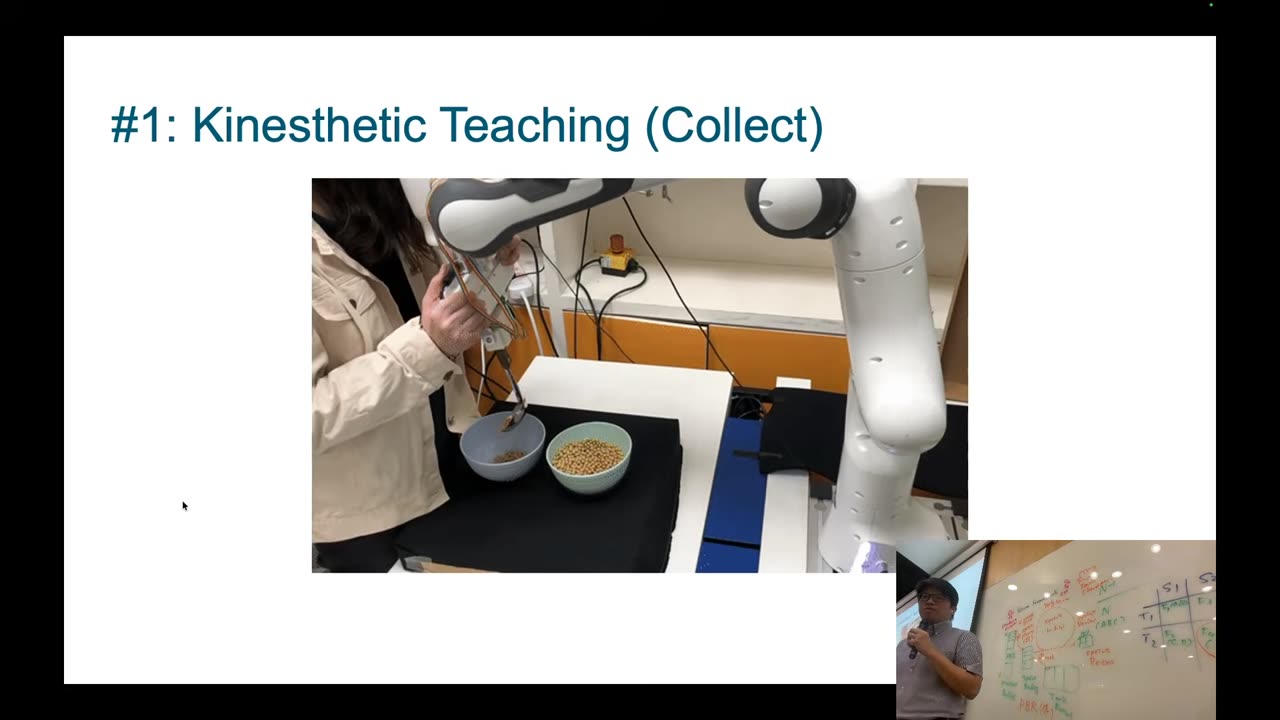
第二段課程把資料飛輪落到實作層次:社群已經發展出多種取得或產生經驗資料的方法。第一類是 kinesthetic teaching,也就是人直接帶著機器人做任務。它的擬真度高,因為資料來自真實機器人與真實物理互動;但成本高、速度慢,也受限於操作人員與設備。
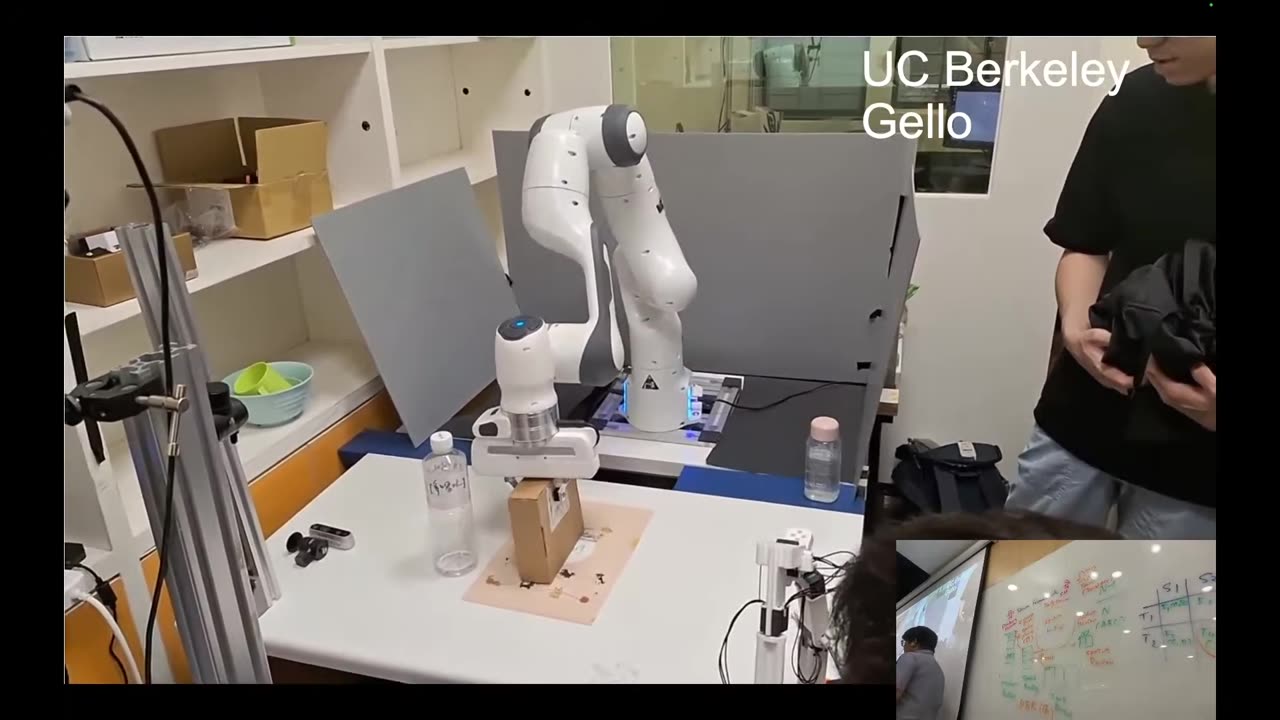
遙操作看似比直接牽引更容易擴展,但也有代價:操作者缺少觸覺回饋,常從第三人稱視角控制機器手臂,不一定能感覺自己是機器人的一部分。因此資料品質和操作介面設計高度相關。
從影片學習:資料規模巨大,但後處理很難
看老師講解(Part 2 · 20:00)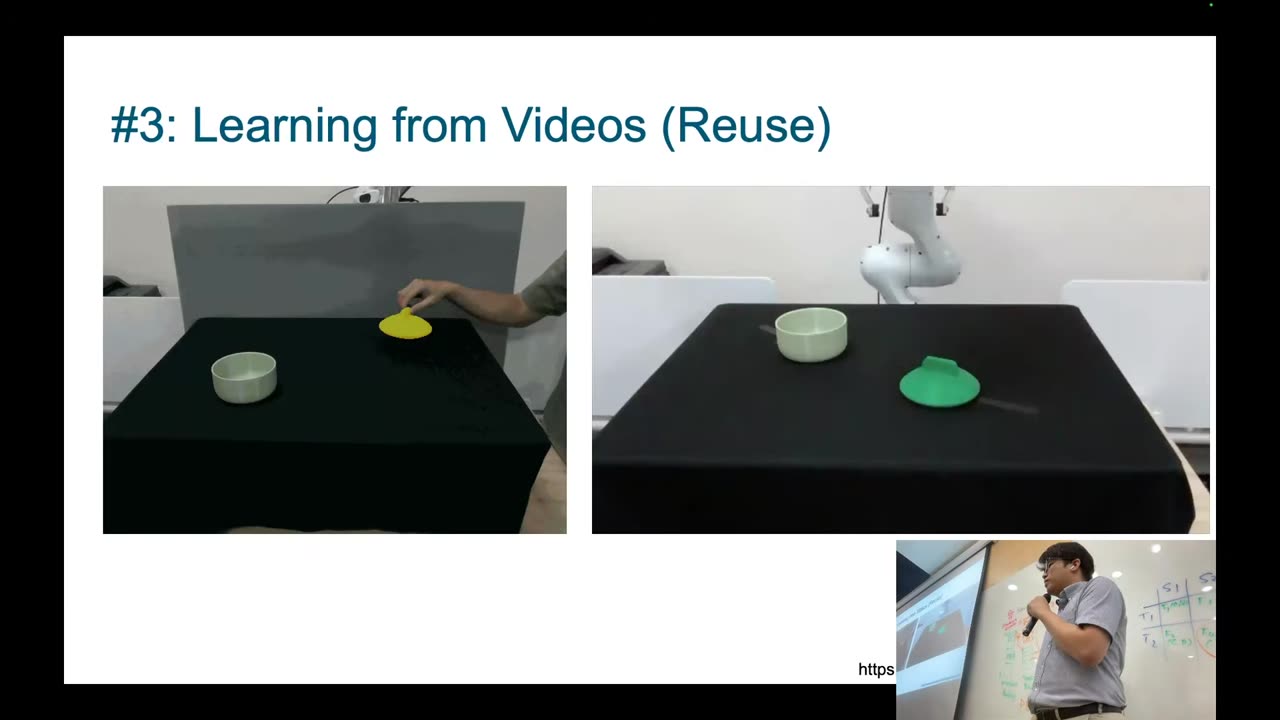
影片資料的吸引力在於規模:網路上有大量人類操作影片。但它不是免費午餐。人手和機器手的 embodiment 不同,人類動作更快、更靈活,影片也缺少力覺與接觸訊號。如何從影片中估計手部骨架、物體狀態,再映射到機器人,是一個困難的研究問題。
模擬、程序生成與 world model:用算力換涵蓋度
看老師講解(Part 2 · 30:00)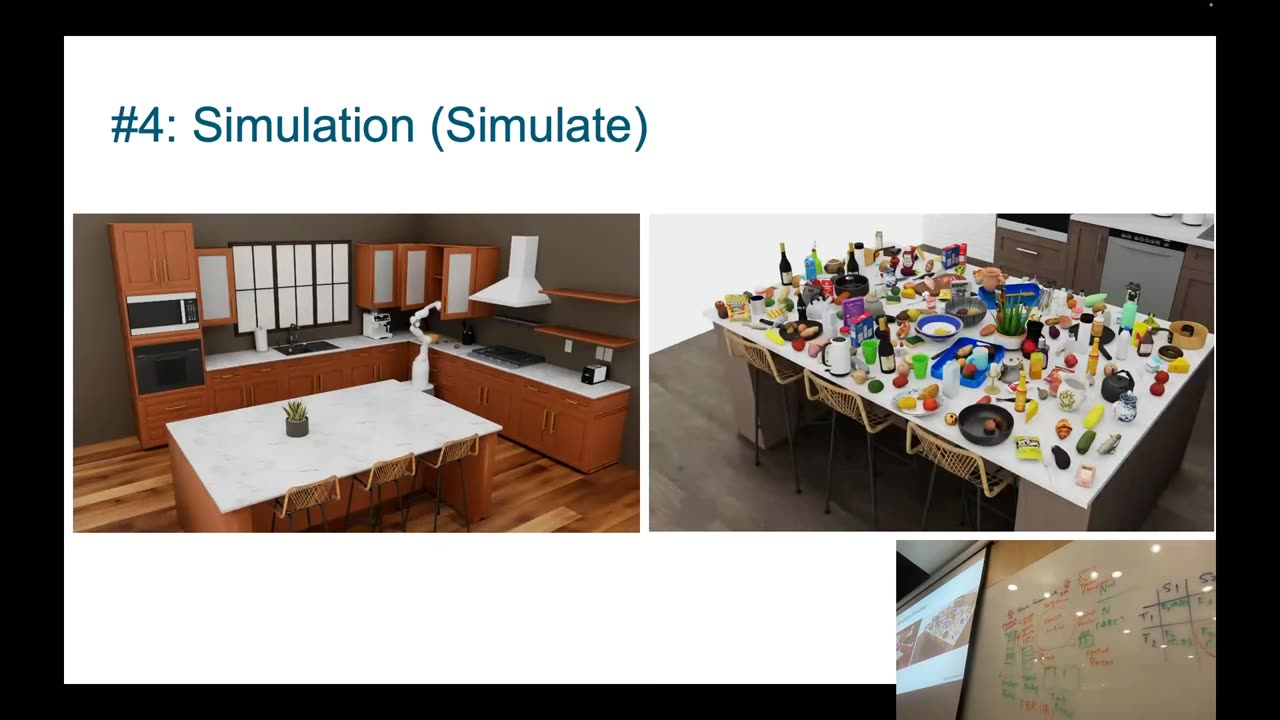
模擬的優點是可控制、可平行化、可大量產生環境變化;缺點是 sim-to-real gap。若目標需要精細接觸、柔性物體、液體或摩擦細節,模擬不一定忠實捕捉真實互動訊號。
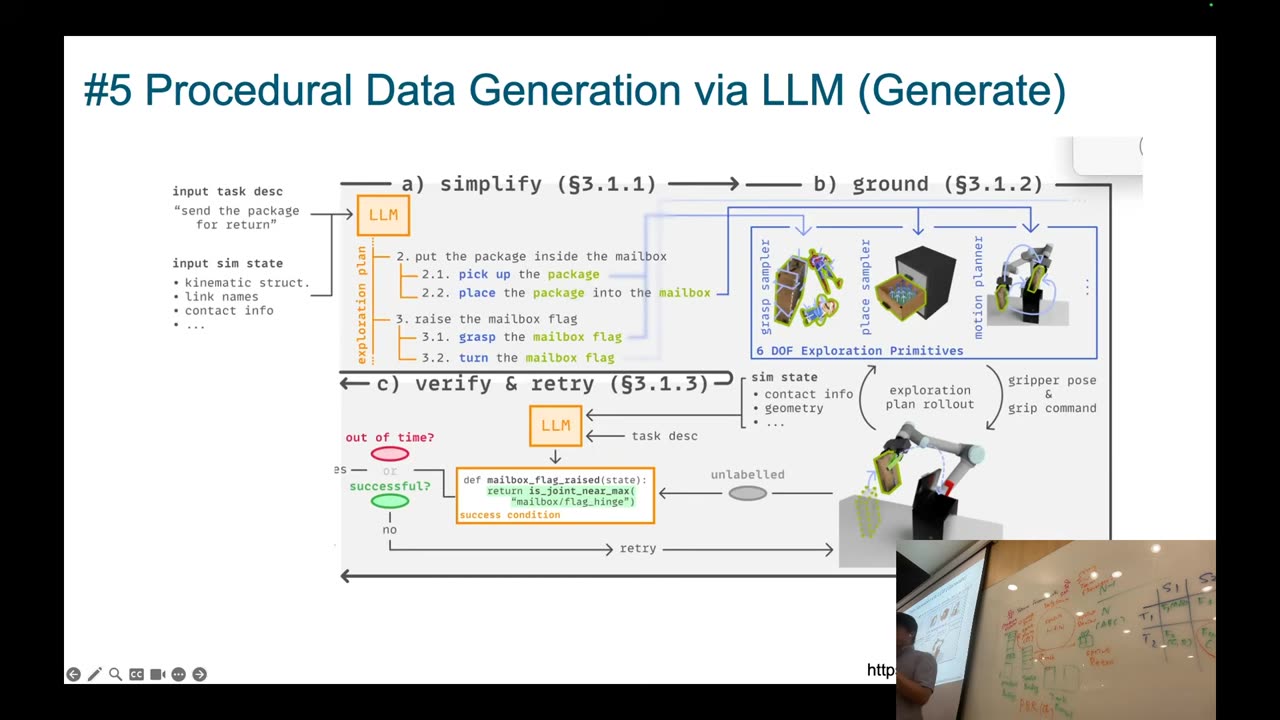
程序式生成與 LLM 可以快速擴展任務描述、場景配置與物件組合,提升涵蓋度。但生成出來的資料仍要回到評估:它是否補到真正能力缺口?還是只增加表面多樣性?
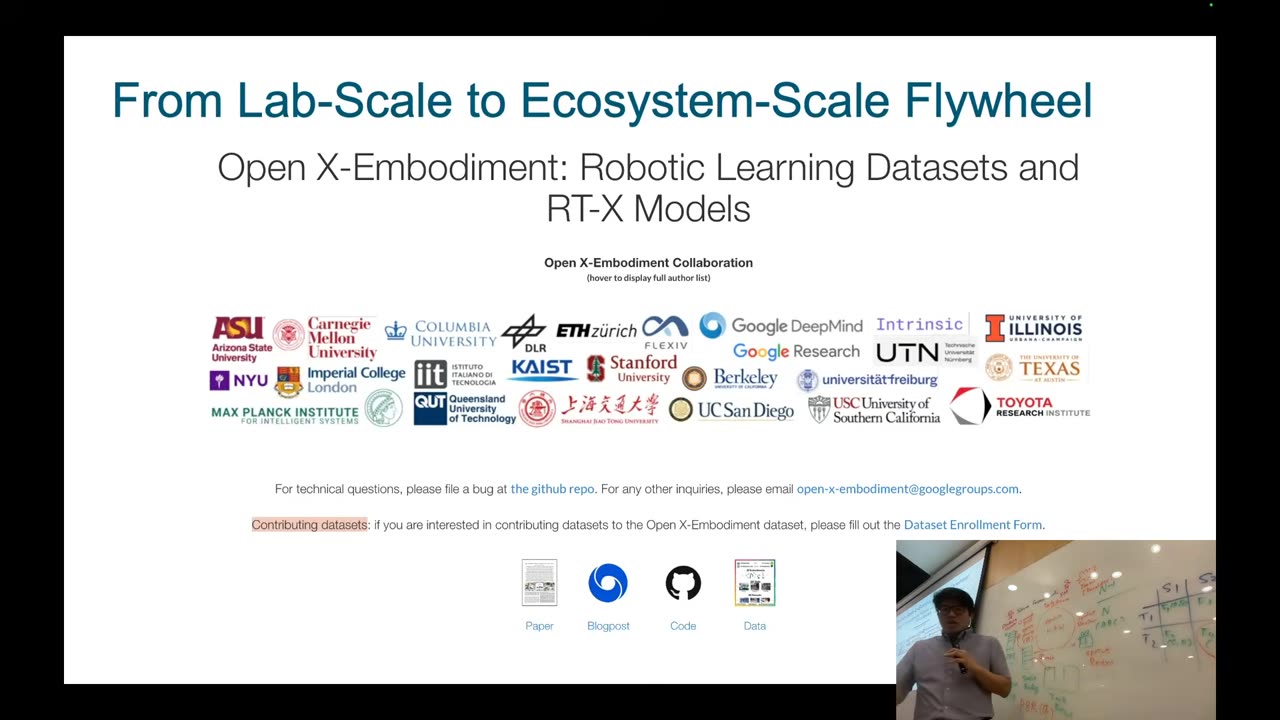
跨機器人資料集能提高 coverage,讓模型接觸更多 embodiment 與任務。但資料格式、動作空間、感測器、任務定義與品質不一致,仍需要標準化與評估來判斷真正價值。
總結:資料飛輪要回答「系統下一步該經歷什麼?」
看老師講解(Part 2 · 50:00)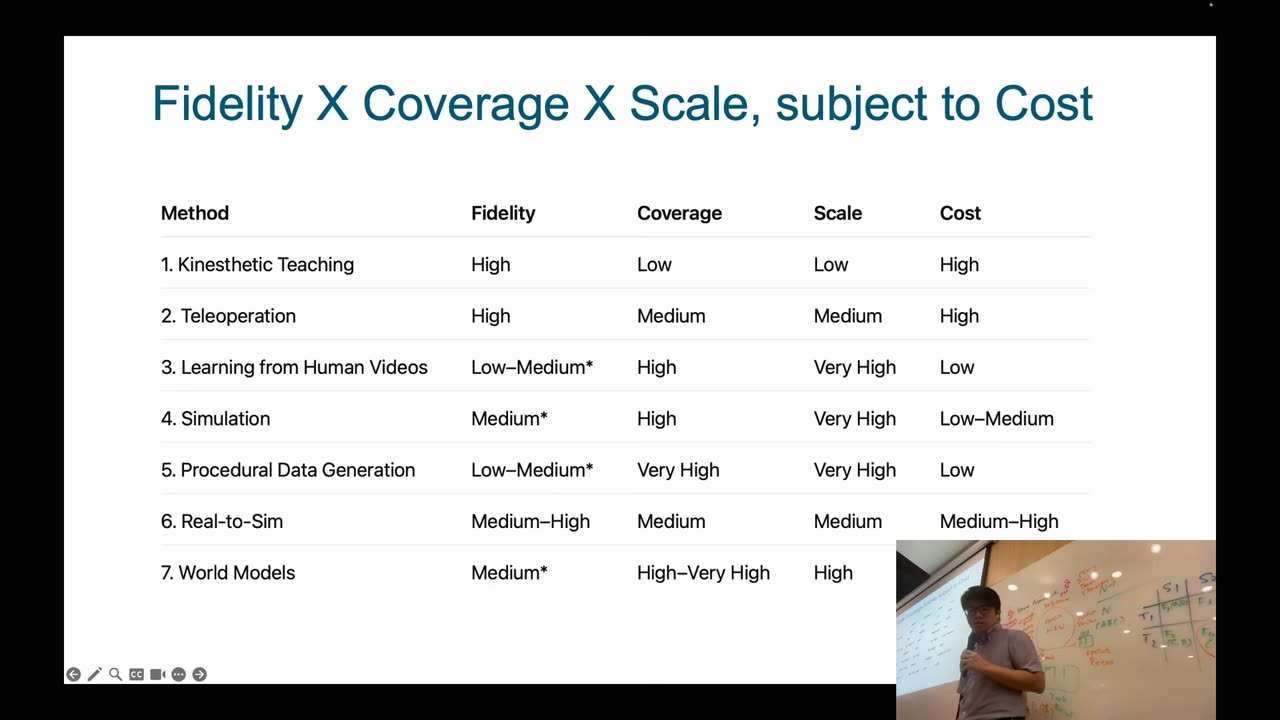
講者把所有策略放回同一個取捨框架:擬真度、涵蓋度、規模,並受成本限制。真實資料擬真度高但昂貴;模擬與生成可擴展但可能失真;影片規模大但後處理困難;world model 可想像未來狀態,但訓練成本與可靠性都是挑戰。
複習與理解檢核
這一講要能回答的不是「有哪些資料來源」,而是「系統下一步最值得經歷什麼」。先自行作答,再用檢核確認推理是否完整。
一、三層資料思維
- 「資料量、資料涵蓋度、資料價值」三層問題有何不同?為什麼資料量最大的不一定最好?
- 比較一次性的 dataset pipeline 與 data flywheel;飛輪多了哪兩個關鍵步驟?
- 什麼是 capability gap?它和一次測試失敗有何不同?
- 為什麼 generalization 可以被視為 coverage problem?
作答檢核
- 量問有多少,涵蓋度問包含哪些條件,價值問哪筆最能改善能力;大量重複資料可能不補任何缺口。
- 一次性流程是經驗→資料→學習→部署;飛輪加入評估與辨識能力缺口,再回頭取得針對性經驗。
- 單次失敗是現象;能力缺口是跨案例分析後定位出的系統性不足,可指導下一步資料或設計。
- 系統能否泛化取決於訓練經驗是否涵蓋部署時重要的變化及其組合。
二、涵蓋度與取捨
- 用物件 × 任務 × 環境 × embodiment 解釋組合爆炸。100 × 20 × 20 × 5 的例子為何不能靠窮舉解決?
- 如果資料新增一萬個房間 layout,為什麼不代表整體 coverage 大幅提升?
- 說明 fidelity、coverage、scale、cost 四者的關係。為什麼沒有單一資料來源在所有面向都最佳?
- 評估目標如何幫助你決定應優先擴充哪個 coverage 維度?
作答檢核
- 共有 200,000 種組合,維度再增加會乘法成長;真實收集受時間、成本與風險限制,必須挑選。
- 它只擴充環境 layout,可能沒有新增物件、任務、動態互動或機器人本體的變化。
- 真實資料擬真但昂貴;模擬/生成可擴展卻可能失真;影片規模大但缺少可直接使用的動作與接觸訊號。
- 應從應用中最重要、最常失敗或風險最高的條件反推,而非平均分配資料預算。
三、資料取得策略
- 比較 kinesthetic teaching 與 teleoperation:資料擬真度、操作者體驗、規模與可能偏差各有什麼差異?
- 從網路影片學習為何同時具有巨大規模與巨大後處理難度?請談 embodiment gap 與缺少的訊號。
- 模擬最適合補哪些缺口?遇到柔性物體、液體或精細接觸時,為什麼要特別小心?
- 程序生成或 LLM 產生很多表面不同的場景,為什麼可能只增加「看起來多樣」而沒有增加能力?
- Open X-Embodiment 類跨機器人資料能帶來什麼,又會產生哪些標準化問題?
作答檢核
- 直接牽引接近真實控制但慢且昂貴;遙操作較易擴展,卻受介面、視角與缺乏觸覺回饋影響。
- 影片數量龐大,但人手和機器手不同,且通常缺少力覺、接觸、精確狀態與機器人動作標籤。
- 適合可控制地擴充環境、物件與罕見條件;複雜物理若模型不準會造成 sim-to-real gap。
- 若生成變化和實際失敗無關,或不改變必要的物理與行為條件,就沒有補到 capability gap。
- 可共享任務與本體經驗;但感測器、資料格式、動作空間、品質與任務定義不一致。
四、飛輪情境題
- 抓取系統在白色馬克杯上成功、透明杯上常失敗。請從評估、缺口定位、資料來源選擇到再驗證,設計一輪資料飛輪。
- 模擬中有一百萬筆資料,真實世界只有一千筆。你不能只憑數量選擇;還需要檢查哪些證據?
- 請替一個你熟悉的 Physical AI 應用回答:What should the system experience next? 並證明這筆經驗比隨機多收資料更有價值。
作答檢核
- 應先把透明/反光材質辨識為缺口,選擇能保留光學與接觸特性的收集方式,加入材質變化,並在獨立條件下比較再訓練前後。
- 需看與部署分布的關聯、物理擬真、條件涵蓋、標註與感測品質、重複性、sim-to-real 落差及下游成效。
- 答案必須由明確失敗或風險證據推出特定經驗,說明資料來源與成本,再定義如何驗證缺口真的縮小。
五、最終口述挑戰
- 用兩分鐘解釋「更多資料」與「更對的資料」的差別,並完整串起 Experience → Data → Learning → Deployment → Evaluate → Identify Capability Gaps → Experience。
通過標準
不只背出流程,還能說明評估如何把部署失敗轉成可操作的缺口,以及缺口如何決定資料的條件、來源與再驗證方式。
內容整理自本專案 Lecture 3 兩段影片與本機 Whisper 逐字稿;投影片截圖取自同一課程影片。繁中字幕已由本機模型翻譯並通過格式驗證,正式公開前仍建議人工複核專有名詞與問答片段。