Lecture 4|Physical AI 走向真實世界部署
本講核心:一段漂亮的 demo 只證明「能力」,真實世界部署需要的是「在特定範圍內的可靠度」。自駕車花了將近百年、經歷 DARPA 挑戰賽、LiDAR、大型資料集與大規模模擬,至今仍未普及;Physical AI 要部署,必須先定義系統預期運作的條件(ODD),接受失敗一定會發生,並設計偵測、恢復與持續學習的機制。
- Demo 是剪輯過、受控的展示;部署要面對淹水、多車互卡、突然跌倒的騎士這類沒有排練的情境。
- 自駕系統是 sense–plan–act:感測器與高精地圖 → 感知 → 預測 → 規劃 → 控制,背後還有同步、校正與整套基礎設施。
- 平均表現不等於安全:失敗率不等於風險,風險 = 暴露度 × 嚴重度 × 可控度(ISO 26262)。
- 部署前無法窮舉所有情境,所以要用 ODD 明確寫下「系統在哪些條件下運作」,並在超出邊界時啟動備援。
- 部署不是終點,而是學習迴圈的一部分。
從資料飛輪到部署:本講的三個重點
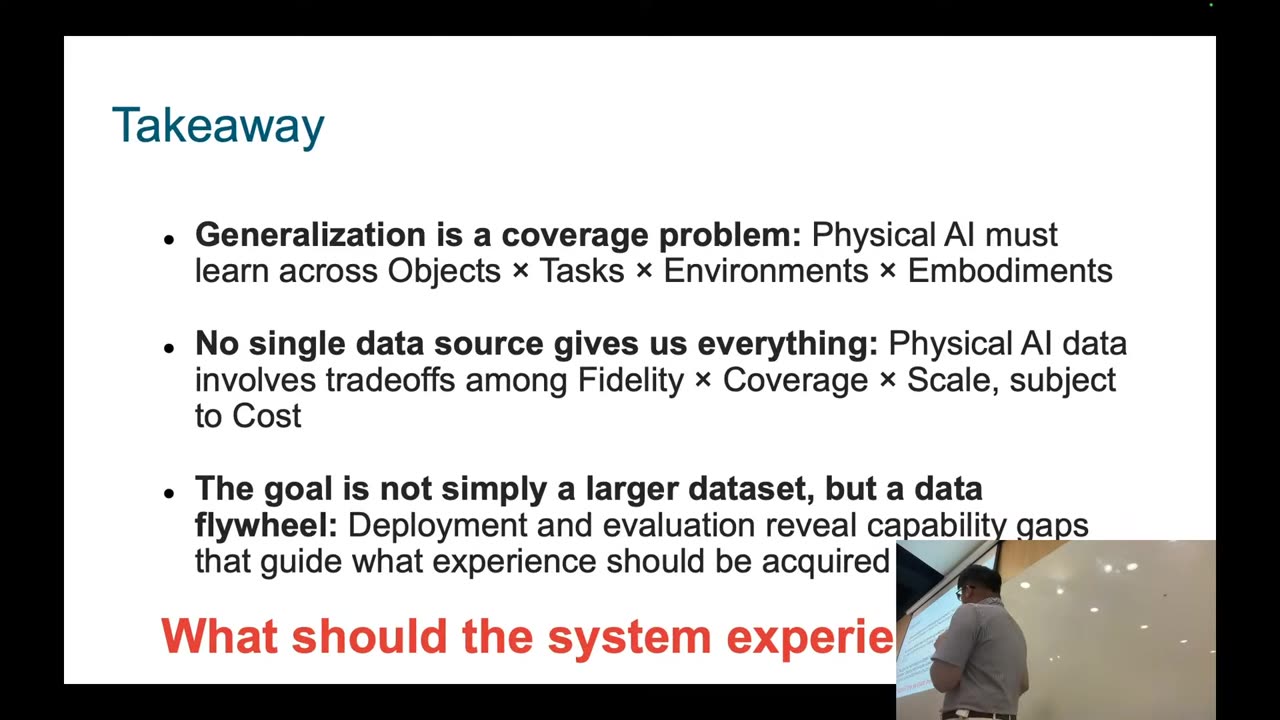
開場先回顧上一講的資料飛輪:資料量只是第一層,更重要的是資料涵蓋度與資料價值;資料集思維停在「收集、訓練、部署」,飛輪思維則補上評估、找出能力缺口、選擇經驗來源,再用不同的資料取得與生成策略產生下一批經驗。上一講留下的問題是:What should the system experience next?
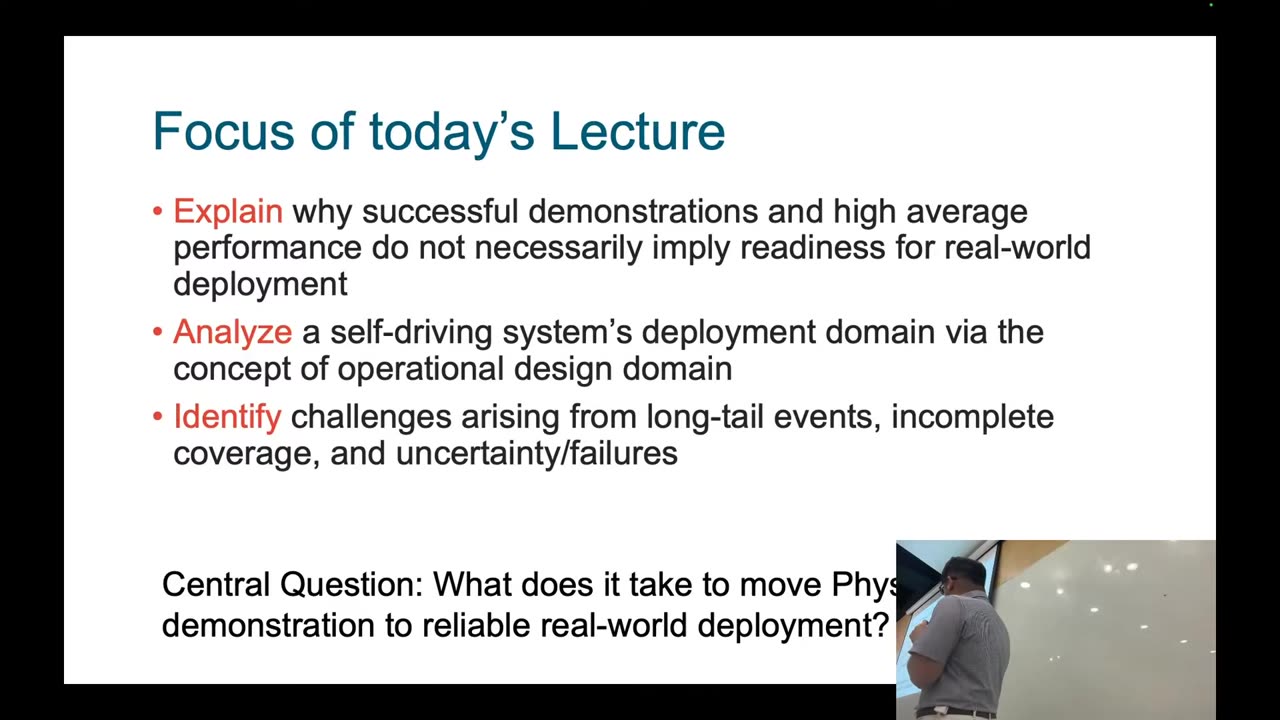
這一講接著問:什麼條件下,Physical AI 才能從 demo 走到可靠的真實世界部署?講者列出三個重點:說明為什麼成功的 demo 與高平均表現不代表可以部署;透過運行設計範圍(operational design domain)分析自駕車的部署範圍;辨識長尾事件、涵蓋度不完整與不確定性帶來的失敗挑戰。
Physical AI 不只是通用機器人:自駕車為什麼還沒普及?
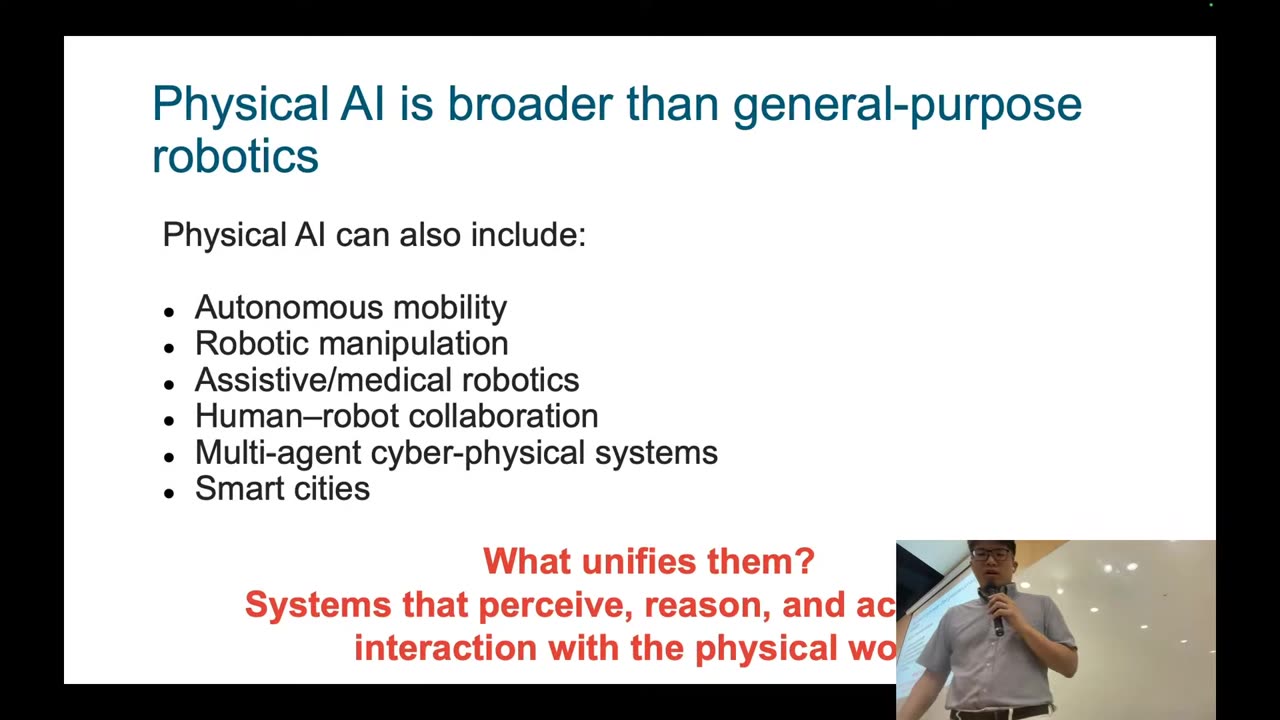
前兩講談了很多做機器人操作的新創,它們的大目標是通用機器人。但講者強調,通用機器人只是 Physical AI 的一個分支;Physical AI 還包括自主移動、醫療機器人、人機協作、多 agent 的虛實整合系統,甚至智慧城市——只要是能透過與物理世界互動來感知、推理與行動的系統都算。
自駕車是發展最久的一條線,因此成了本講的案例。講者丟出一個大問題:如果自駕車已經發展了幾十年,為什麼它們沒有像手機一樣到處都是?說它們「不夠可靠」很容易,但接下來一定要追問:不可靠是什麼意思?我們怎麼知道?
Demo ≠ 部署:Waymo 的亮點與另一面
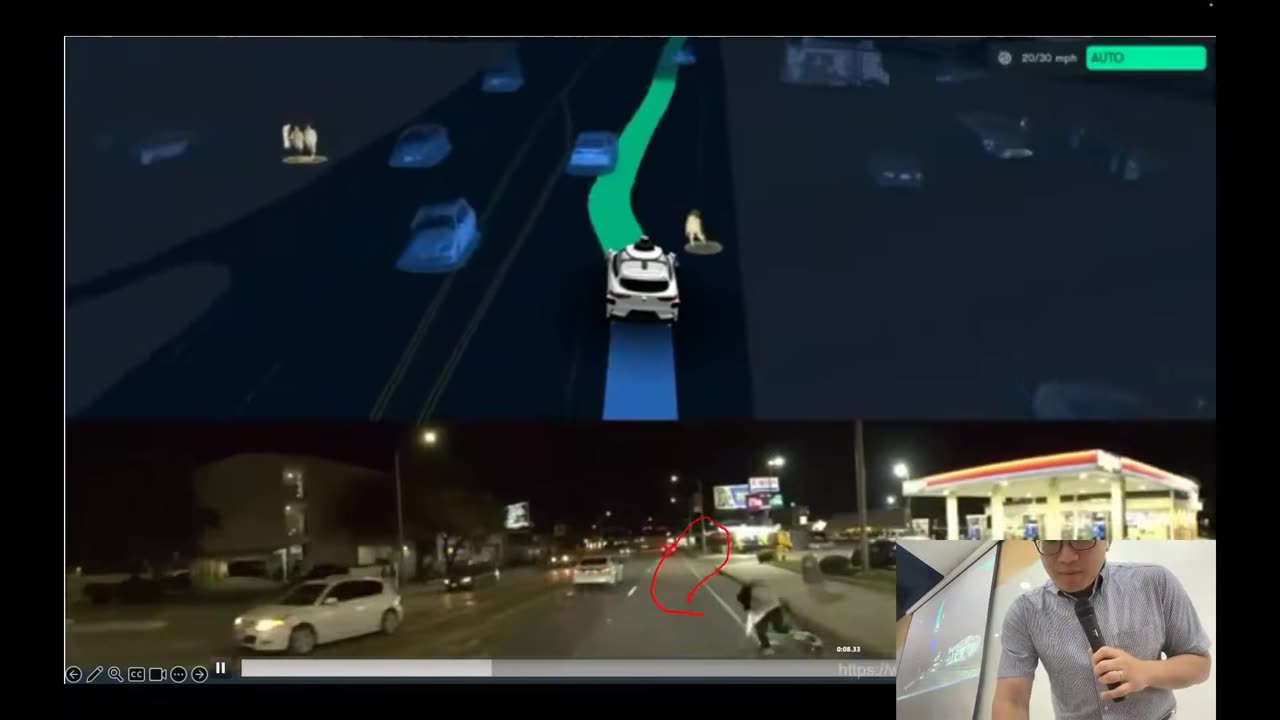
講者先播 Waymo 的 360° 體驗影片:車輛用 LiDAR 與攝影機建立周遭 360° 的畫面,辨識紅綠燈、行人與自行車騎士,預測他們未來的軌跡,再決定自己要減速、等待還是通過。另外兩段真實道路影片更驚人:前方騎士突然跌倒,Waymo 立刻判斷周邊車輛與騎士位置,往旁邊閃避,避免了一場事故。
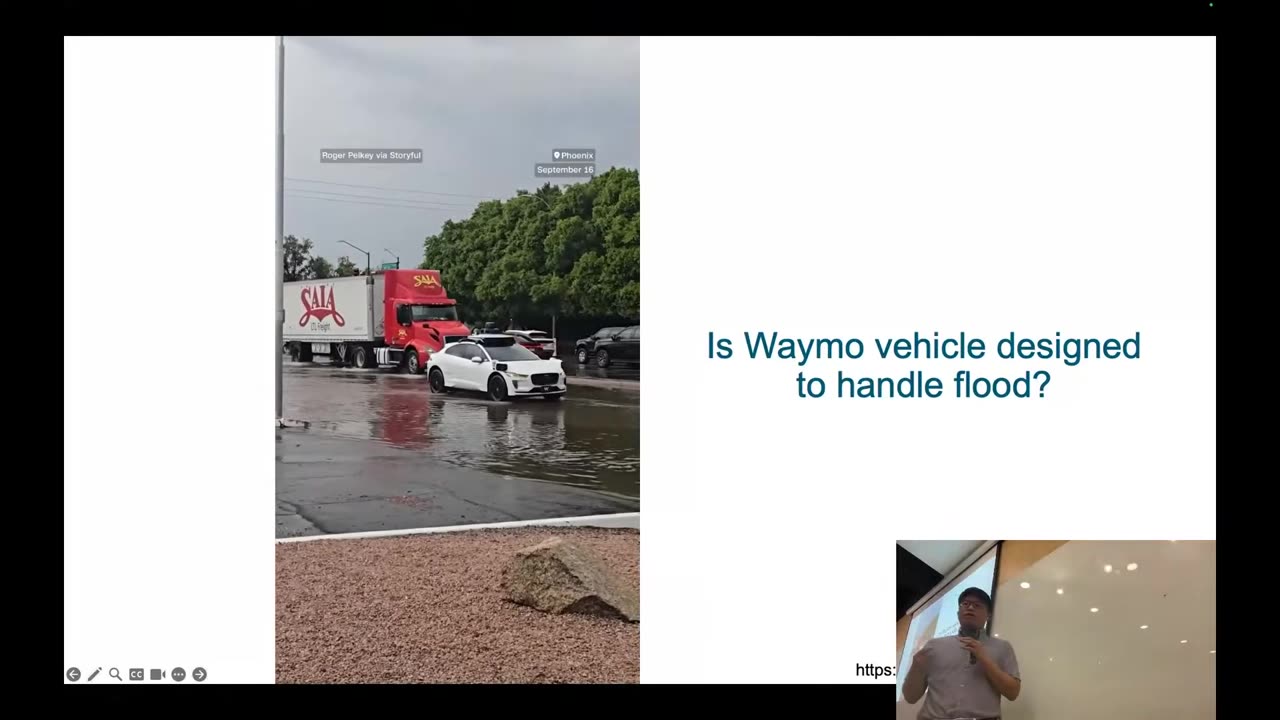
但總有另一面:Waymo 在淹水路段前後來回、卡住後方車流;好幾台 Waymo 在路口互相卡住,只能等人來救援。講者提醒,影片只能讓我們「觀察」到它們在這些情境有困難,不能斷言它們「做不到」;demo 是剪輯過、為了展示能力與爭取投資而發布的片段。
自駕系統架構:sense–plan–act 的具體樣貌
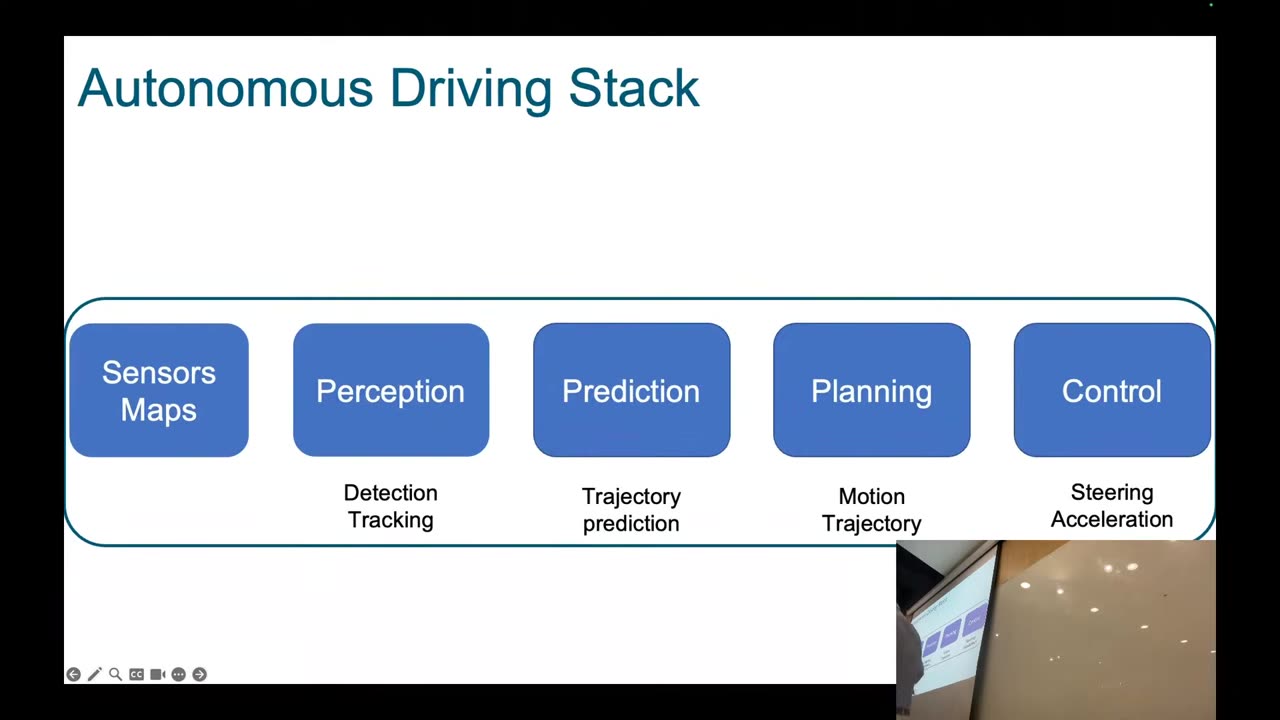
自駕系統由感測器、地圖、感知、預測、規劃與控制組成,正是第一講提過的 sense–plan–act 範式。實驗載具上裝滿攝影機、360° 雷射掃描器(LiDAR)與高精度 GPS/IMU,後車廂還有好幾台電腦負責同步所有訊號,並且必須即時完成感知、預測、規劃與控制。
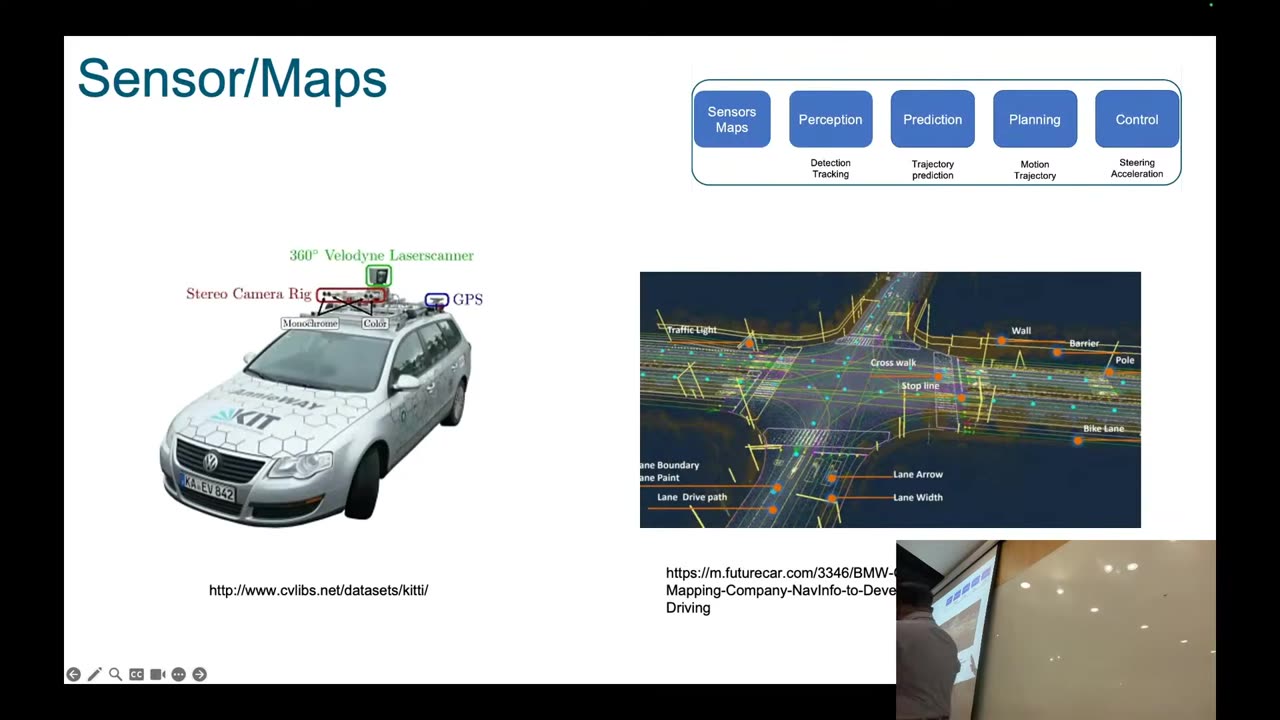
高精地圖(HD map)記錄車道線、雙黃線、地標、到圓環的距離,甚至每條車道能直行還是轉彎。人類開車靠看號誌判斷,自駕車則把這些資訊當成冗餘(redundancy),用來確保安全。
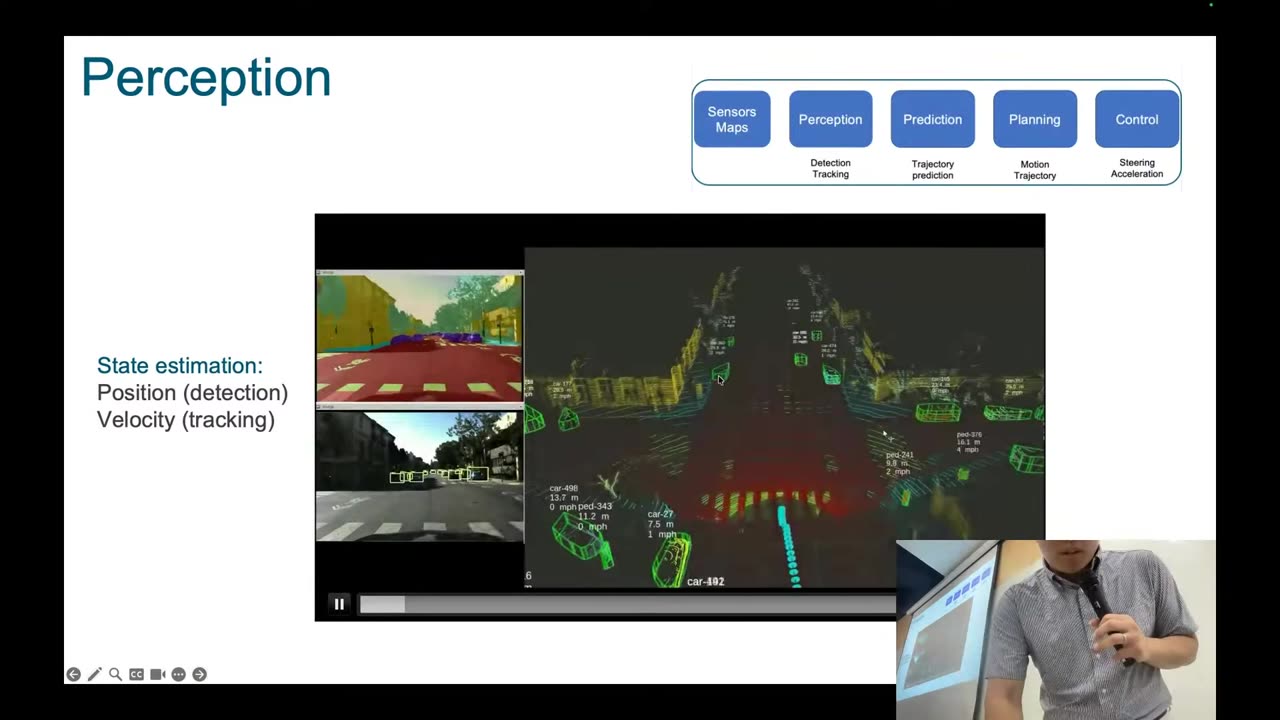
感知估計每個物體的位置與速度(例如行人距離自車 9.3 公尺、時速 3 英里),也辨識人行道與建築物;預測推估每個交通參與者未來可能的位置(在圓環前可能直行也可能轉彎);規劃則根據這些預測決定自車該減速、加速或改變路徑,最後交給控制執行。
自駕車發展史:從 1925 年到 DARPA 挑戰賽
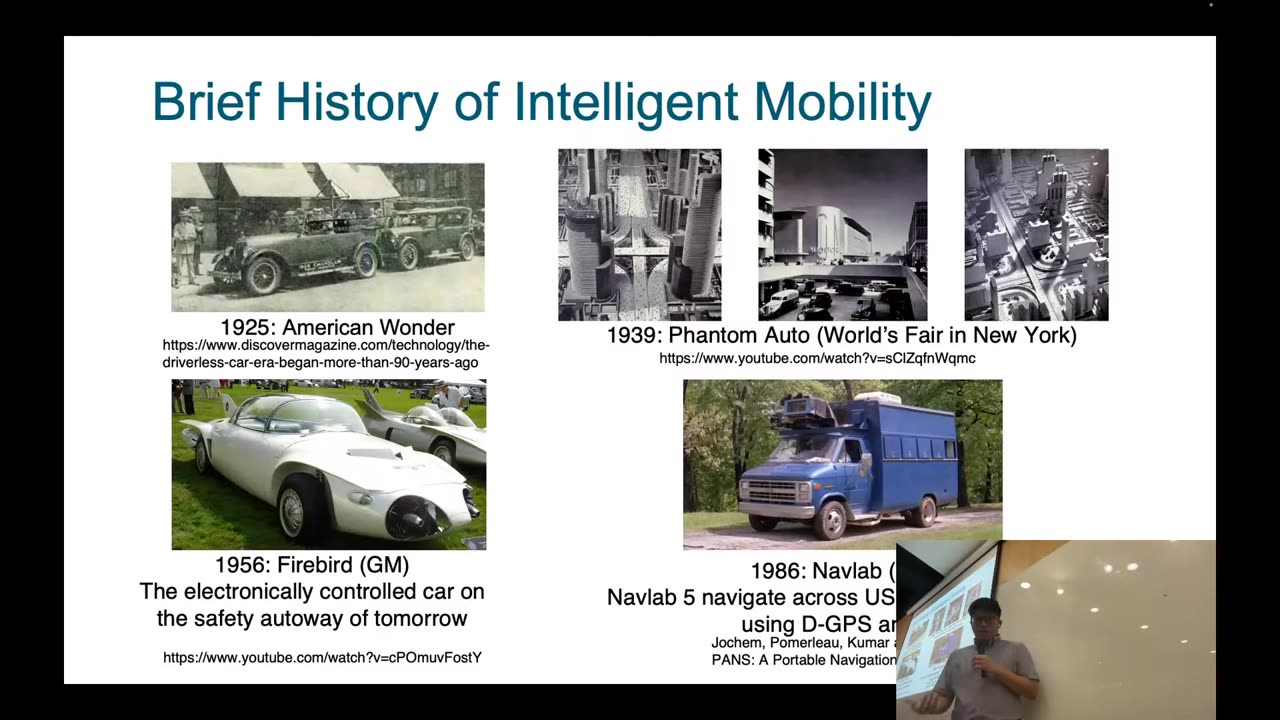
自駕車的想法可以追溯到 1925 年的 American Wonder、1939 年紐約世界博覽會,以及 1956 年 GM 的展示。1986 年起,CMU 的 Navlab 用沉重昂貴的感測器打造實驗車,Navlab 5 以 98% 的自主比例橫越美國。
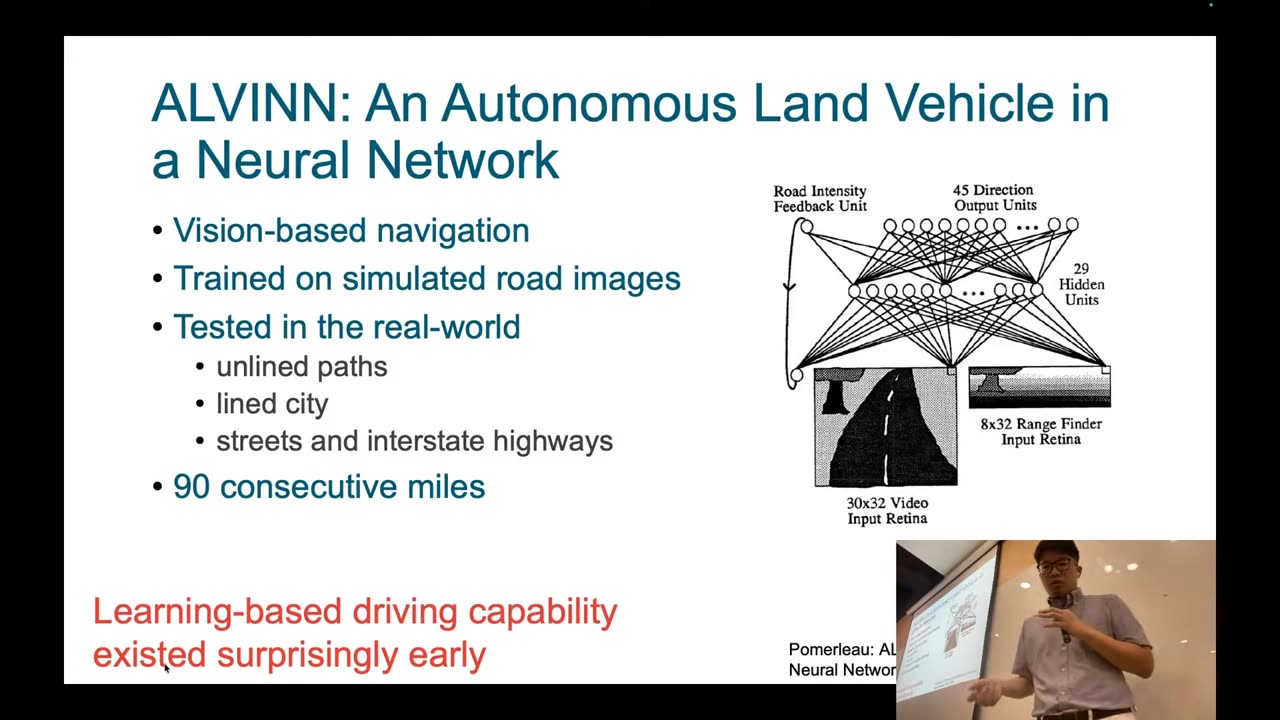
其中特別值得一提的是 ALVINN(Autonomous Land Vehicle In a Neural Network):輸入只有 30×32 的影像與 8×32 的測距資料,用一個兩層的神經網路,在模擬道路影像上訓練、再到真實道路測試,可以連續行駛 90 英里。講者的提醒是:用學習方法控制車輛不是最近才有的想法,只是神經網路曾經被冷落了很長一段時間。
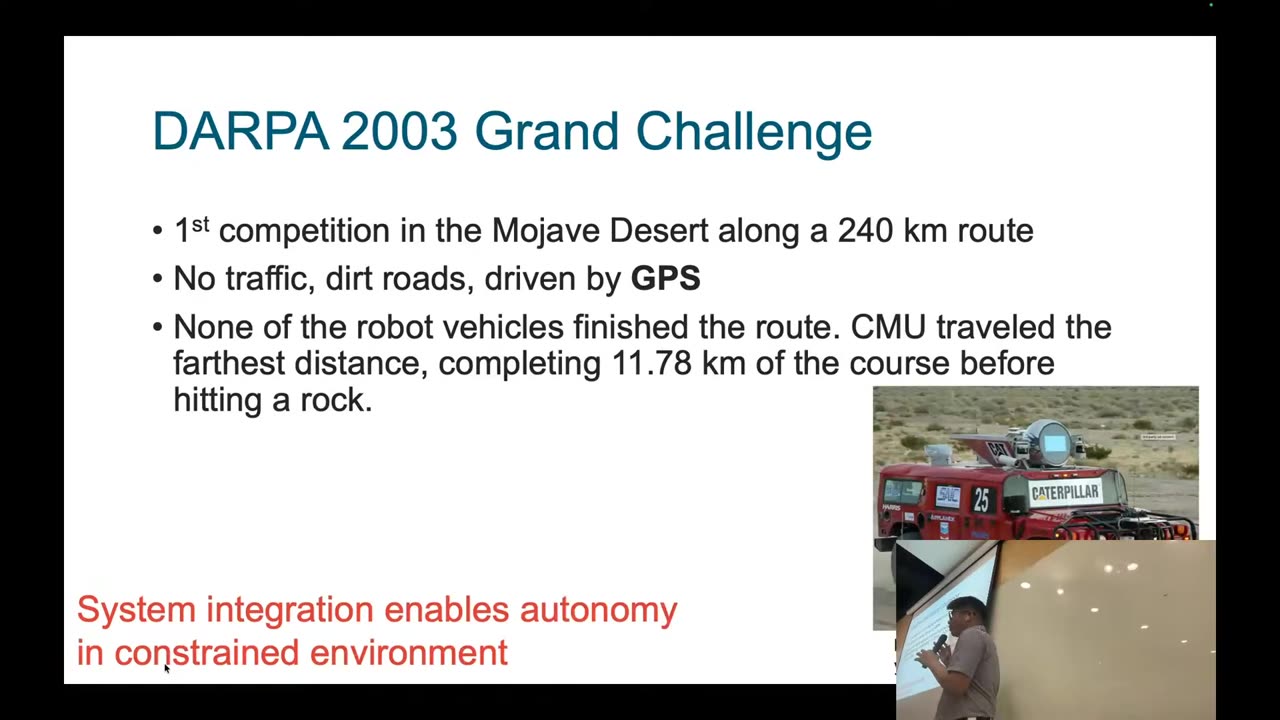
DARPA Grand Challenge(投影片標示為 2003 年,實際比賽於 2004 年舉行)要求車輛自主穿越莫哈維沙漠約 240 公里的路線:沒有車流、走泥土路、靠 GPS 導航。結果沒有任何一台車完賽,走最遠的 CMU 也在 11.78 公里處撞上岩石。精準 GPS+IMU 讓定位精度從約 1 公尺提升到 5 公分等級,是這個階段的關鍵技術;這也是今天手機導航的前身。講者推薦 CMU 團隊負責人 Chris Urmson 的演講,了解 DARPA 為何舉辦這項挑戰(簡短答案:軍事需求)。
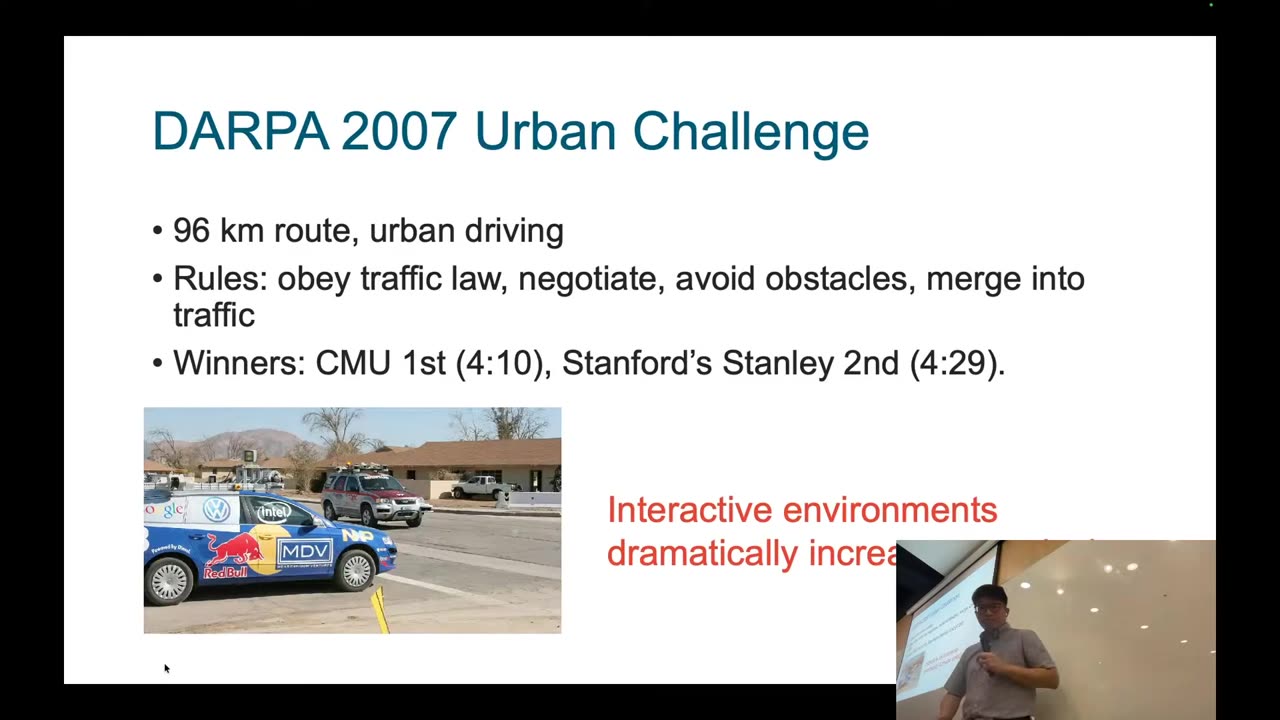
2007 年的 Urban Challenge 換成都市道路:要遵守交通規則、和其他用路人協商、避開障礙、匯入車流。CMU 奪冠、Stanford 第二。和沙漠賽相比,最大的差別是必須處理會動的物體與互動情境,複雜度大幅上升。
LiDAR:主動式 3D 感測與點雲判讀
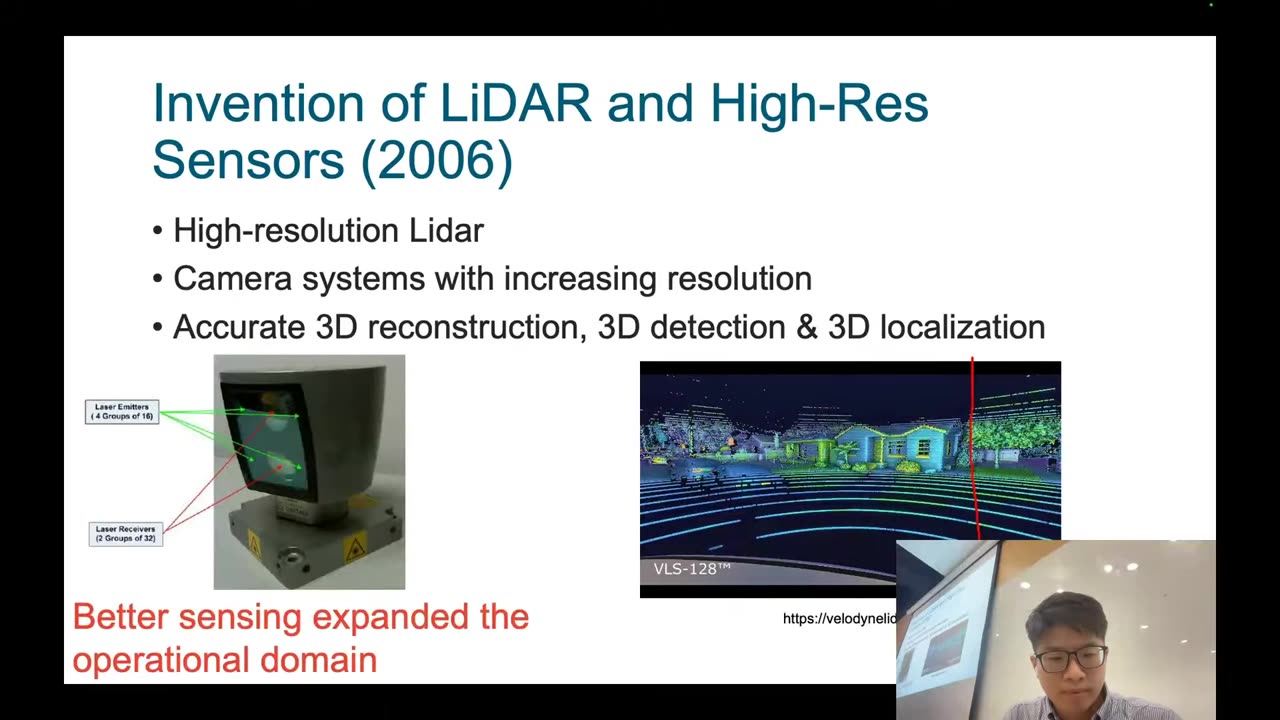
Urban Challenge 時期的關鍵發明是 LiDAR。它是主動式感測器:發射器射出雷射,打到表面反彈回接收器,藉此估計距離;整組元件以 10–20 Hz 旋轉,形成 360° 掃描。128 線代表同一時間射出 128 道雷射;轉得越快,點雲越稀疏。攝影機則是被動式感測器,把 3D 世界投影到 2D 影像,要從影像還原 3D 是 ill-posed 的問題。
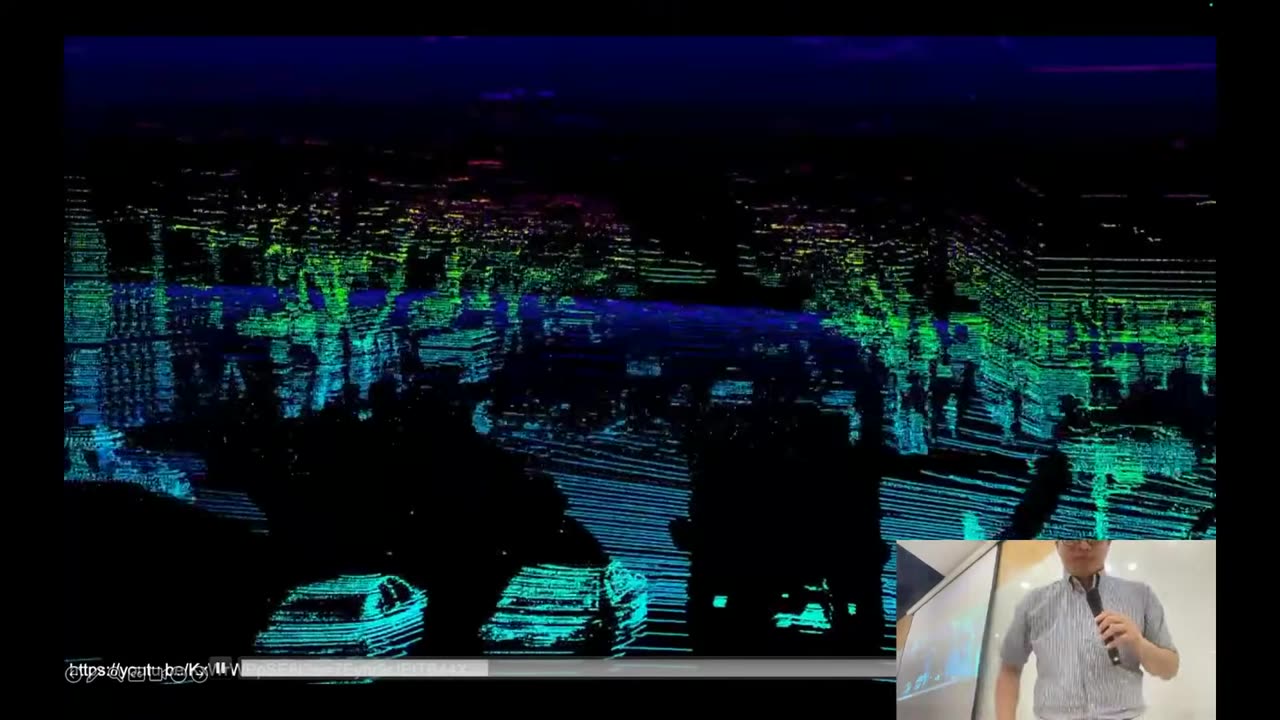
講者帶大家判讀一幀 360° 點雲:前方的卡車、左轉的車、路邊一排樹幹、三位行人、交通錐。前車後方的大片黑色區域,是因為雷射被前車遮蔽;我們也永遠看不到車輛的另一側,除非真的開過去掃描。感測器的擺放角度則取決於目的:要偵測周遭物體就朝前,要做定位就要看得到樹木、建築這類不會動的地標。
LiDAR 也有副作用:第一講那段高速公路影片裡,雷射打到車輪捲起的水花,會在空中形成大量點;如果系統把它們當成障礙物,就可能在高速下緊急煞車。Velodyne 把這類感測器商品化之後,產品越做越小,未來可能像手機鏡頭一樣普及——講者的 iPad 上就有一顆小型 LiDAR。
資料集與產業路線:KITTI、校正、Waabi 與 Tesla vs Waymo
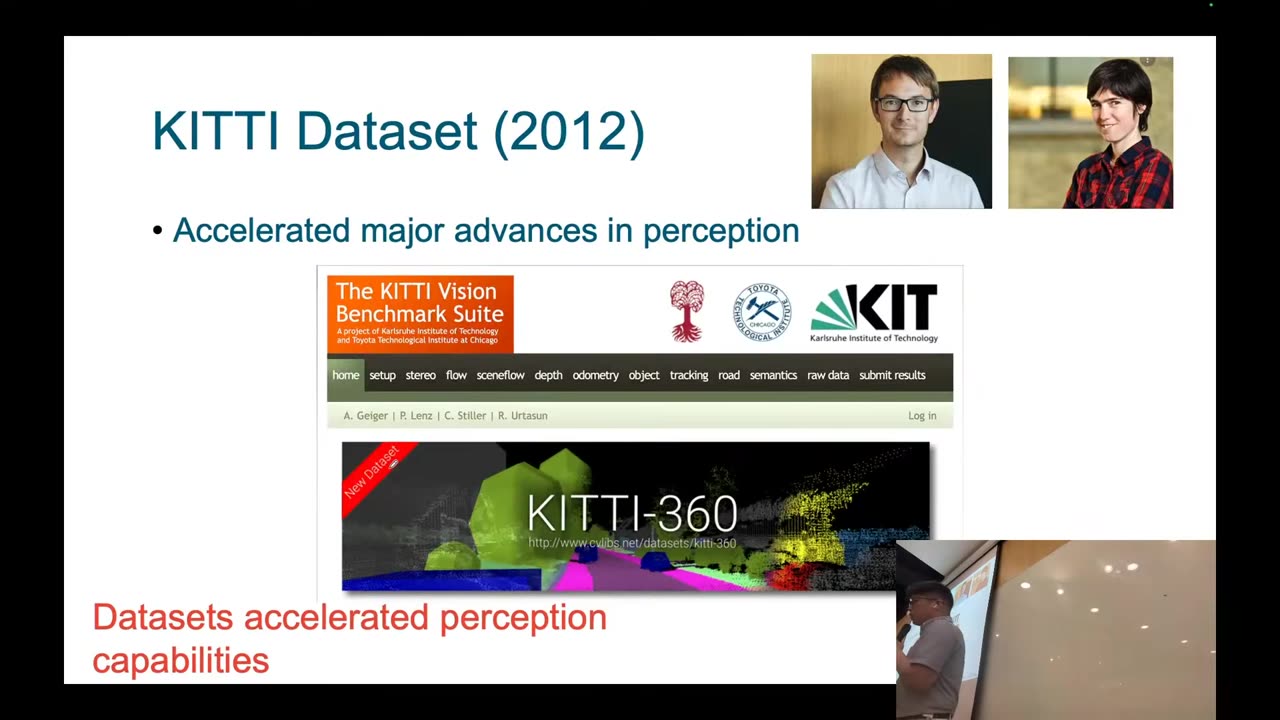
2009 年 Google 把 CMU 與 Stanford 的挑戰賽團隊帶進公司,成立自駕車團隊(Sebastian Thrun 是領導者之一,後來也創辦了 Udacity)。另一條路線是學界的 KITTI:由 Karlsruhe Institute of Technology 與 Toyota Technological Institute at Chicago 合作,Andreas Geiger 與 Raquel Urtasun 主導。他們打造實驗載具、收集並標註資料,建立深度估計、物件偵測、里程計等 benchmark;有很長一段時間,這是學界唯一能下載的交通場景資料集,推動了感知技術的大幅進步。
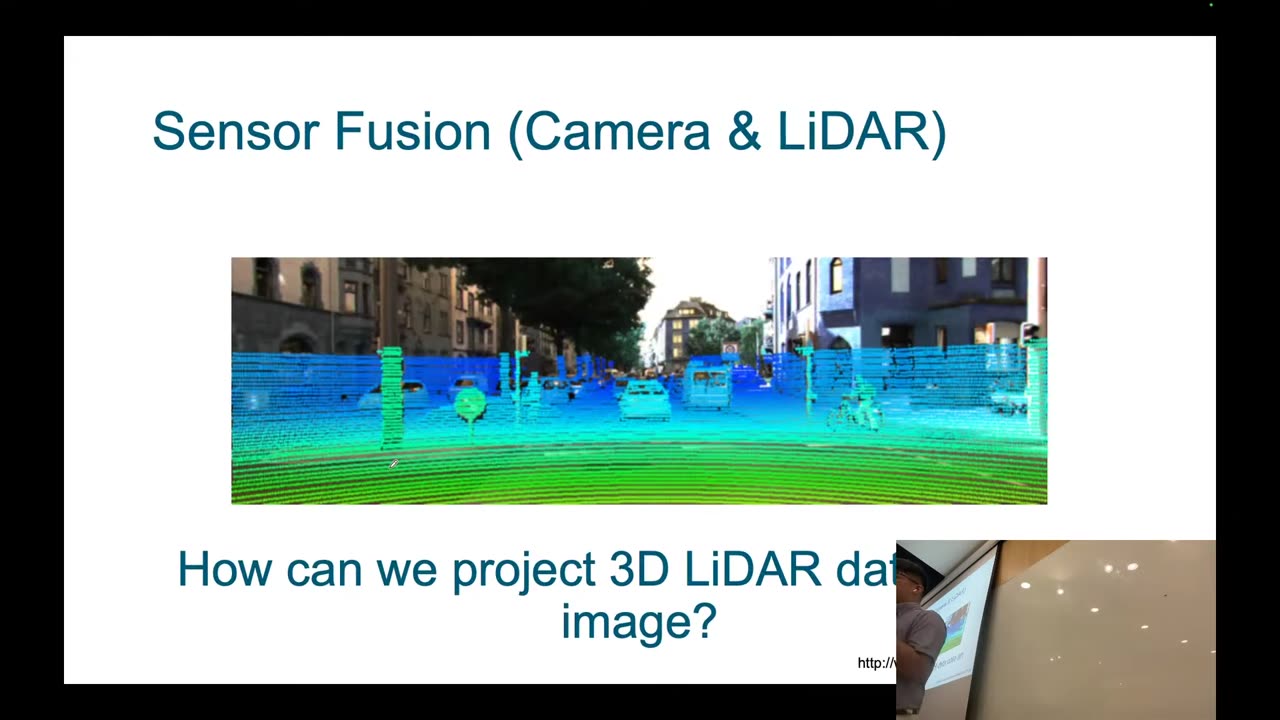
講者特別停下來談感測器融合與校正:攝影機擅長外觀與紋理,LiDAR 擅長 3D,所以大家想結合兩者。但「怎麼把 3D LiDAR 點投影到影像上」並不是已解決的問題——資料集作者已經替你做好,API 一行就能呼叫;一旦你換了 LiDAR 型號、移動了攝影機位置,就得自己面對所有細節。硬體沒弄對,資料就不對,模型也就做不好。
2017 年後,Waymo、nuScenes、Lyft、Apollo、Berkeley、Oxford、Cityscapes 等資料集陸續公開。產業上,Raquel Urtasun 創辦的 Waabi 主攻長途卡車,並用 Waabi World 重建真實場景、在模擬中大量生成罕見情境。Tesla 與 Waymo 則代表兩種路線:Waymo 做 Robotaxi,用昂貴的多感測器車隊;Tesla 賣車,只用 8 顆攝影機,靠數量龐大的客戶車輛收集資料訓練 FSD。哪條路線會勝出,講者說還不知道。
為什麼仍然很難?教訓一:長尾與「失敗率 ≠ 風險」
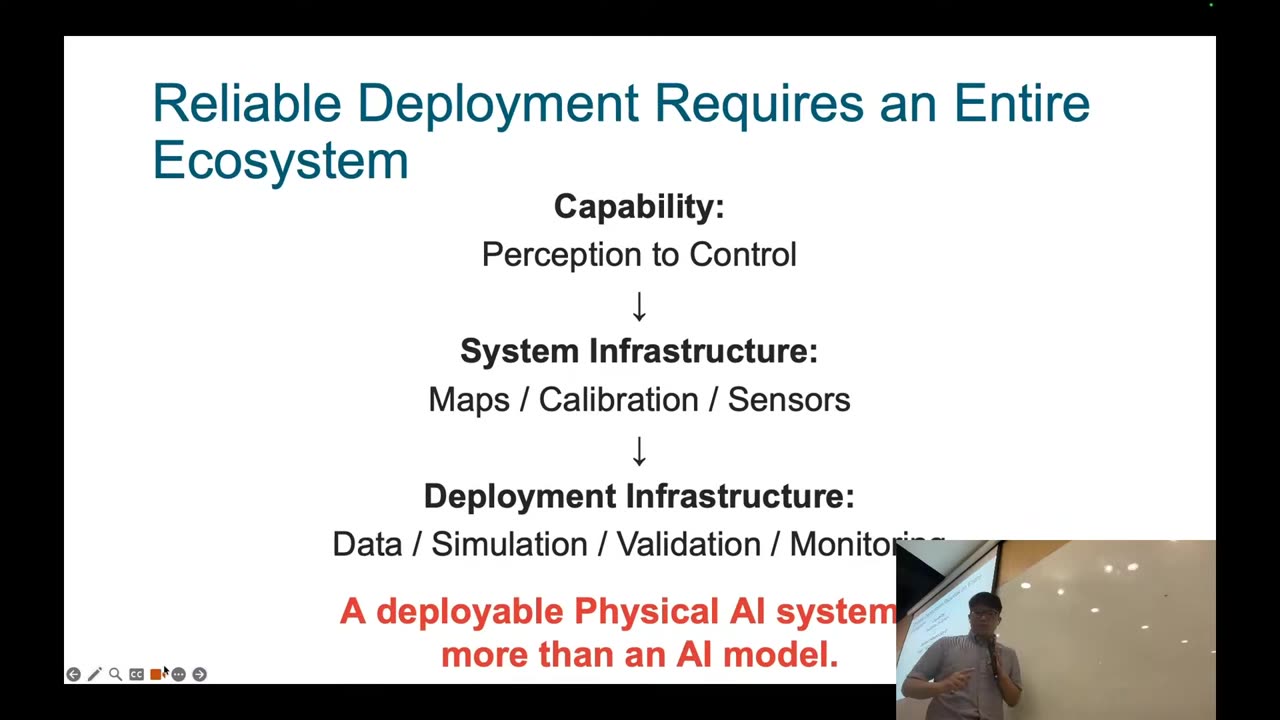
更好的感測、更好的演算法、更多資料、大規模模擬、整個車隊收資料——這些都有了,自駕車仍未普及。原因在於真實世界有太多維度:天氣與光線、結構化與非結構化道路、和行人與其他車輛的互動、長尾事件(像騎士突然跌倒),還有社會與倫理問題。可靠的部署需要整個生態系:從感知到控制的能力、地圖與校正等基礎設施、以及資料、模擬、驗證與監控系統。
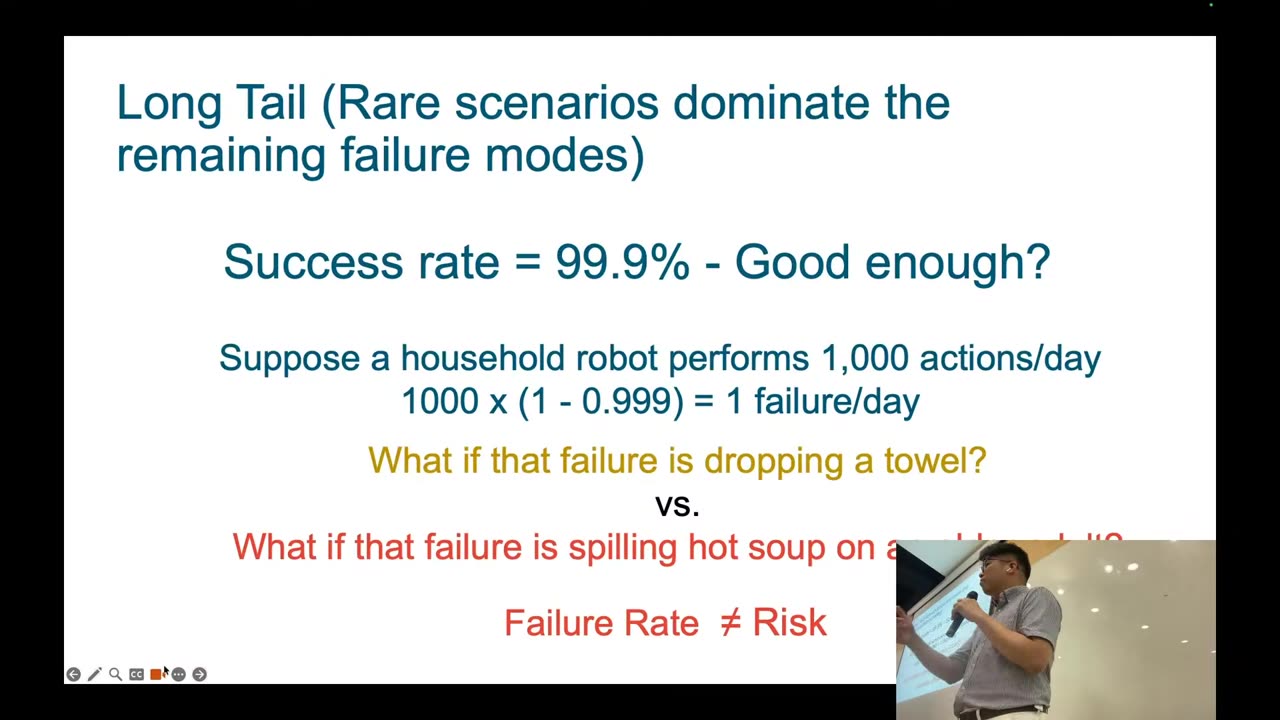
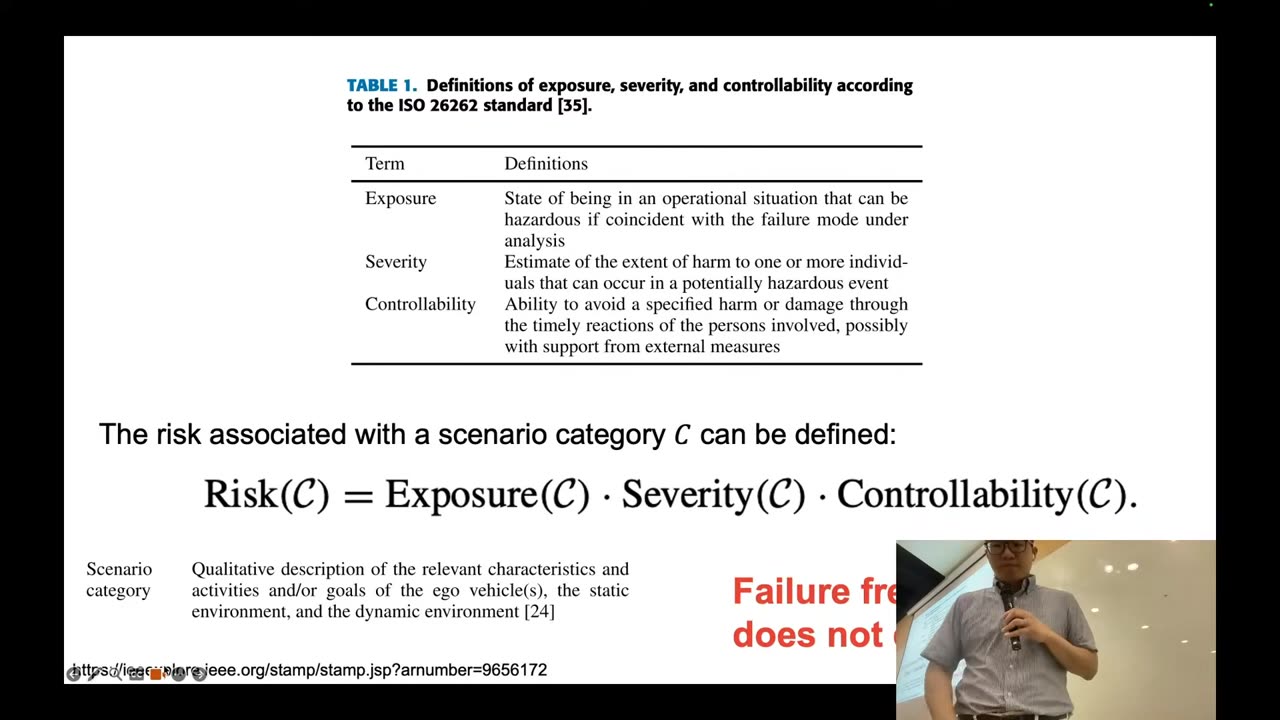
講者用一個例子說明平均表現的陷阱:成功率 99.9% 聽起來很好,但家用機器人一天執行 1000 個動作,就是每天失敗一次。「掉了一條毛巾」和「把熱湯潑到長者身上」都是一次失敗,嚴重程度卻天差地遠。ISO 26262 把風險拆成三個因子:暴露度(多常遇到這種情境)、嚴重度(後果多嚴重)、可控度(能不能控制或安全降級),風險 = 暴露度 × 嚴重度 × 可控度。
教訓二:部署前無法窮舉所有情境——SAE L4 與 L5
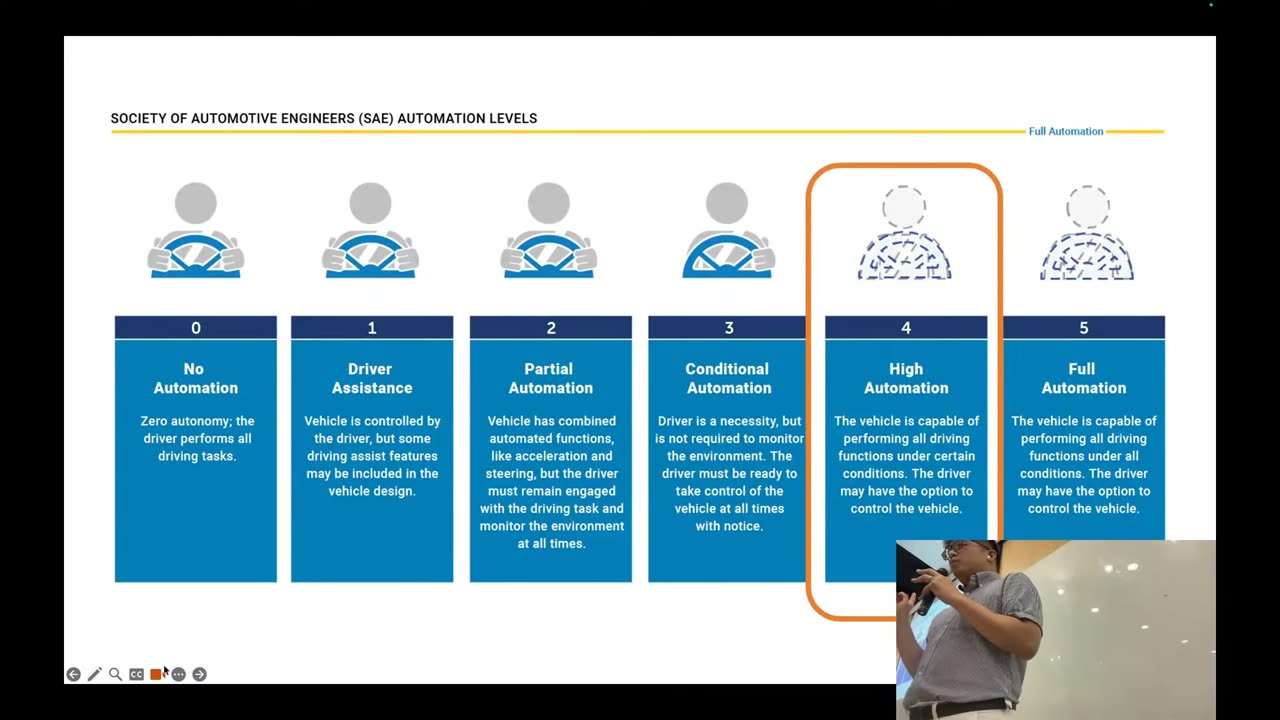
我們能在部署前先經歷淹水、多車互卡這些情境嗎?非常困難。回頭看「Waymo 是否被設計來處理淹水?」這個問題,可以從 SAE 自動駕駛分級找答案:Level 4 是「在特定條件下」能執行所有駕駛功能,Level 5 則是「在所有條件下」。如果 Waymo 宣稱能在舊金山早上 7 點到晚上 9 點的所有條件下運作,那麼淹水與互卡就在它必須處理的範圍內。
問題在於,「特定條件」和「所有條件」都是很模糊的說法。這就帶出下一個概念:要用系統化的方式,寫清楚系統預期處理的條件。
運行設計範圍(ODD)與目標運行範圍(TOD)
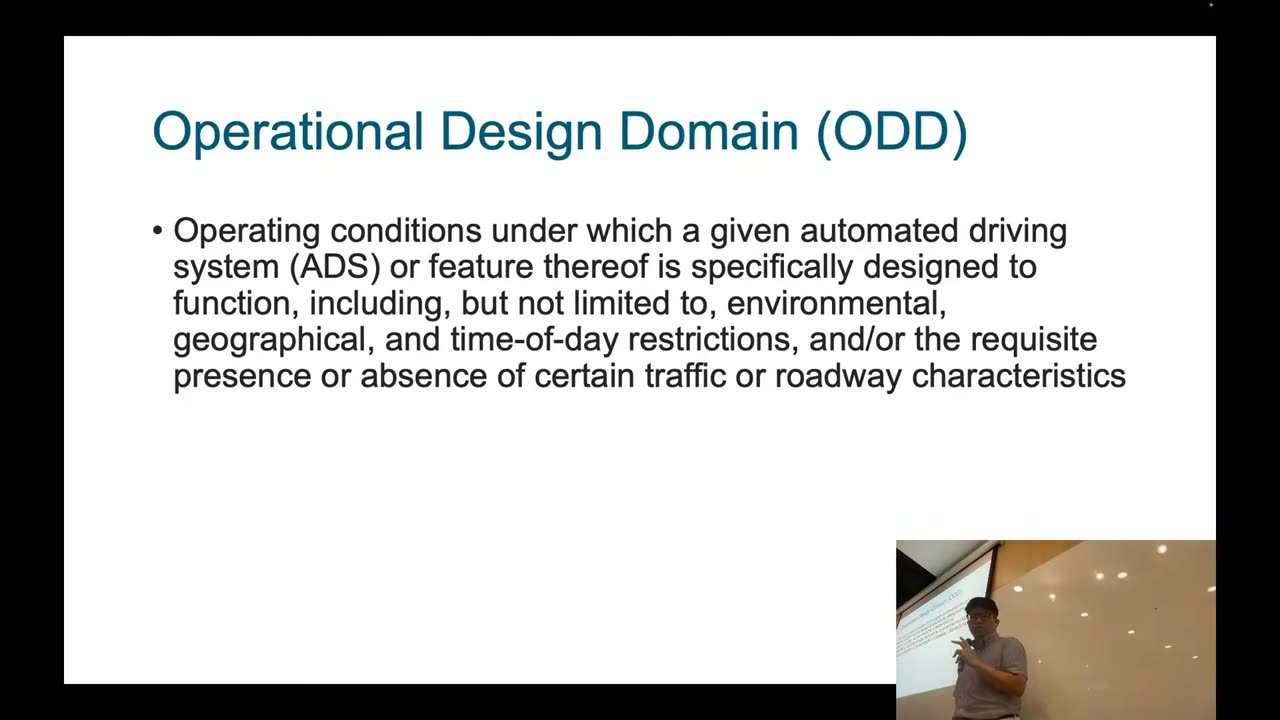
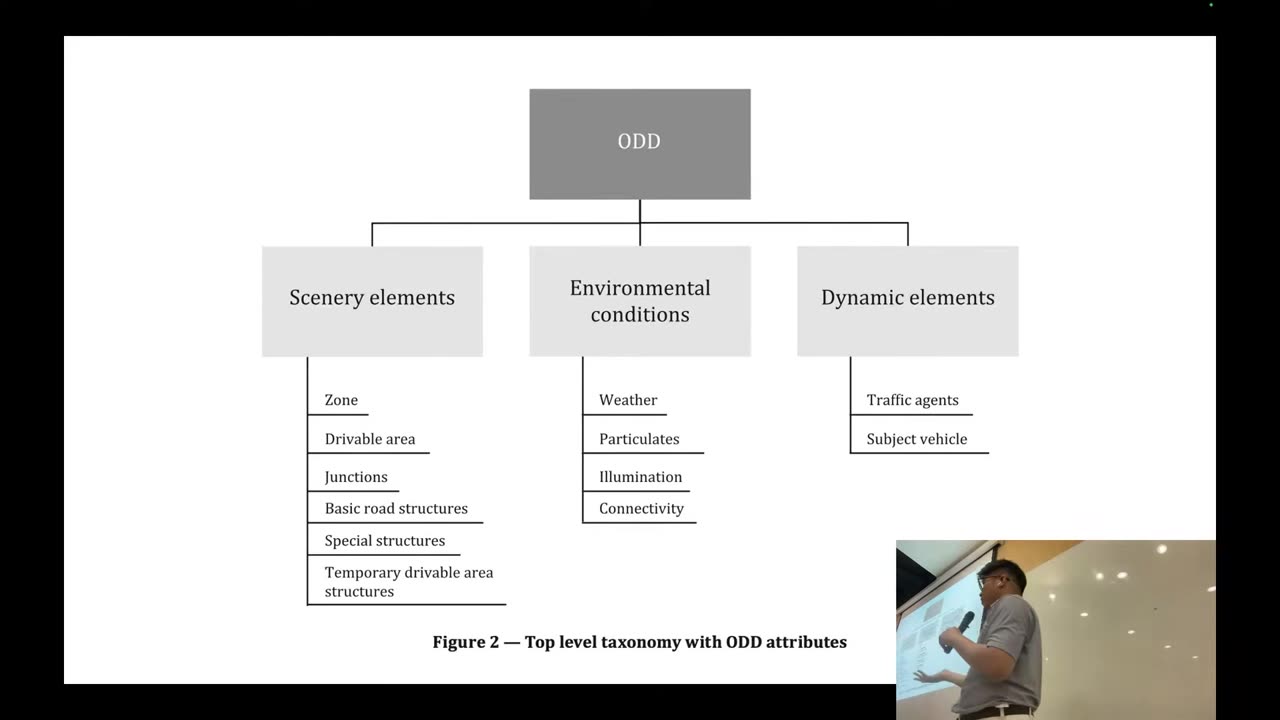
ODD(operational design domain)在 ISO 標準中的定義是:某個自動駕駛系統或功能被設計來運作的條件,包括但不限於環境、地理、時段限制,以及特定交通或道路特徵是否存在。ISO 把它拆成三大類:場景元素(區域、可行駛區域、路口、道路結構)、環境條件(天氣、光照、連線)與動態元素(交通參與者、受測車輛)。一旦寫下「能處理所有路口」,T 字路口、四岔路口、五岔路口都必須能處理;寫下「所有交通參與者」,就包括從沒見過的車種。
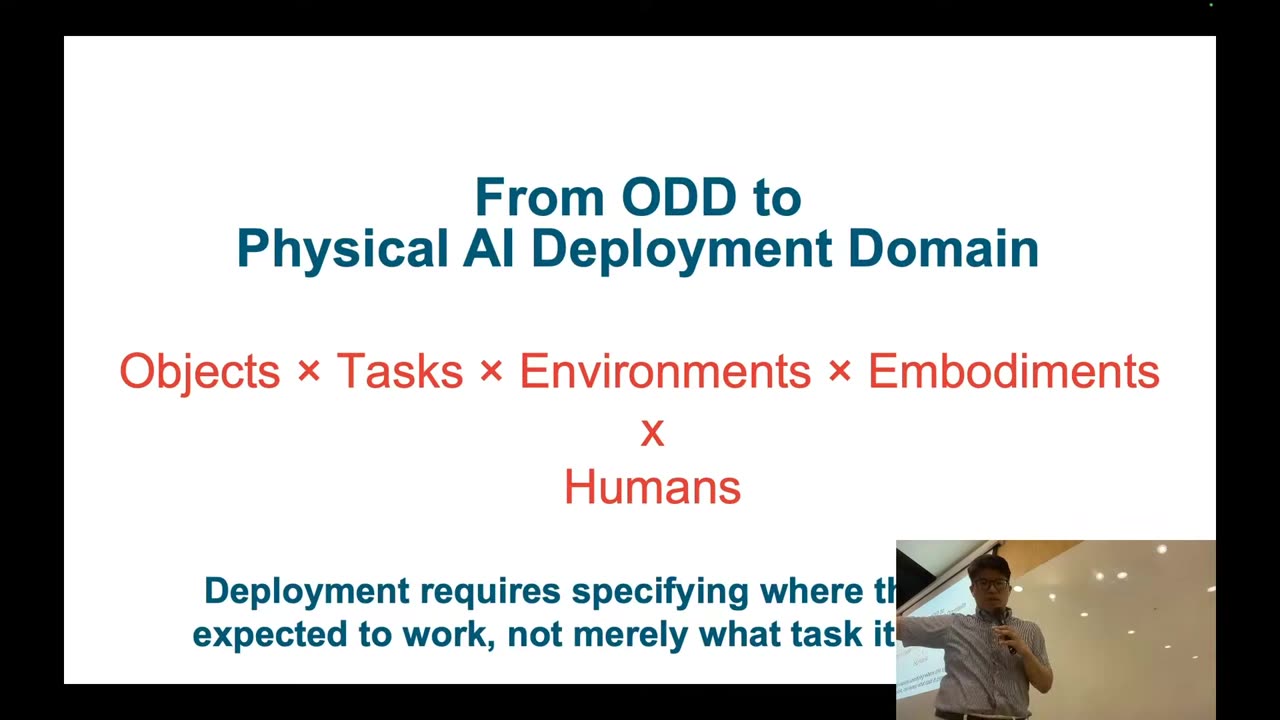
這個概念可以帶進 Physical AI:上一講談的物件、任務、環境、實體形式,再加上要互動的人。但機器人在日常生活中移動與操作,條件會比車道上的駕駛模糊得多;把操作與導航結合起來更是一大步。講者也對照上一講:資料飛輪處理的是「下一筆經驗該收集什麼」的涵蓋度問題,這一講處理的是「系統要在哪裡可靠運作」的部署範圍問題;而部署範圍會反過來引導該收集什麼經驗。
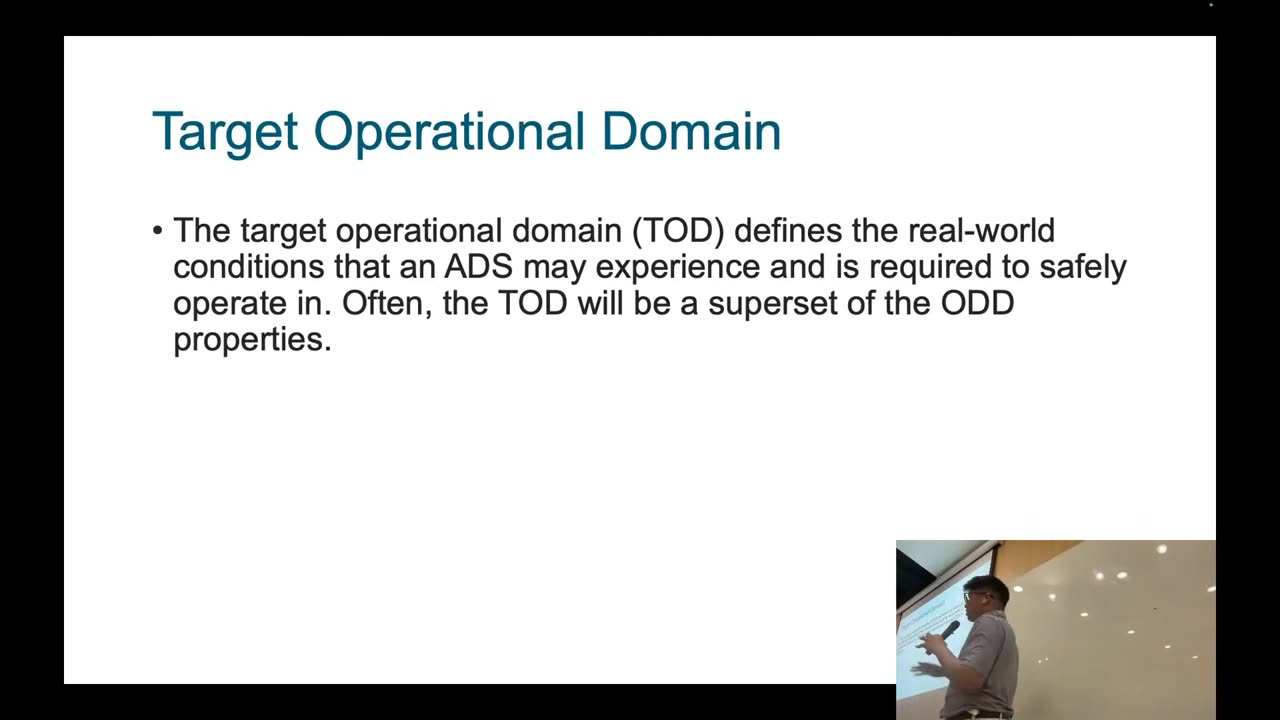
TOD(target operational domain)描述系統部署後實際會遇到、或被要求安全運作的真實世界條件,通常是 ODD 的超集合。訓練分布不等於部署分布:物件狀態、天氣、人都會變,硬體也會老化(像 Dyna Robotics 遇到的磨損問題),部署環境是非穩態的。實務上 ODD 不可能窮舉 TOD 中所有情況,因此 ODD 與 TOD 的邊界必須客觀定義,系統也要能在離開 ODD 時執行備援操作。
教訓三:失敗與不確定性——知道自己不知道
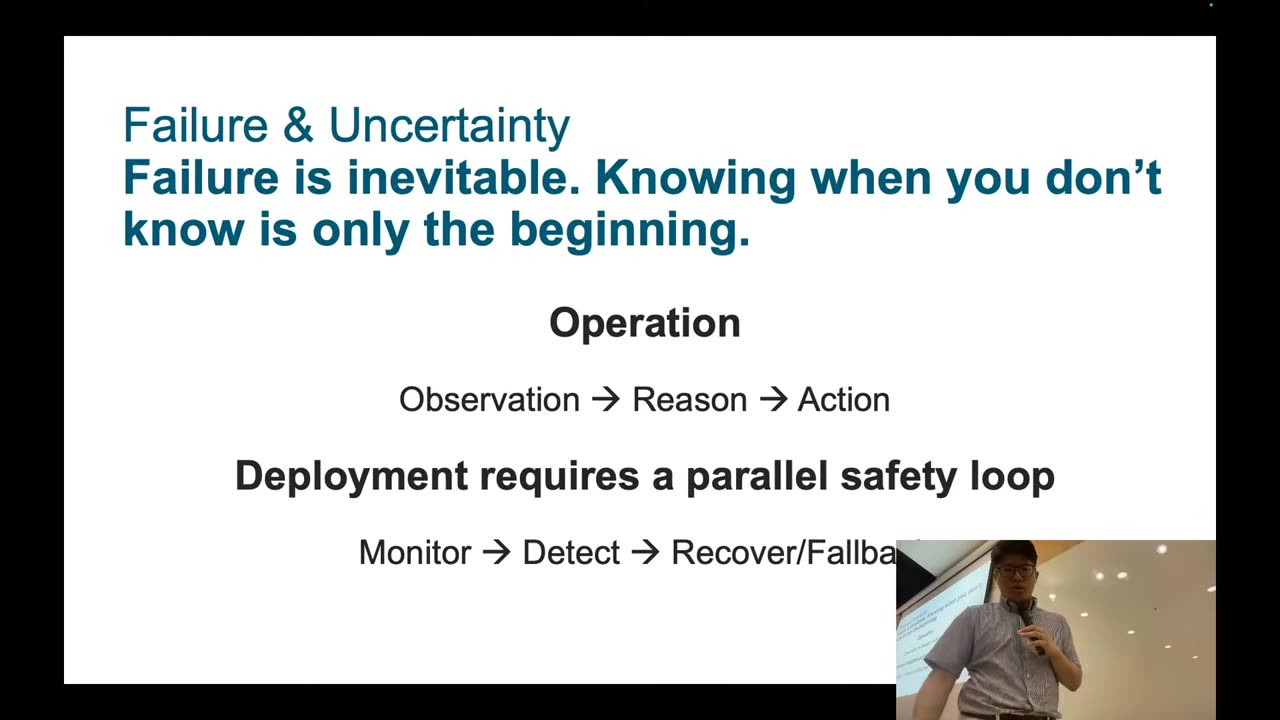
失敗一定會發生,「知道自己什麼時候不知道」只是開始。一般運作是觀察、推理、行動;部署還需要旁邊一條安全迴圈:持續監控自己是否還在設計邊界內,一旦超出就偵測出來,接著自行恢復回邊界內、執行備援,或交給遠端的人類操作員處理。前面 Waymo 互卡的例子,若系統知道自己已經超出邊界,就能立即請求遠端協助;而騎士跌倒那個例子則剛好在 Waymo 的能力邊界內,它成功閃避了。
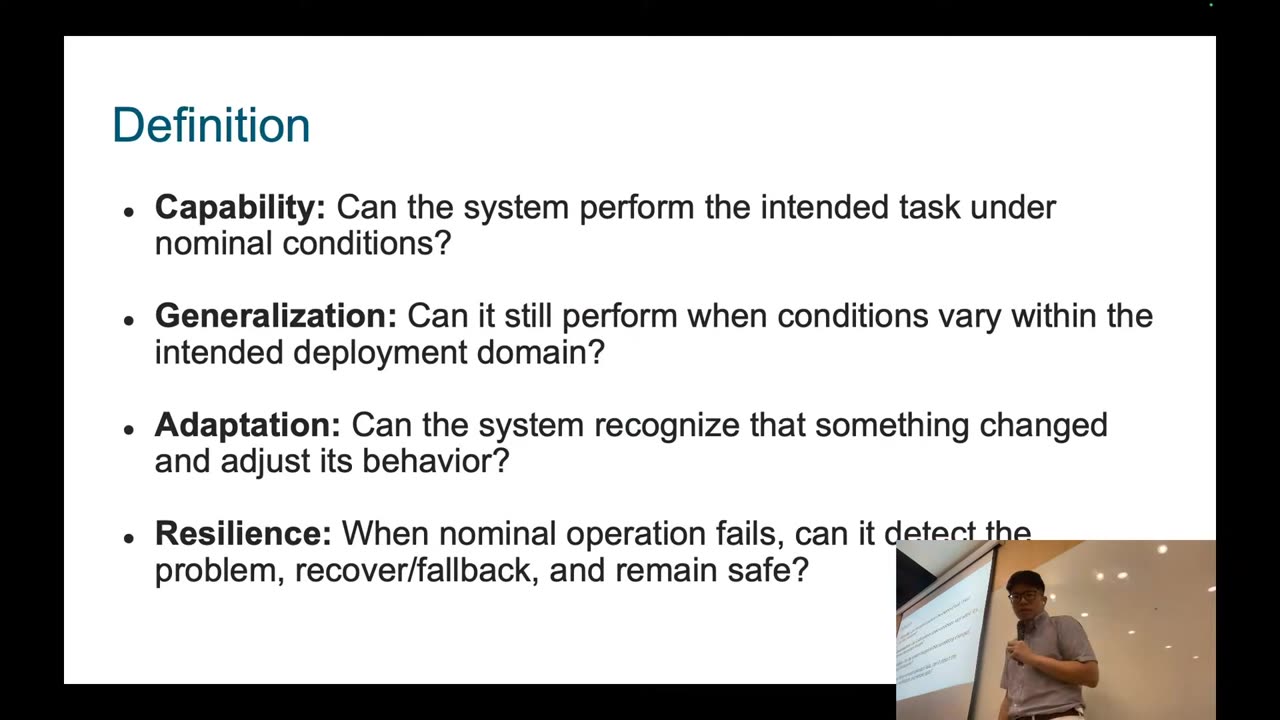
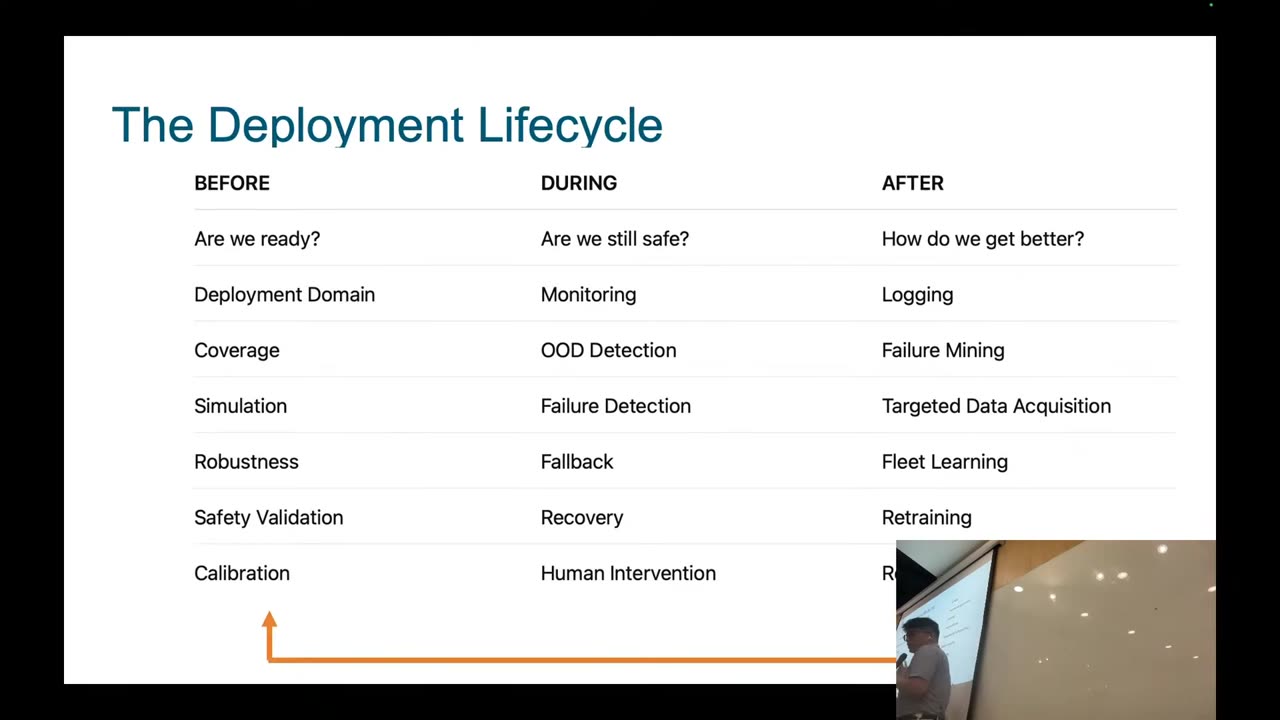
部署要考慮的不只是 AI 模型:能力(能否在標準條件下完成任務)、泛化(條件在部署範圍內變化時是否仍能完成)、適應(能否察覺變化並調整行為)、韌性(正常運作失敗時能否偵測、恢復或備援並保持安全)。整個生命週期分成部署前、部署中、部署後:部署後遇到處理不了的失敗,要回到第一階段——收集更多資料,或重新設計系統,形成一個迴圈。
總結:部署是學習的延續
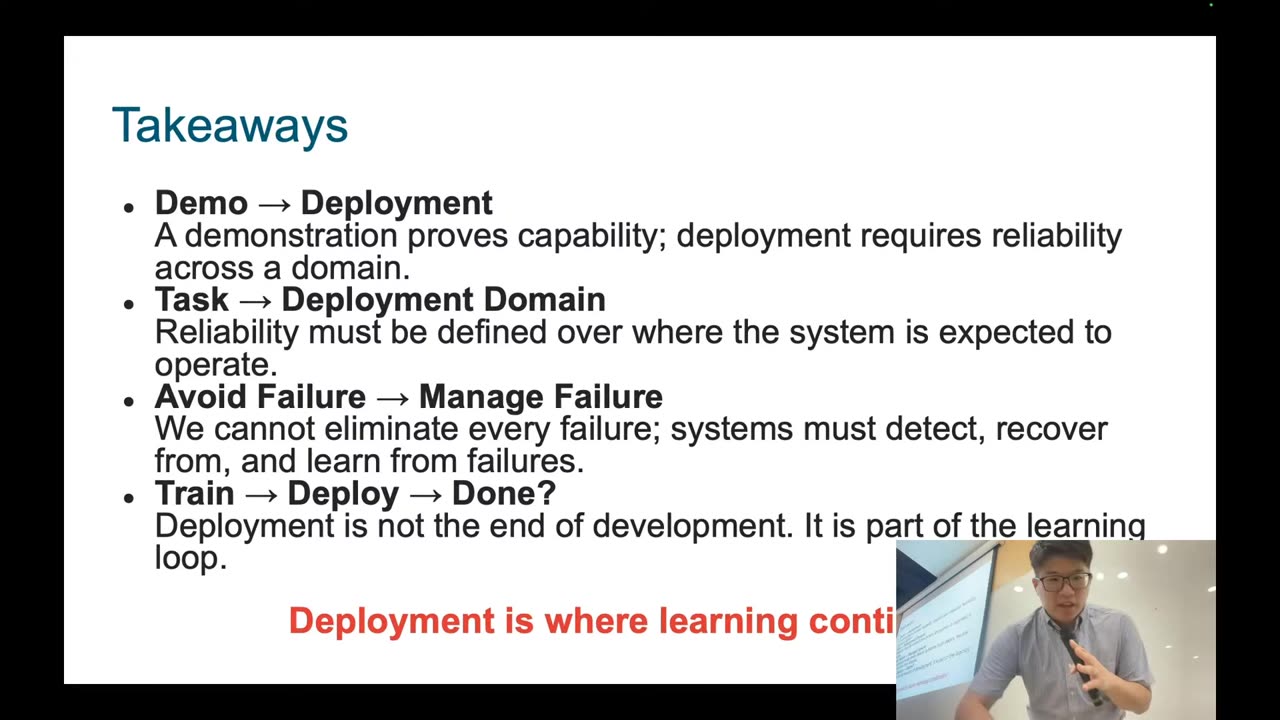
四個 takeaway:Demo → 部署(demo 證明能力,部署需要在一個範圍內的可靠度);任務 → 部署範圍(可靠度必須定義在系統預期運作的範圍上);避免失敗 → 管理失敗(無法消除每一個失敗,系統必須能偵測、恢復並從失敗中學習);訓練 → 部署 → 完成?(部署不是開發的終點,而是學習迴圈的一部分)。
Part 2:前四講是一種「看問題的方式」
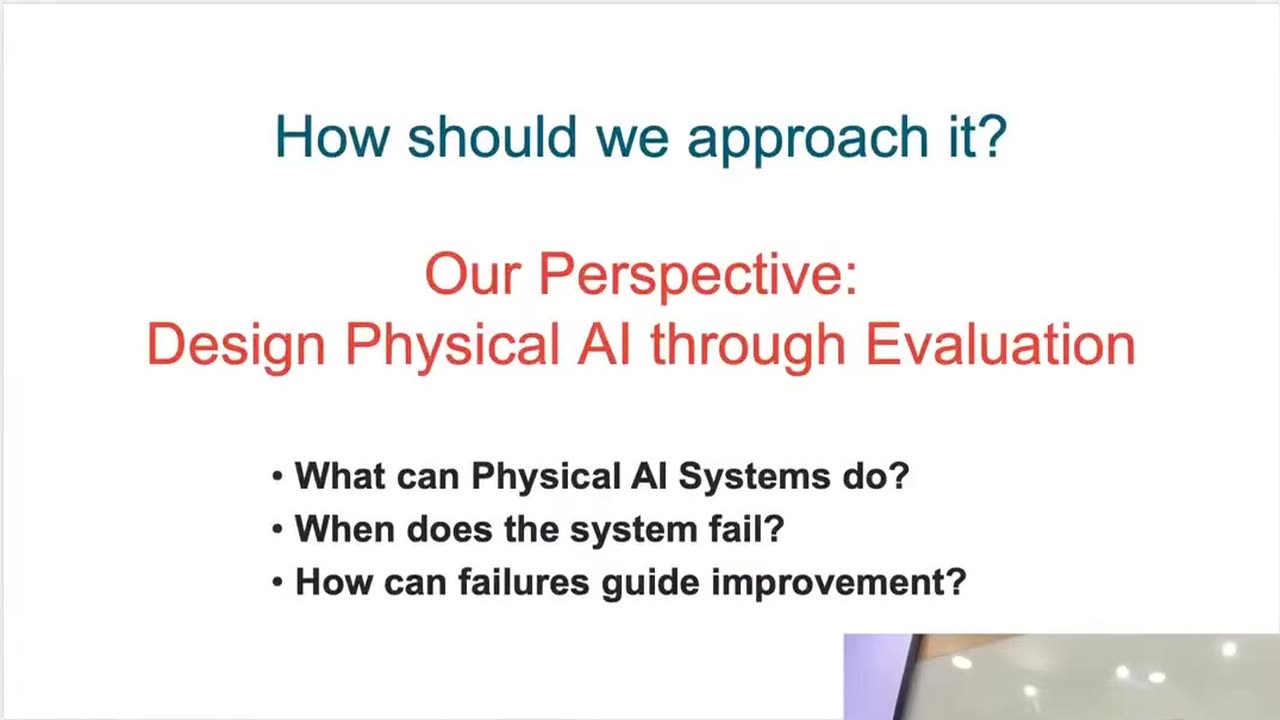
Part 2 是講者因為耳機麥克風沒電,為線上觀眾補錄的 14 分鐘。除了重述 takeaways,他說明前四講(基礎篇)到此告一段落,下一講開始進入技術元件,也就是 sense–plan–act。
更重要的是他想傳達的思考方式:每一講都從「本講三個重點」出發,那是他自己理解 Physical AI 的路徑;請不要逐字背投影片,而要看他怎麼切入問題。例如第二講介紹完 Physical Intelligence 等公司的進展後,他刻意轉向追問「Physical AI 只是通用機器人嗎?」;這一講則把自駕車領域的 ODD 帶進機器人操作。人機互動、人機協作等其他領域也有各自的經驗可以借用。跨領域借用視角,才能用不同的方式看見並解決問題。
這一講留下的三個問題
- 你的系統(或你關注的機器人產品)的 ODD 是什麼?試著用「物件、任務、環境、實體形式、互動的人」寫下它的邊界。
- 在你的應用裡,哪一種失敗發生頻率低、但嚴重度極高?你的評估指標有辦法反映它嗎?
- 當系統發現自己超出 ODD 時,它該自行恢復、執行備援,還是交給人?這些失敗資料又要如何回到資料飛輪?