快速掌握
本講核心:機器人要從人類示範中學習,第一步是把一連串感測器觀測還原成「有空間座標的軌跡」與「持久的世界表示」,這正是 SLAM(同步定位與建圖)要解決的問題。講者從 UMI 手持夾爪出發,依序拆解三個模組:用座標系與轉換矩陣表示運動、用針孔相機模型加上深度還原幾何、把多幀點雲轉到共同座標系來建立持久地圖;最後提醒兩兩配準的小誤差會累積成漂移,必須靠迴路閉合取得全域一致。
- 前四講(基礎篇)結束,第 5–7 講進入 sense–plan–act 的技術元件,本講從 sense 開始。
- SLAM:建立環境的持久表示(地圖),同時估計機器人或裝置相對於這張地圖的姿態。
- 每個觀測都配一個相機座標系;轉換矩陣 ATB 把兩個座標系連起來,串起來就是軌跡。
- 一個像素只對應一條射線,必須加上深度 Z 才能反投影回 3D;整張深度影像反投影後就是點雲。
- 只做兩兩配準(里程計)會漂移;SLAM 追求的是全域一致的表示,需要迴路閉合。
進入 sense–plan–act:從 sense 開始
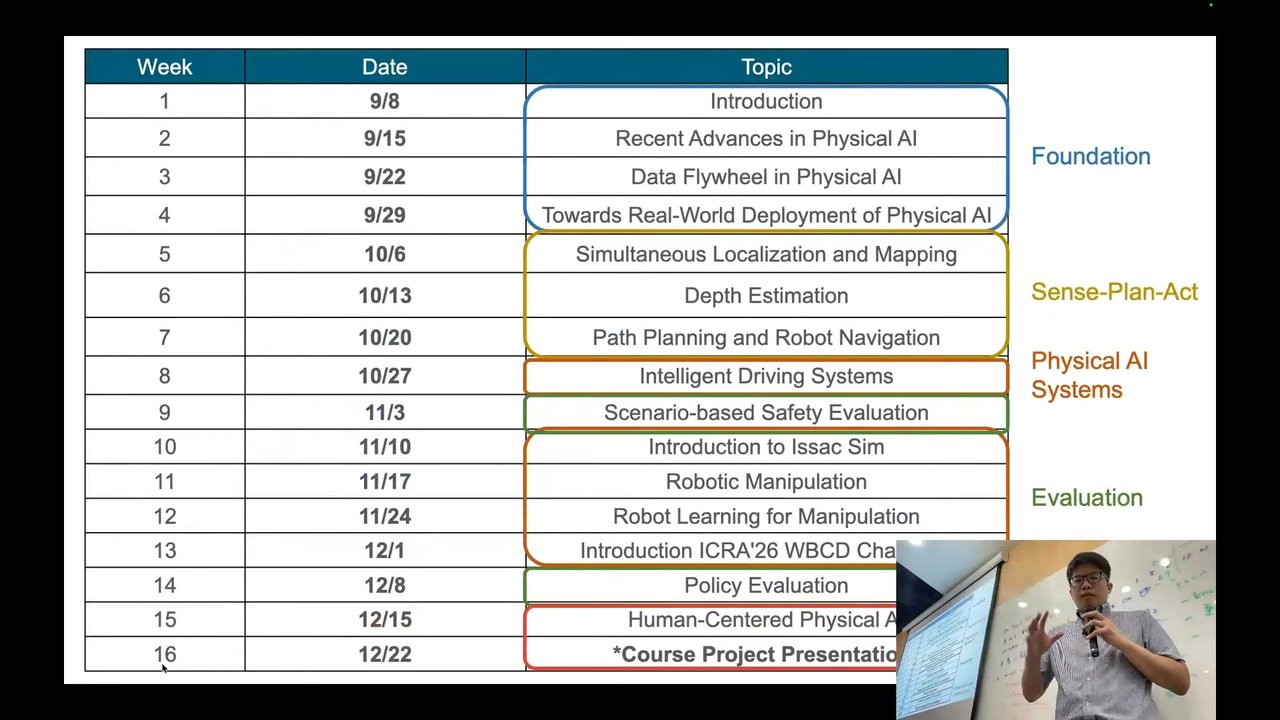
講者先花幾分鐘回顧上週:demo 不等於部署、可靠度要定義在運行設計範圍(ODD)上、要從「避免失敗」轉向「管理失敗」,以及「部署是學習的延續」。他說這是前四週的結論,並鼓勵大家回頭檢查自己能不能獨力說明每一講提到的概念。
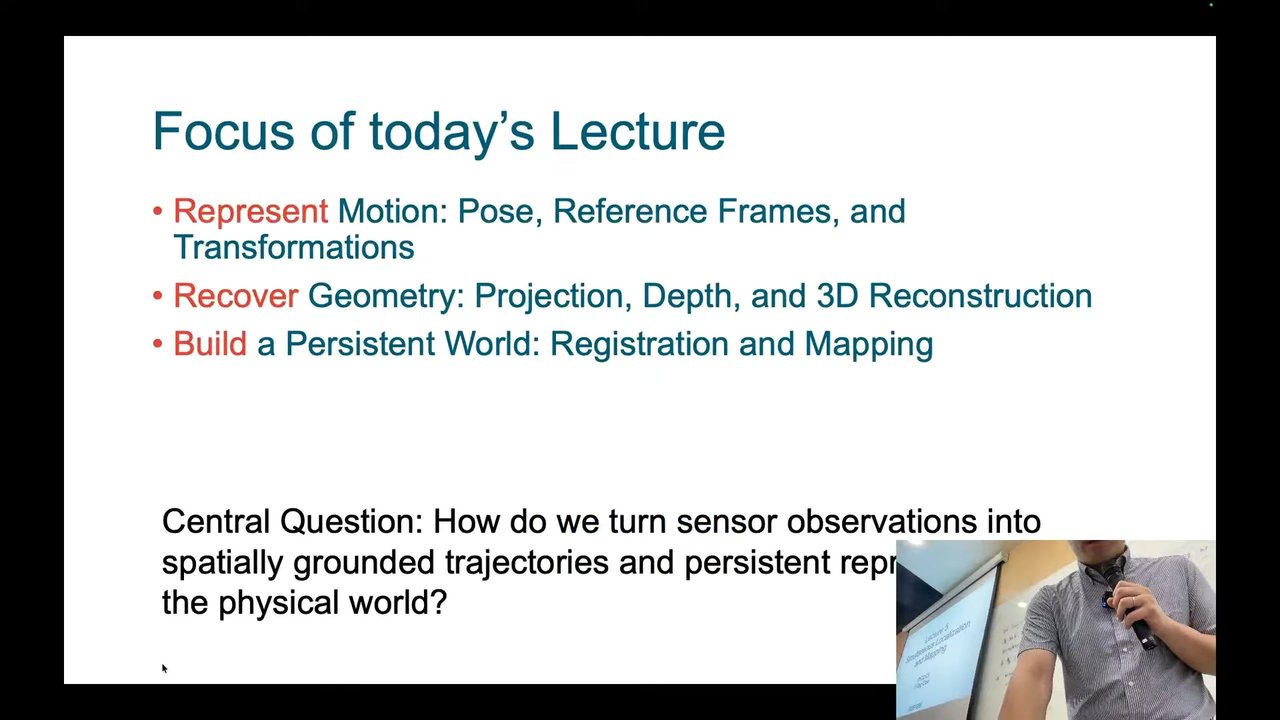
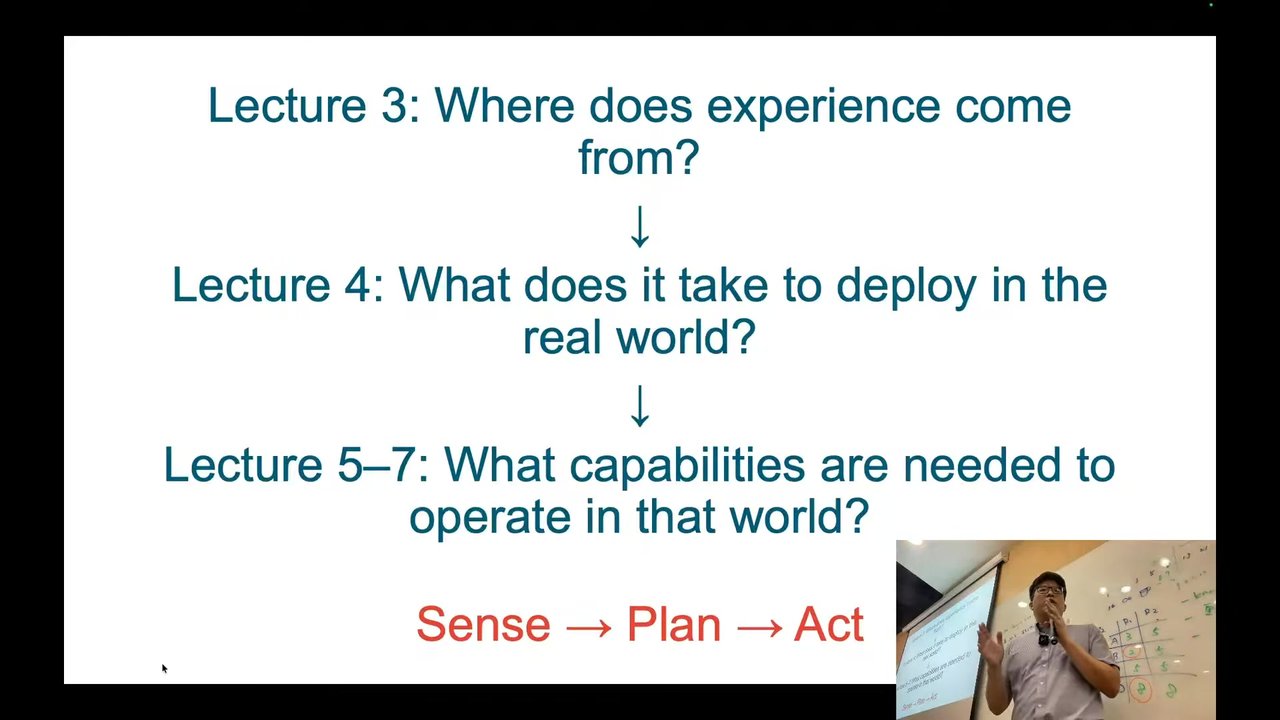
放回資料飛輪來看:第 3 講談經驗從哪裡來,第 4 講談部署需要什麼,接下來三講談「在那個世界運作需要哪些能力」,也就是第一講提過的 sense–plan–act 典範。這一講只處理第一段:sense。
為什麼從 UMI 談起:把人類示範變成機器人控制
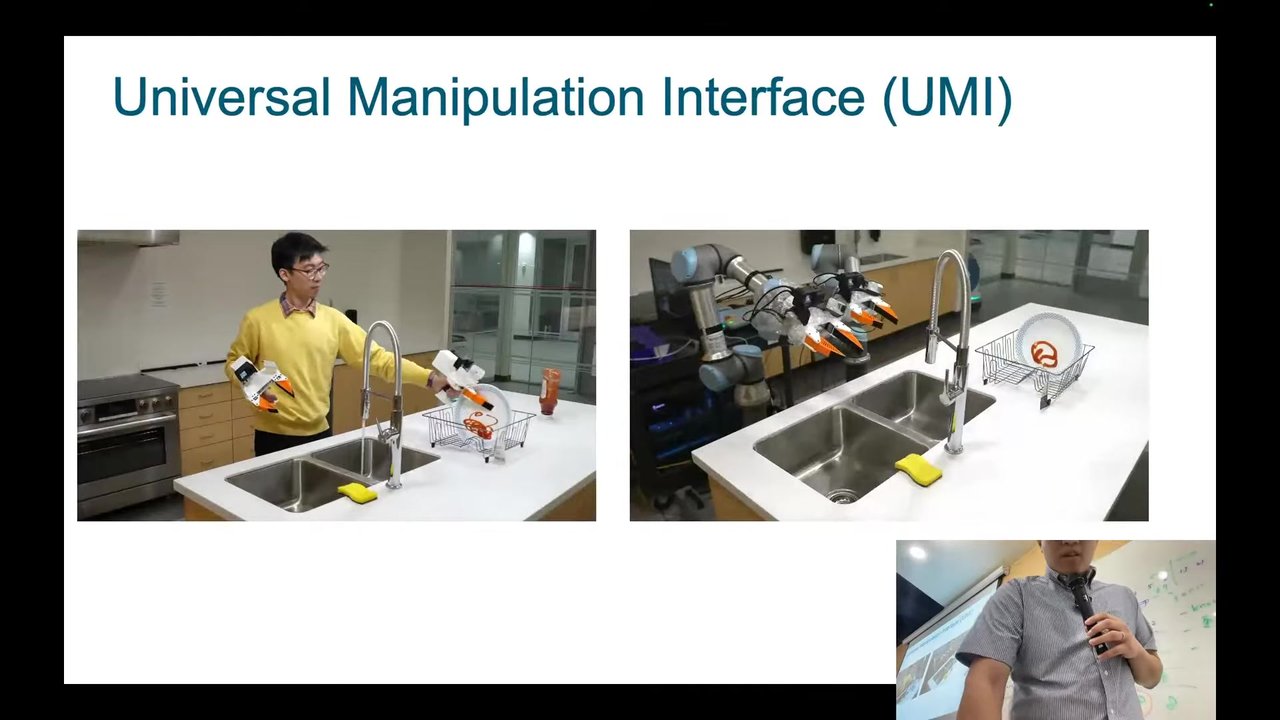
講者沒有用典型的機器人學方式介紹 sense–plan–act,而是從第 3 講提過的一種經驗收集方式切入:遙操作的一個實例,Universal Manipulation Interface(UMI)。影片左邊,示範者兩手各拿一支 UMI 夾爪,抓盤子、洗碗、放好;右邊的雙臂機器人做同一件事,示範者中途關水、刻意擾動,機器人還能應對。講者的實驗室依開源說明做了好幾支,之後會讓同學實際拿來試。
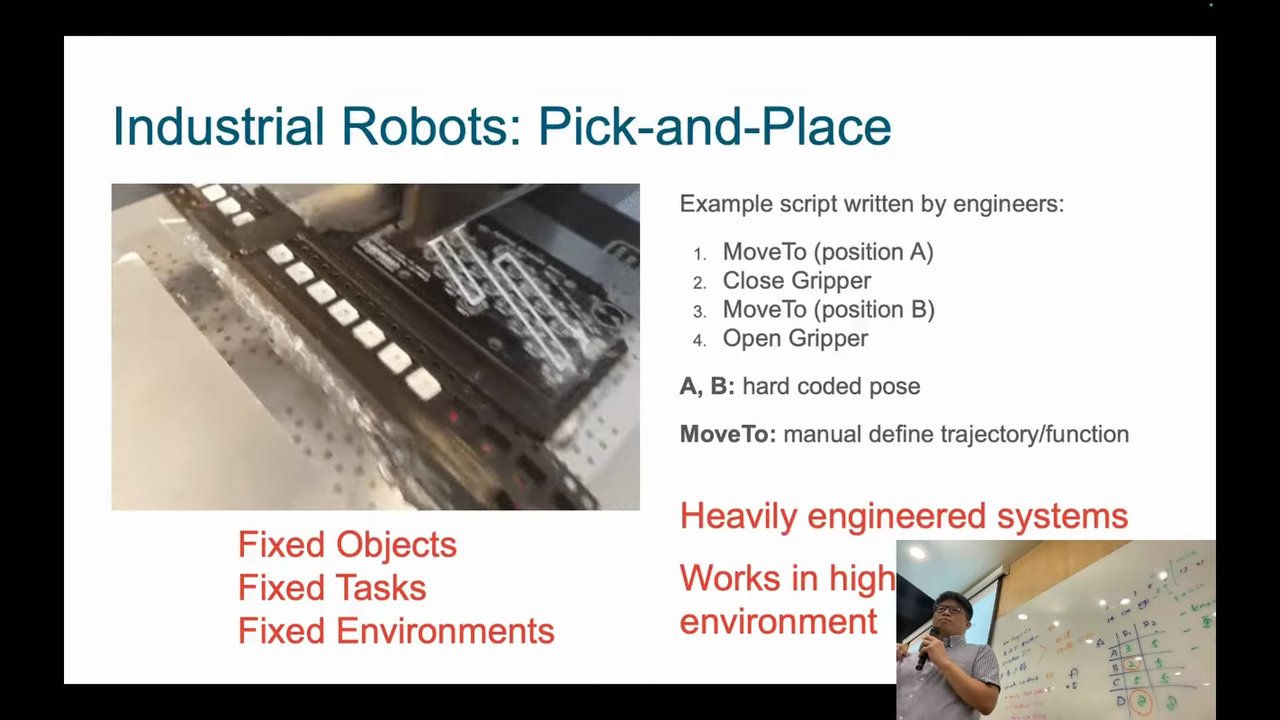
為什麼要繞這一圈?工廠的取放任務可以預先寫好程式;但如果要抓任意物件、完成像「拋擲」這種會隨物件特性而變的任務,就很難事先寫好。於是問題從「工程師指定軌跡」變成「能不能從示範中學」。
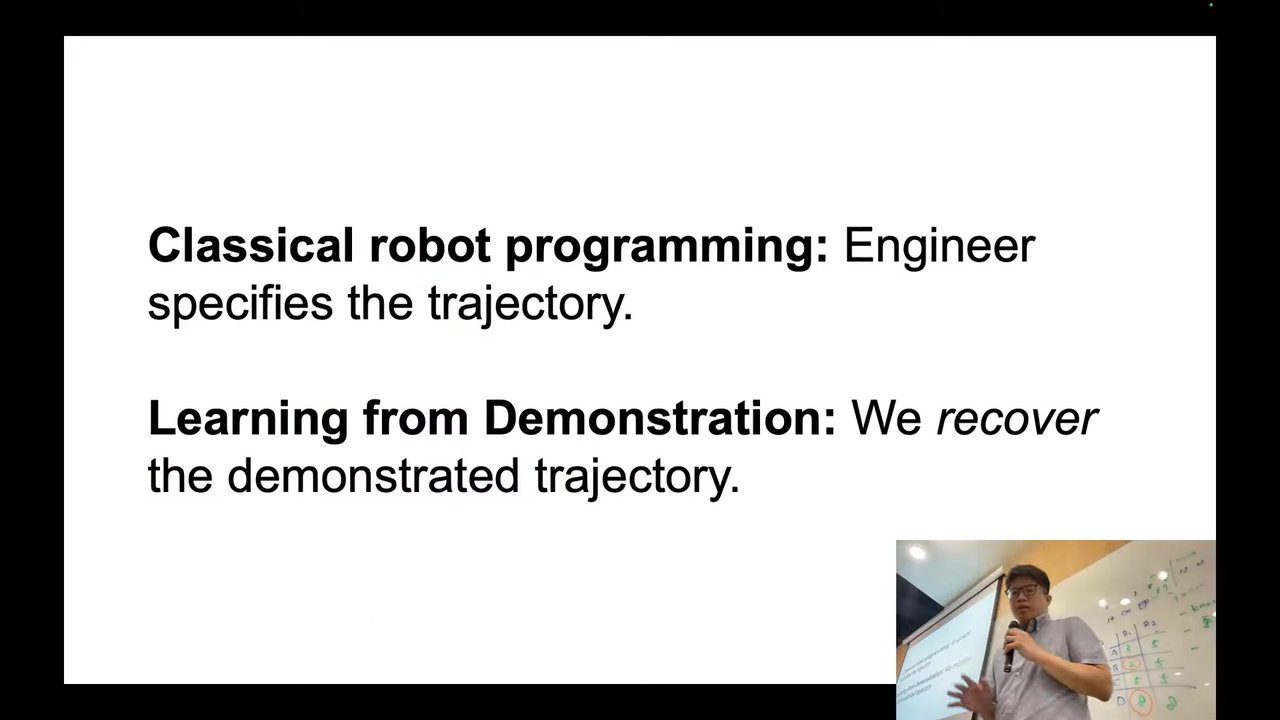
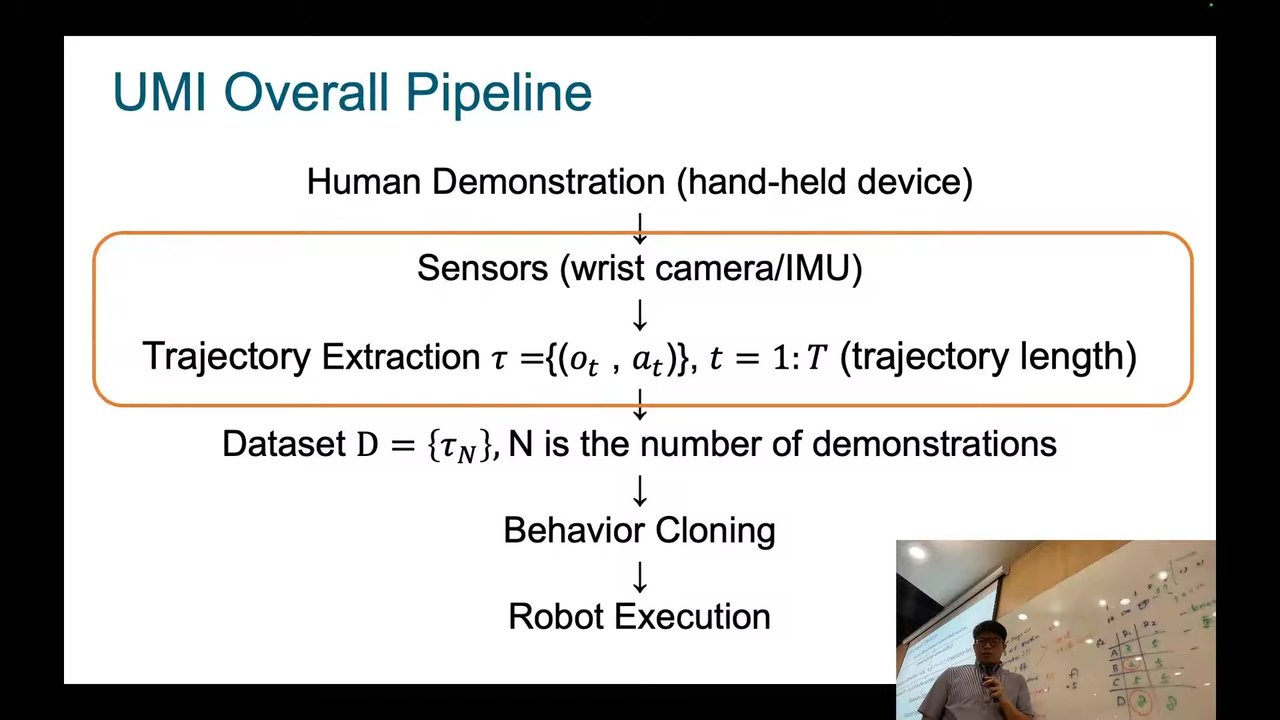
UMI 的流程是:人拿著裝有腕部相機與 IMU 的手持裝置示範,從記錄中擷取軌跡,累積成資料集,用行為複製(一種示範學習方法)訓練,再讓機器人執行。後段的學習與部署不是這一講的重點,講者要談的是中間那個「秘訣」:怎麼從感測器資料得到軌跡。
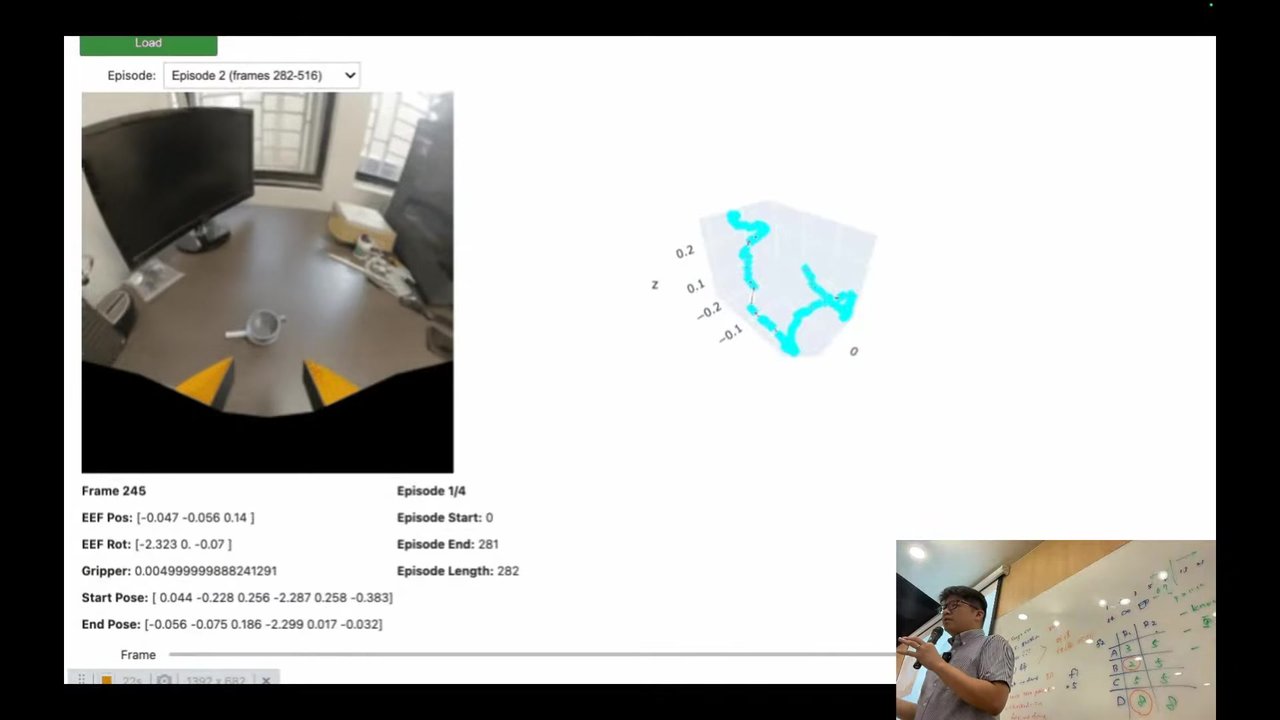
SLAM 是什麼:持久的地圖,加上自己的姿態
要回答「怎麼把觀測變成有空間依據的軌跡與表示」,講者介紹同步定位與建圖(simultaneous localization and mapping,SLAM):一邊建立環境的持久表示,也就是地圖;一邊估計機器人或裝置相對於這張地圖的姿態。
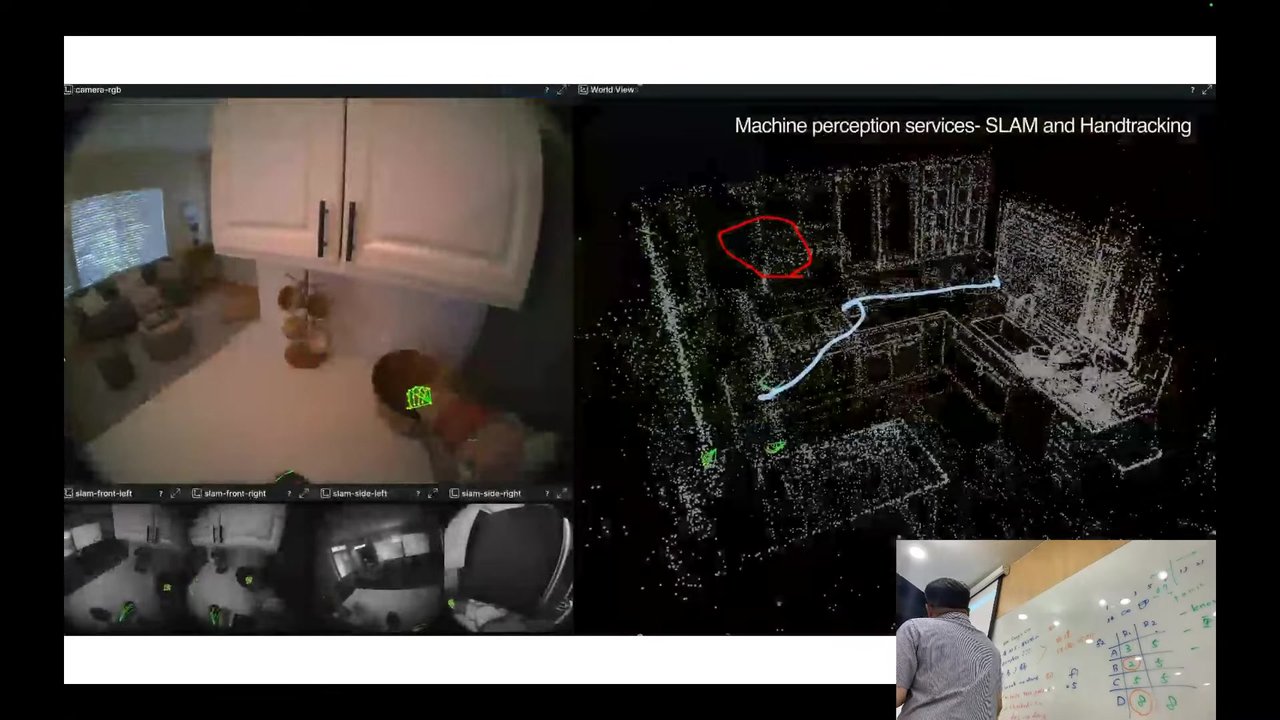
例子是 Meta 的 Project Aria 研究用眼鏡:上面有多顆相機、IMU 等感測器,朝內的相機還能追蹤瞳孔。戴著它在廚房裡活動,就能即時建出廚房的稀疏點雲地圖、畫出移動軌跡,並把從影像辨識出的手部骨架放進同一個 3D 空間,看到手正在切東西、拿東西。
講者接著問:畫面上那條軌跡是「誰的姿態」?同學猜機器人、猜那位女士、猜頭部。這個問題他留到後面才回答(見下文「相機投影矩陣」一節)。
現場示範:用 iPad 重建教室
講者請一位同學拿 iPad(兩顆相機加一顆 LiDAR)繞教室一圈:畫面上紅色的區域代表裝置還沒看過的地方,她的任務是一邊移動、一邊旋轉傾斜 iPad,把紅色盡量消掉,最後回到起點。裝置持續收資料、處理成 3D 幾何,再按一下把顏色材質貼上去,就得到一個可以任意旋轉的教室模型。因為現場改用有線網路,iPad 畫面接不上筆電,講者答應之後把影片上傳給線上的同學。
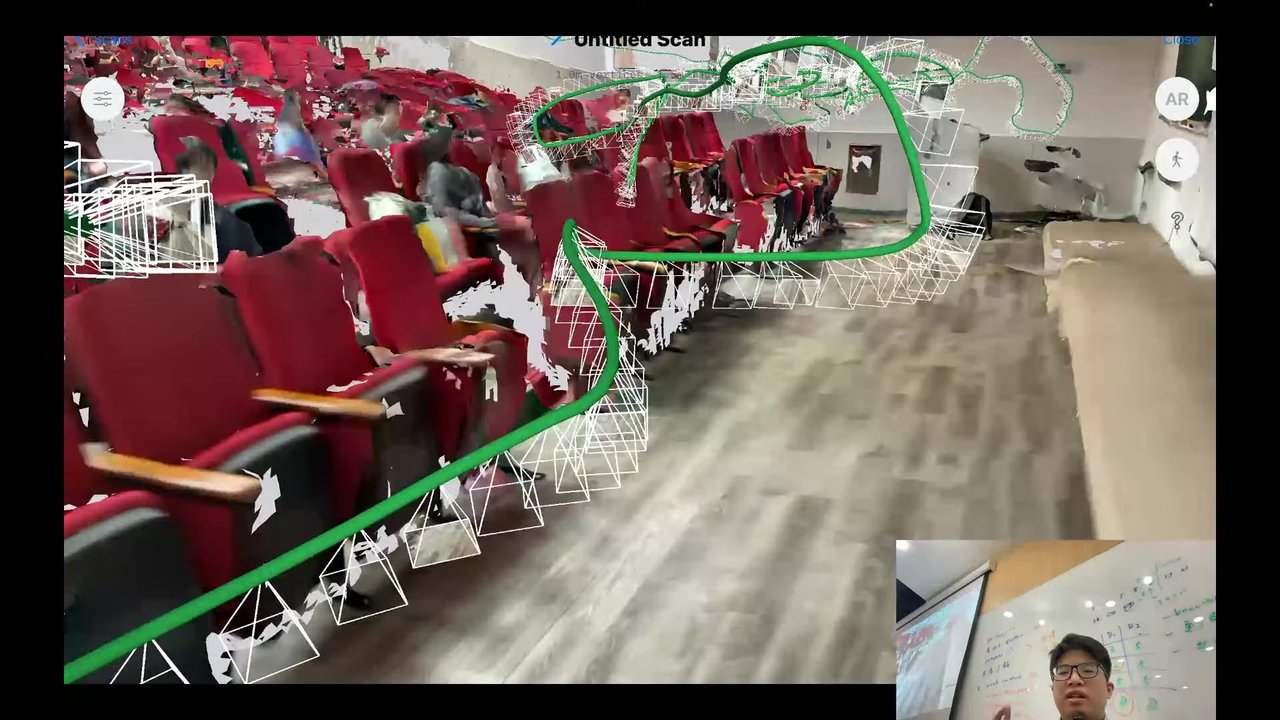
下課後講者用另一間教室先前的重建結果說明兩件事。第一是持久的表示:講者站在講台只看得到台下的視角,重建之後卻能看到「坐在後排的學生看講者」的畫面——不是想像出來的,而是因為那位同學真的走過那裡、拍下了資料。第二是姿態:那條綠線不會是直線,因為拿裝置的人一直在移動、旋轉、傾斜;沿線每一個觀測,都用一個座標系表示它在 3D 空間中的位置。
接下來要談的是視覺 SLAM:輸入換成影像。差別在於用了哪些感測器;iPad 與 Project Aria 都同時用了相機、LiDAR 或 IMU,所以結果才會那麼好。本講剩下的時間就拆成三個模組:表示運動、還原幾何、建立持久的世界。
表示運動:每個觀測配一個相機座標系
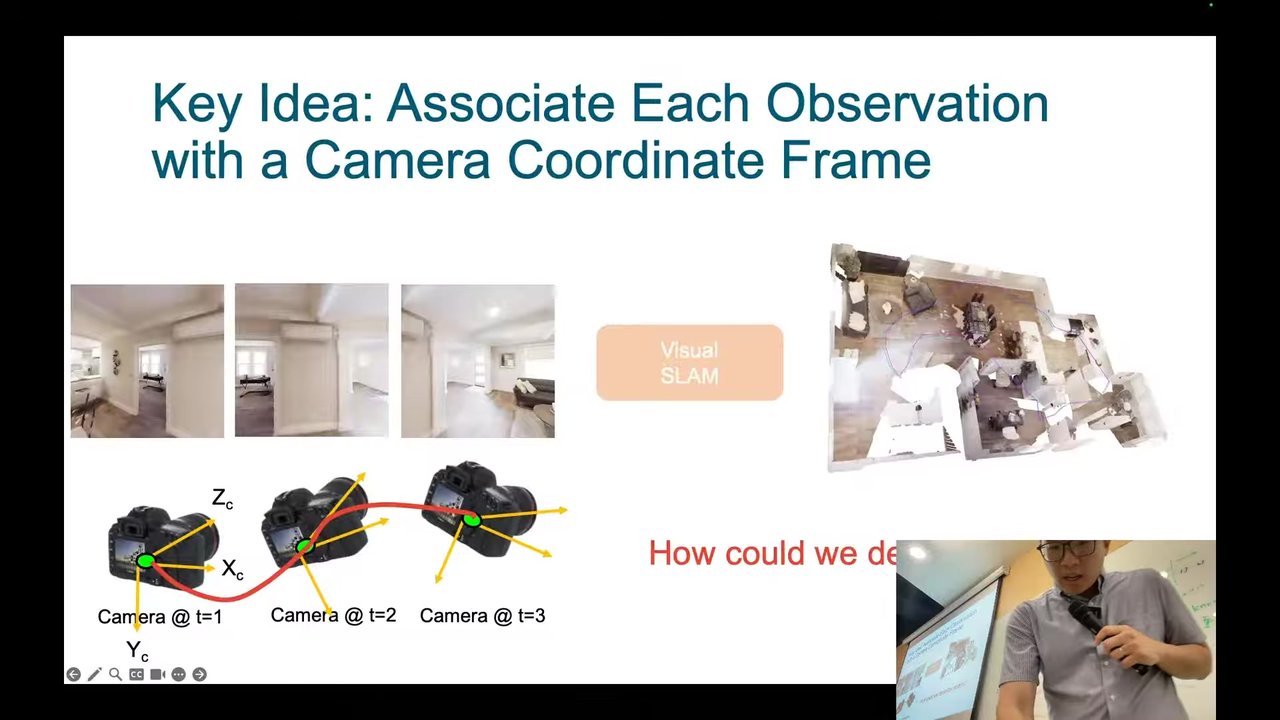
第一個模組要回答:在座標系 B 觀察到的東西,怎麼在座標系 A 裡描述?講者的做法是把每個觀測對應到一個相機座標系。拿著相機拍一張、移動一下再拍一張、再移動再拍一張,就得到三張影像;在每個拍攝當下的相機上放一組依右手定則定義的 X、Y、Z 軸,三張影像就對應到三個座標系。這等於把高維的影像資料,整理成低維的結構。
原點放哪裡其實由你決定:可以是教室角落、桌上的筆電,也可以是相機本身。只要選定原點與三個軸的方向,就能描述任何物體的位置。把每個時間點的相機當成一個座標系的原點,再把這些原點連起來,就得到相機在空間中的運動軌跡。接下來的問題是:要用什麼語言描述這段運動?
描述運動的語言:旋轉、平移與齊次座標
講者說旋轉的表示應該是先修知識,所以講得很快。2D 平移是 p′ = p + t,旋轉是 p′ = Rp,兩者合起來是 p′ = Rp + t;問題是平移沒辦法和旋轉放進同一個 2×2 的矩陣乘法裡。
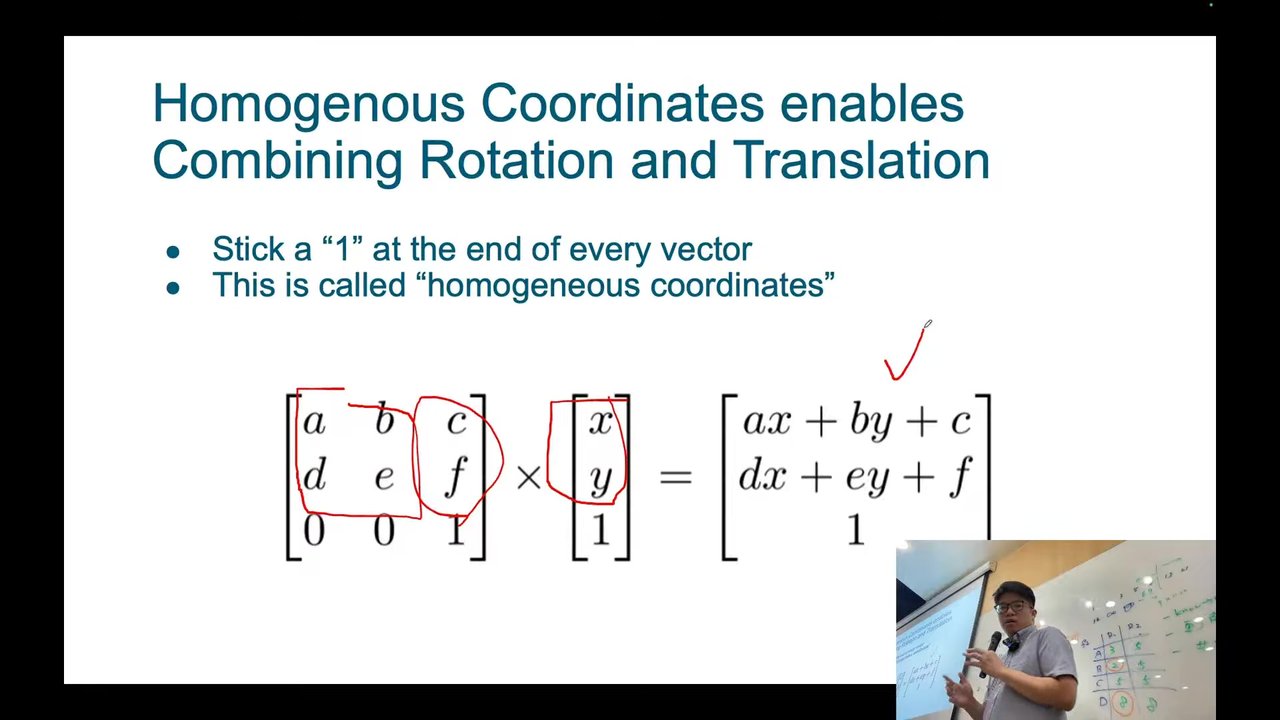
解法是齊次座標:在每個向量後面補一個 1,(x, y) 變成 (x, y, 1);要轉回笛卡兒座標,就把前面的元素除以最後一個元素。這樣旋轉矩陣和平移向量就能組成一個齊次轉換矩陣,用一次矩陣乘法同時完成旋轉與平移。
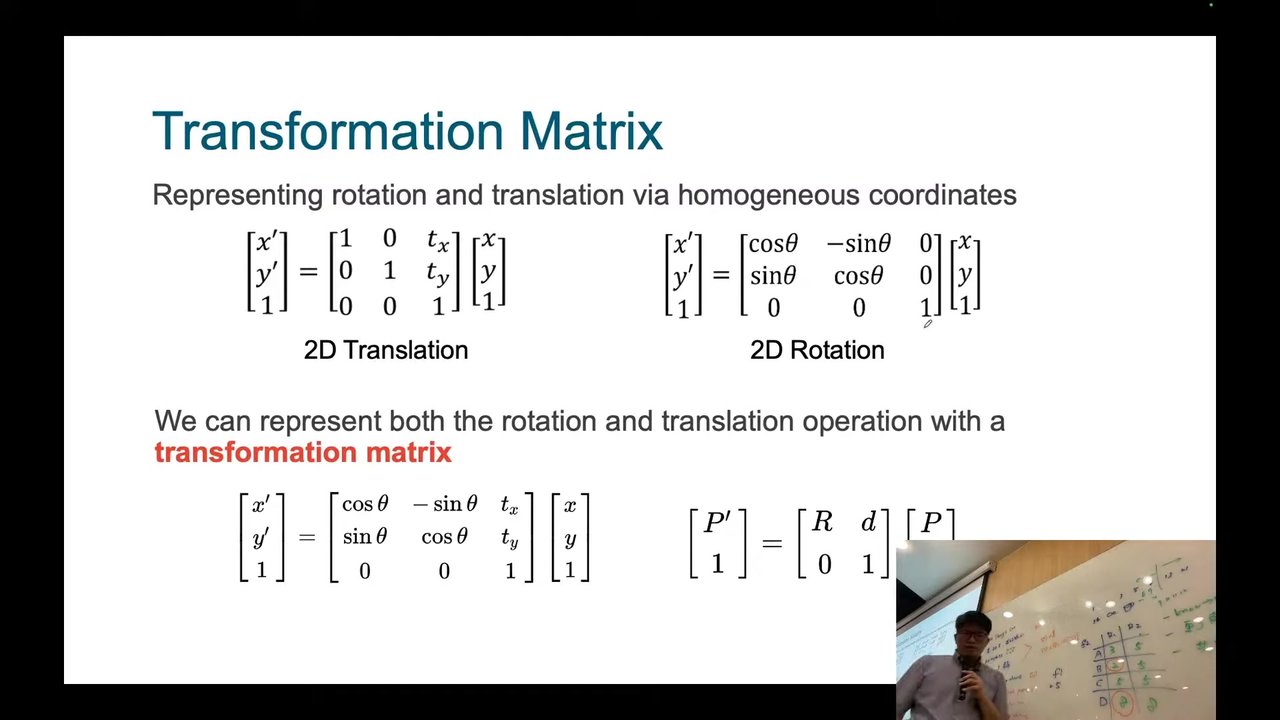
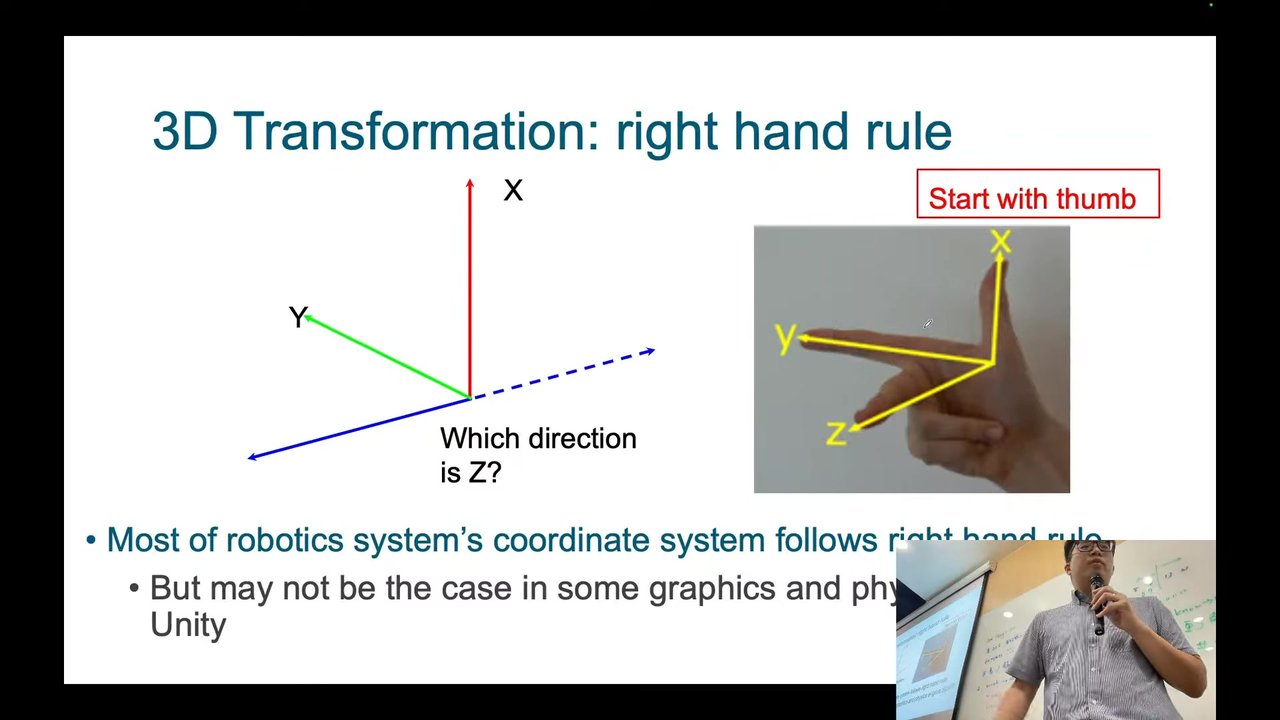
到了 3D,講者用自己實驗室的空間舉例:機械手臂、架上的多台相機、桌上的每個物體,都可以各自定一個 3D 座標系,再加上一個世界座標系。3D 平移和 2D 差不多,差別在旋轉:2D 是繞一個點轉,3D 是繞一條軸轉。
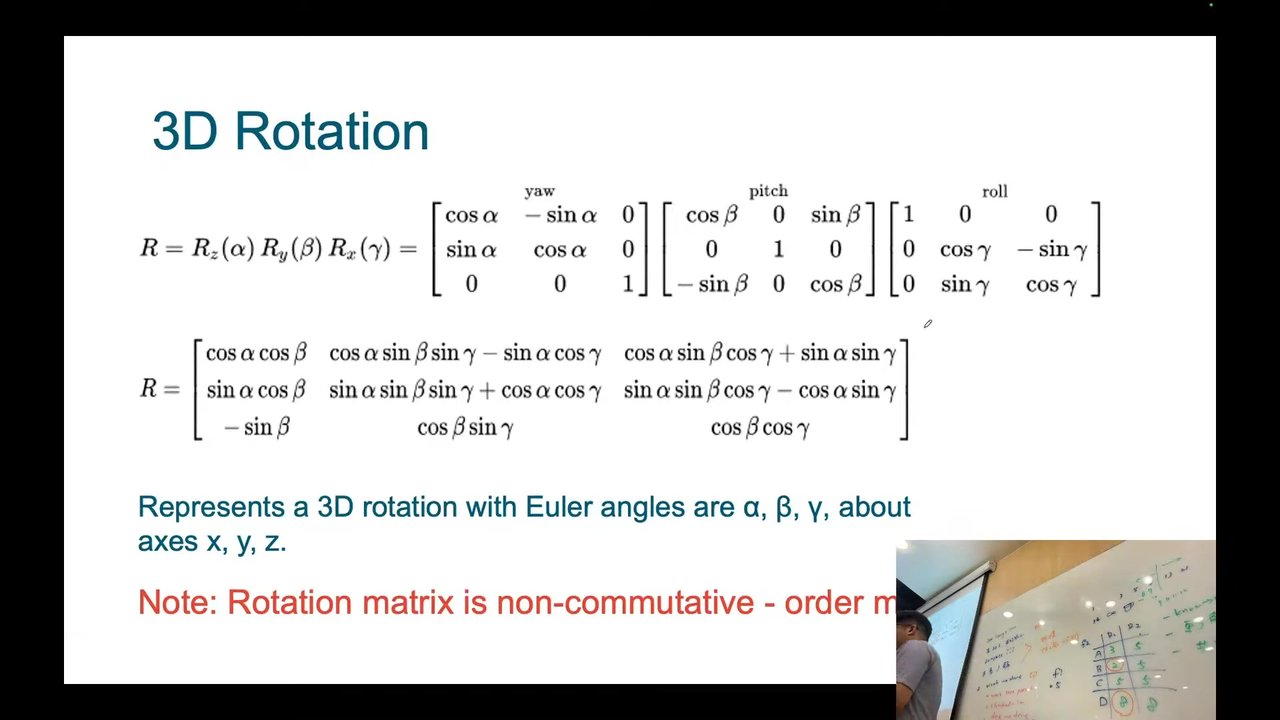
常見的表示是歐拉角:繞 z 軸是偏航(yaw)、繞 y 軸是俯仰(pitch)、繞 x 軸是翻滾(roll),三個矩陣依序相乘就是 3D 旋轉。講者特別提醒順序不能換。3D 轉換矩陣則是 4×4:左上 3×3 是旋轉、右邊 3×1 是平移;0P = 0T1 1P 表示把座標系 1 中的點轉到座標系 0。
參考座標系:同一個點,不同的座標
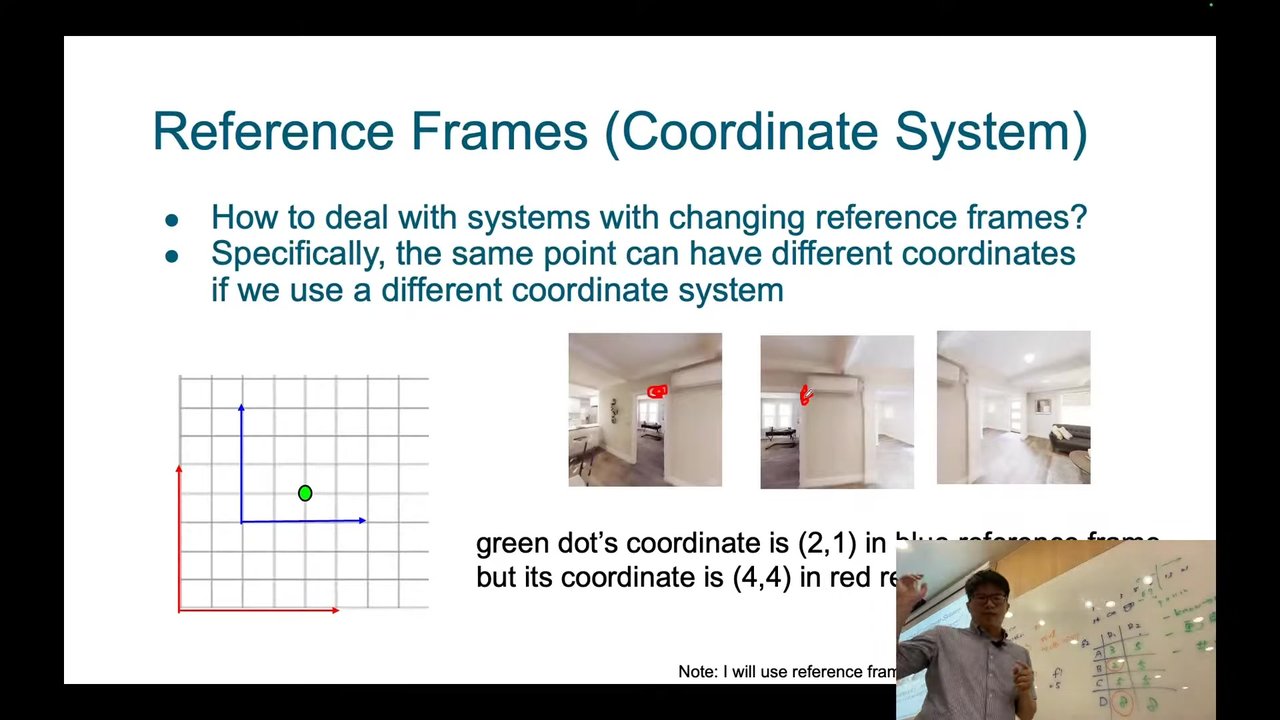
這三張照片之間,參考座標系在變嗎?在變——每拍一張,相機就換了一個座標系。所以同一個 3D 點,從第一台相機看有一組座標,從第二台相機看是另一組;點沒變,變的是座標系。講者用 2D 的例子說明:同一個綠點,在藍色座標系是 (2, 1),在紅色座標系是 (4, 4)。
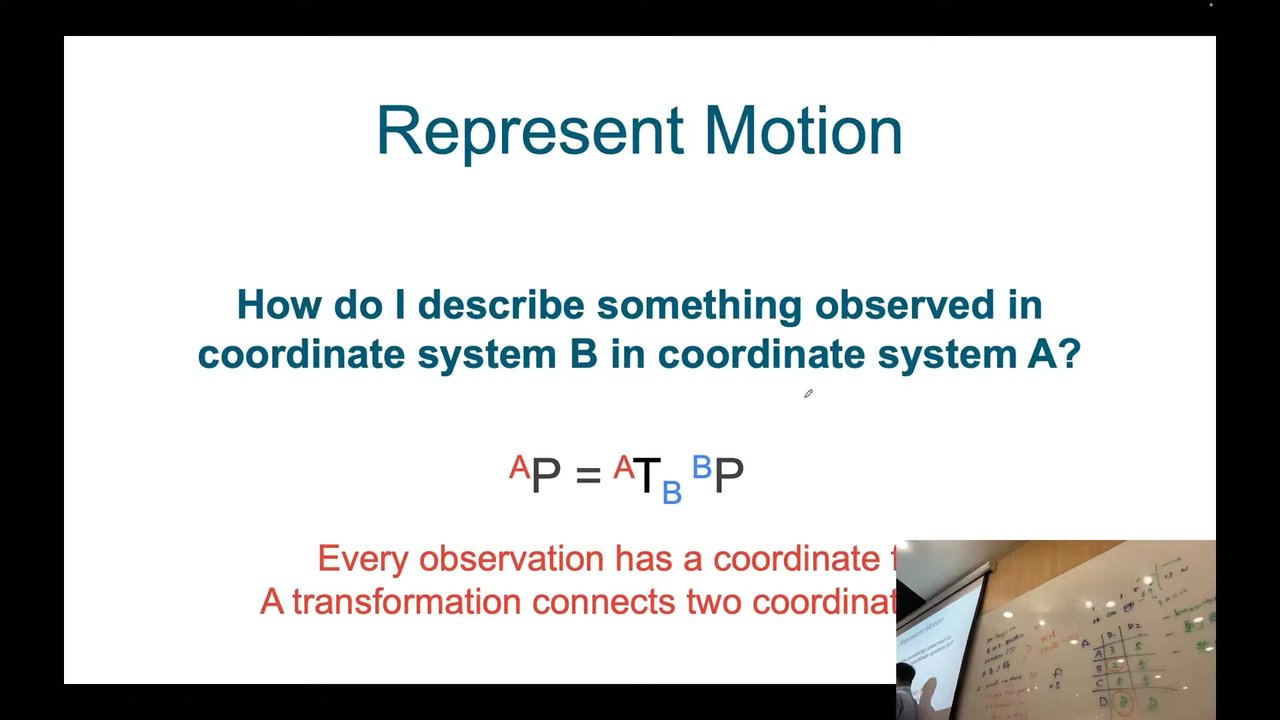
把座標系 B 中的點 BP 轉到座標系 A,只要乘上從 B 到 A 的轉換矩陣 ATB。回到三張照片:第一、二台相機之間要一個轉換矩陣,第二、三台之間要另一個,方向可以從 1 到 2,也可以從 2 回到 1。
但還有兩個問題沒回答:相機上那個「假想的」座標系到底放在哪裡、原點怎麼定?以及為什麼重建結果能讓我們從不同視角看這個世界?前者要靠針孔相機模型。
還原幾何:針孔相機模型
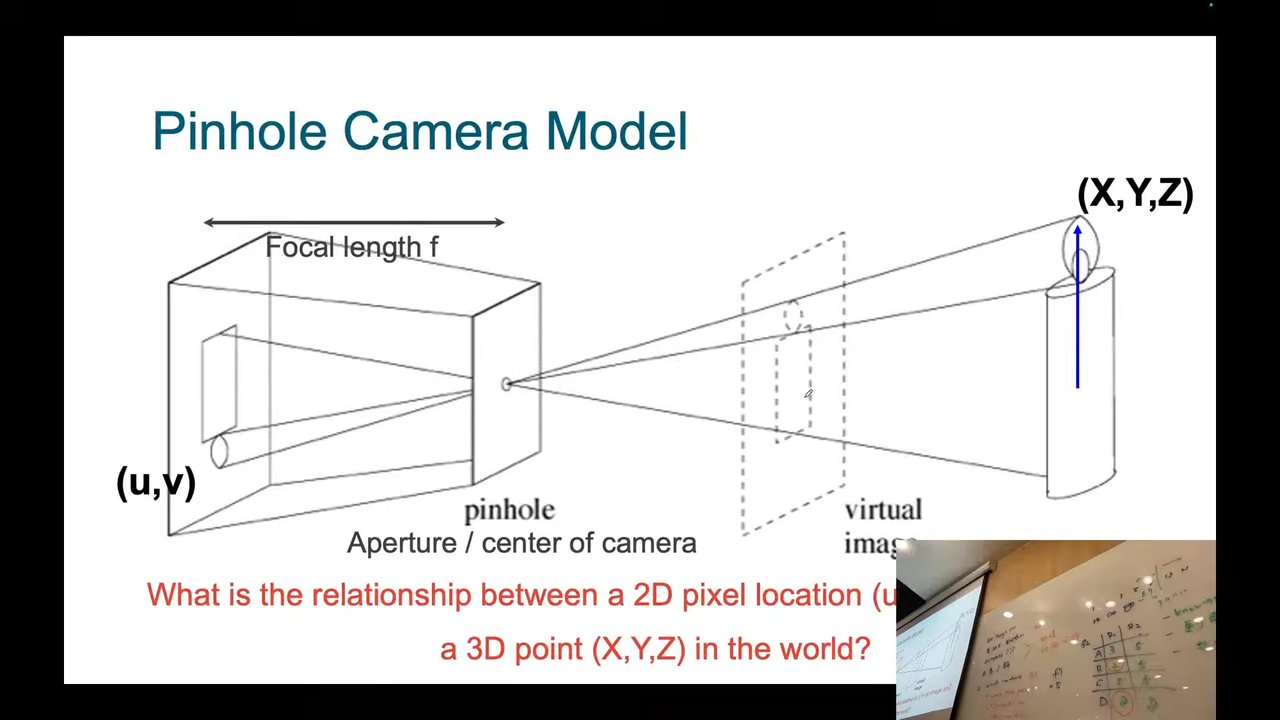
針孔成像大家國中可能做過:蠟燭的光穿過小孔,在後方屏幕上成一個縮小、倒立的像;把它翻到針孔前方,就是「虛像」。焦距是針孔到成像平面的距離;針孔在現代相機上就是光圈,也就是相機中心。把原點放在針孔、依右手定則讓 Z 軸沿著光軸,就替相機定好了 3D 座標系——這也回答了上一節「座標系放在哪裡」的問題。
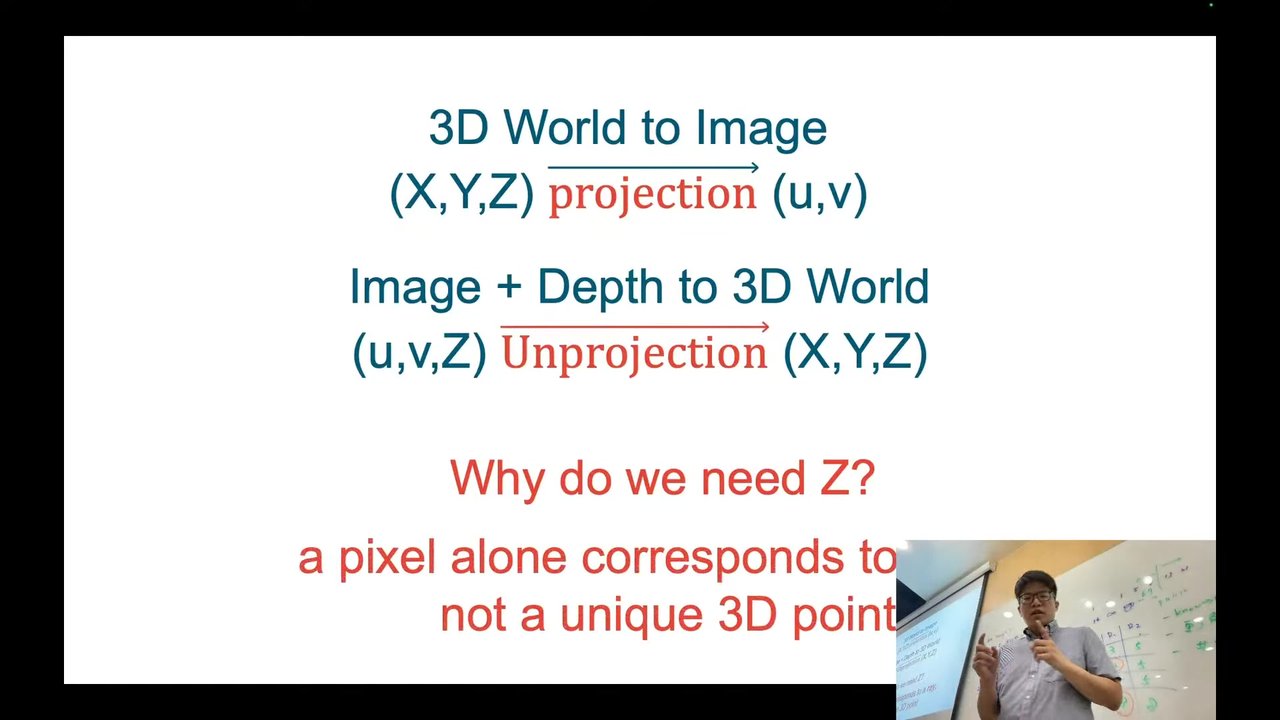
3D 點投影到影像叫投影;反過來,用像素位置加上深度回到 3D,叫反投影。為什麼一定要有深度?因為投影時深度資訊被丟掉了:影像上的一個像素,對應的是從相機中心射出去的一整條射線,物體可能在射線上的任何位置。不給 Z,最多只能知道它在那條射線上。
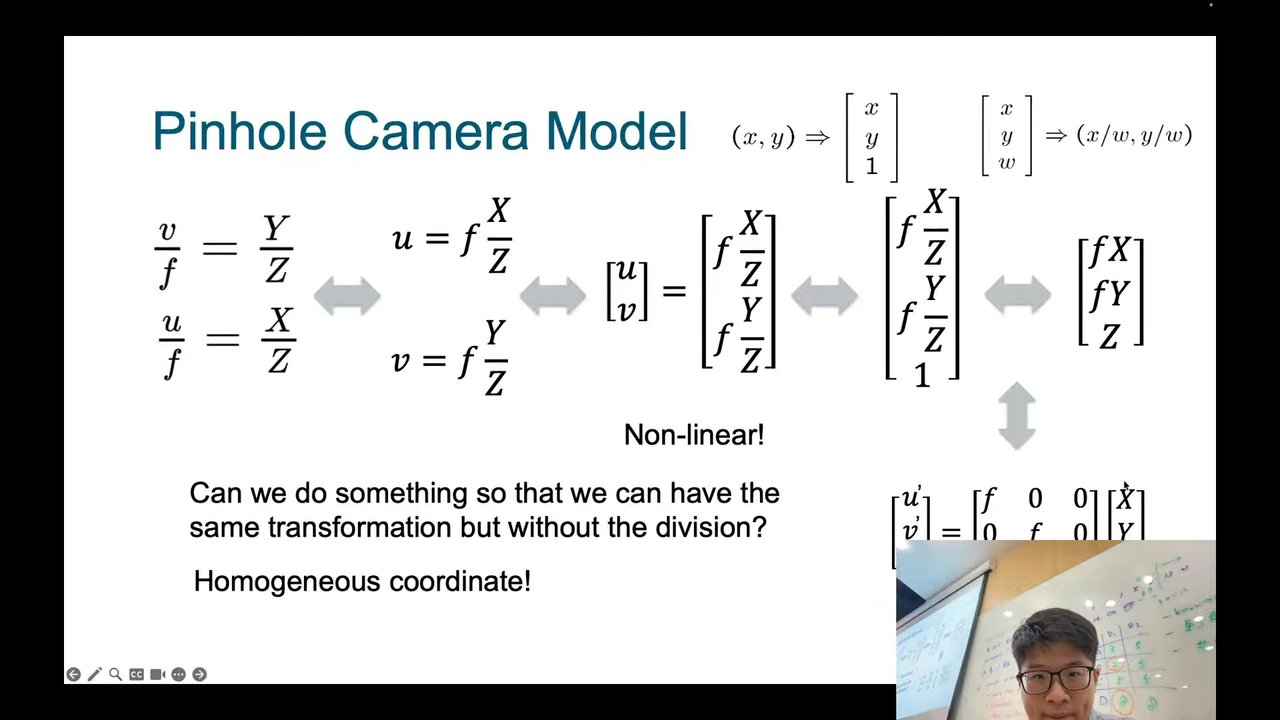
關係式來自兩組相似三角形:焦距 f 對應深度 Z,像素座標 u、v 對應 X、Y,所以 u = fX/Z、v = fY/Z。式子裡有除以 Z,是非線性的;再次借助齊次座標,就能寫成矩陣乘法,算出 (u′, v′, w) 後再除以 w。講者建議大家看著圖自己推一次,不要只抄投影片上的式子。
從影像座標到相機投影矩陣
第二次下課回來,講者承認這段從真實世界跳到抽象空間,容易讓人迷路;但最核心的想法其實只有一個:3D 座標系。座標系會隨相機一直變,我們要描述這些變動,最終建出持久地圖與裝置的姿態。
他也回頭回答 Project Aria「誰的姿態」:答案取決於開發者選了哪裡當參考座標系,可能是某一台相機,也可能是眼鏡中心;只要清楚描述各台相機之間的關係,換到哪裡都可以。他以自己做過的自駕車專案為例:據他所知,那些系統把原點定在車體上方便控制車輪的位置,而不是某顆感測器;這樣就必須知道相機、LiDAR 各自到那個點的轉換矩陣,這件事叫校正。
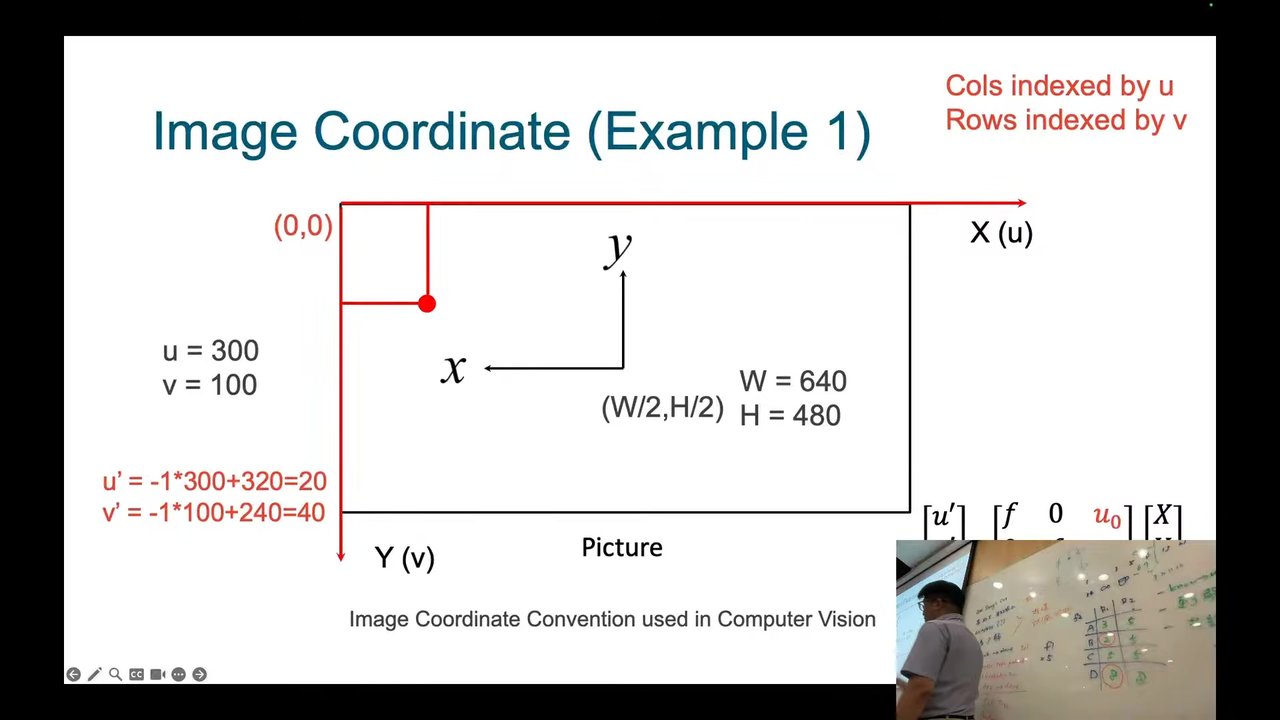
座標系不只一種:有相機座標、世界座標,還有影像座標。推導時把影像平面的原點放在中心,但影像處理習慣把原點放在左上角,所以還要再轉一次,在式子裡加上主點 (u0, v0)。另一頭,場景裡的物體通常是用另一個座標系(世界座標)描述的,要套用針孔模型,得先用世界到相機的轉換把它轉進相機座標系。
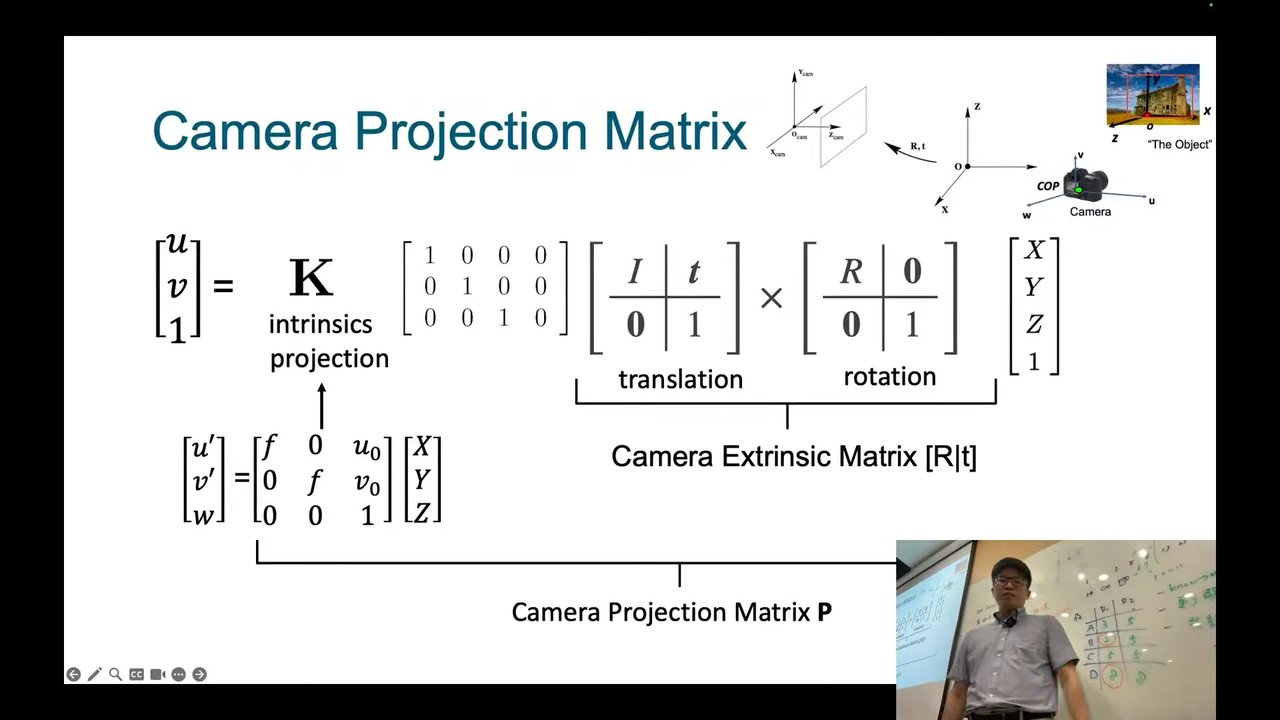
三塊拼起來就是完整的相機投影矩陣:齊次座標下的 3D 點先經外參(世界到相機的旋轉與平移)轉到相機座標系,再乘上包含焦距與主點的內參矩陣,投影到影像平面。講者提到 YouTube 上有人問這些是不是他發明的——不是,這是電腦視覺四十多年的教科書內容,他只挑了一小部分。電腦視覺除了辨識、分割、追蹤這些「辨識」面向,還有一條很長的幾何傳統,專門研究 3D 與 2D 之間的關係,這正是機器人操作與導航這類下游任務的基礎。
深度從哪裡來:深度相機、反投影與點雲
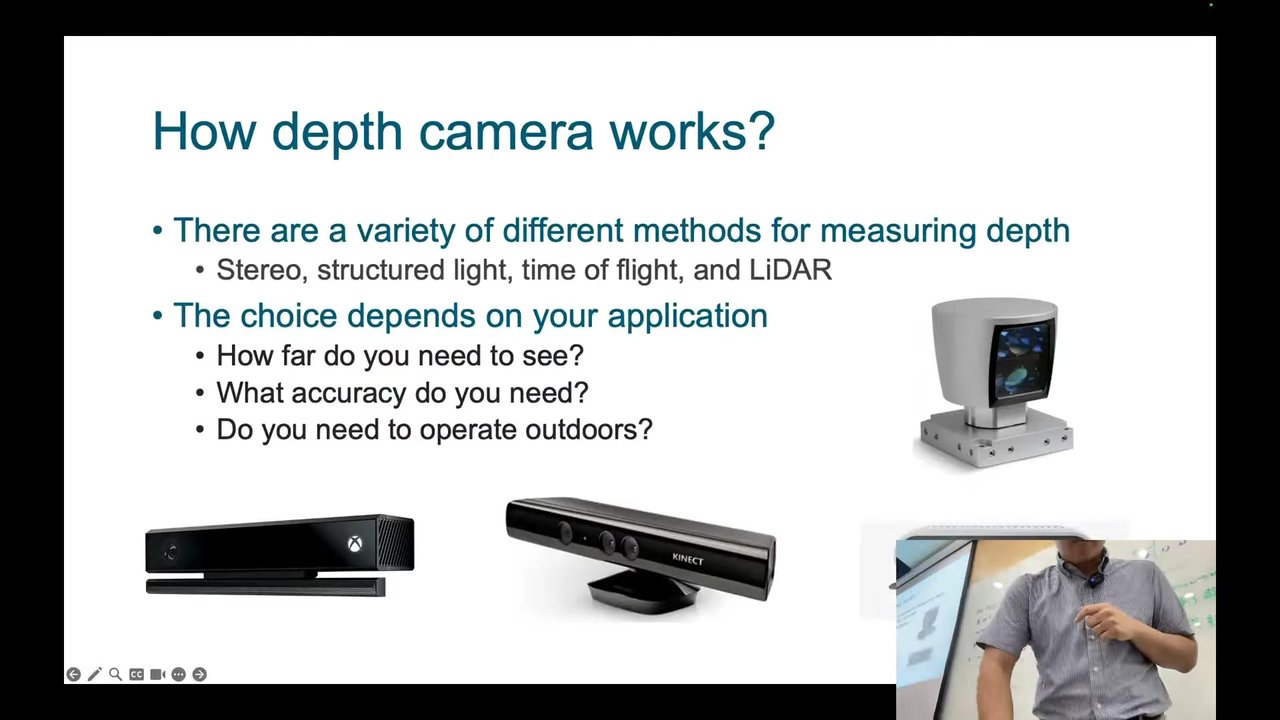
前面假設已知 Z,那 Z 從哪裡來?深度感測器有很多種,選擇取決於應用。講者用實務經驗提醒規格不能照單全收:有些小型感測器只在一公尺內有效,而且距離越遠誤差越大;某款感測器宣稱可達 120 公尺,但那麼遠只剩零星幾個點,看不出是車、是人還是自行車騎士,他自己只信到 60 公尺左右。
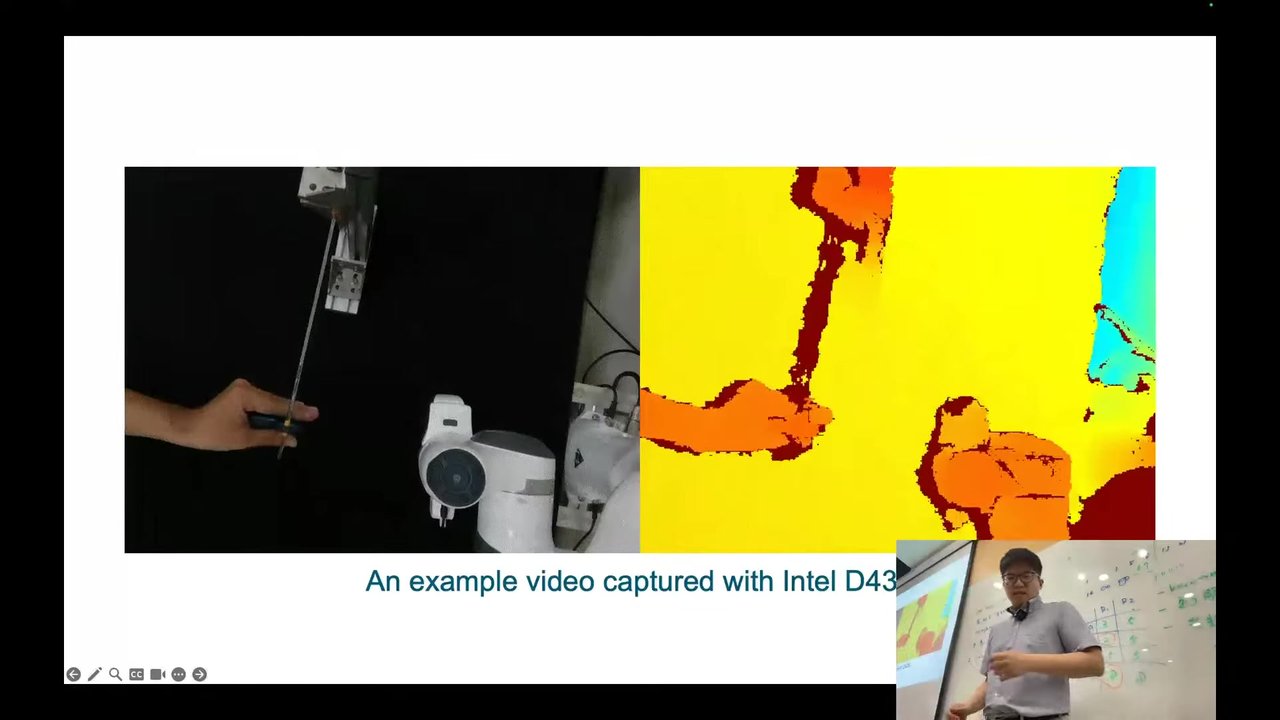
真實資料並不乾淨。這段 D435 影片裡,桿子離相機不到 50 公分,深度圖上卻寬得不合理;手移動時也帶著大量雜訊。深度影像裡也常有些區域的值是 0,那是缺少深度:雙目或結構光都要在影像間找對應點,遇到反光表面就找不到。講者說即使是商用產品也會這樣,原因留到下一講詳談。
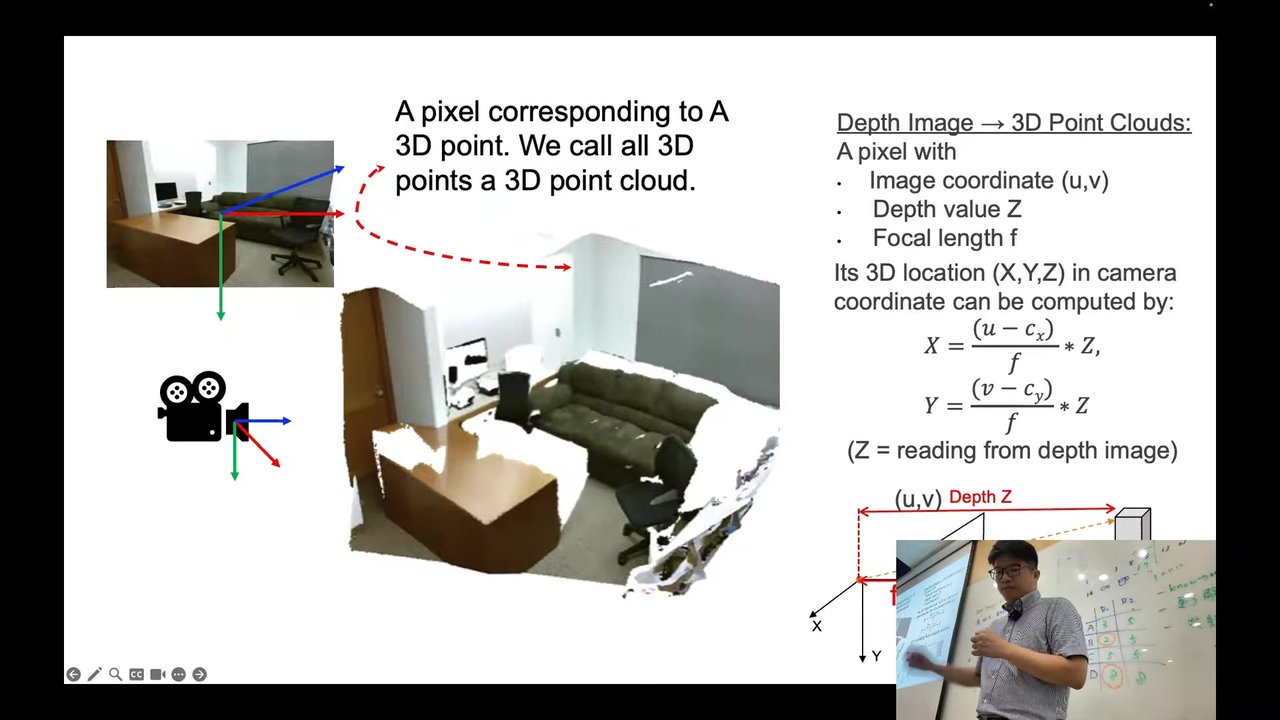
假設感測器夠好:彩色影像是 3×H×W,深度影像是 1×H×W,每個像素記錄一個深度值(公尺或公釐),缺值為 0。套用針孔模型反投影,焦距與主點由相機校正取得,每個像素就得到一個 3D 點;n 個像素得到 n 個點,合起來就是點雲。一幀有 n 個點,100 幀就是 100×n 個點——關鍵問題是:怎麼把它們合在一起?重建結果裡那些白色空洞,就是當時沒拍到的地方。
建立持久的世界:把多幀點雲轉到共同座標系
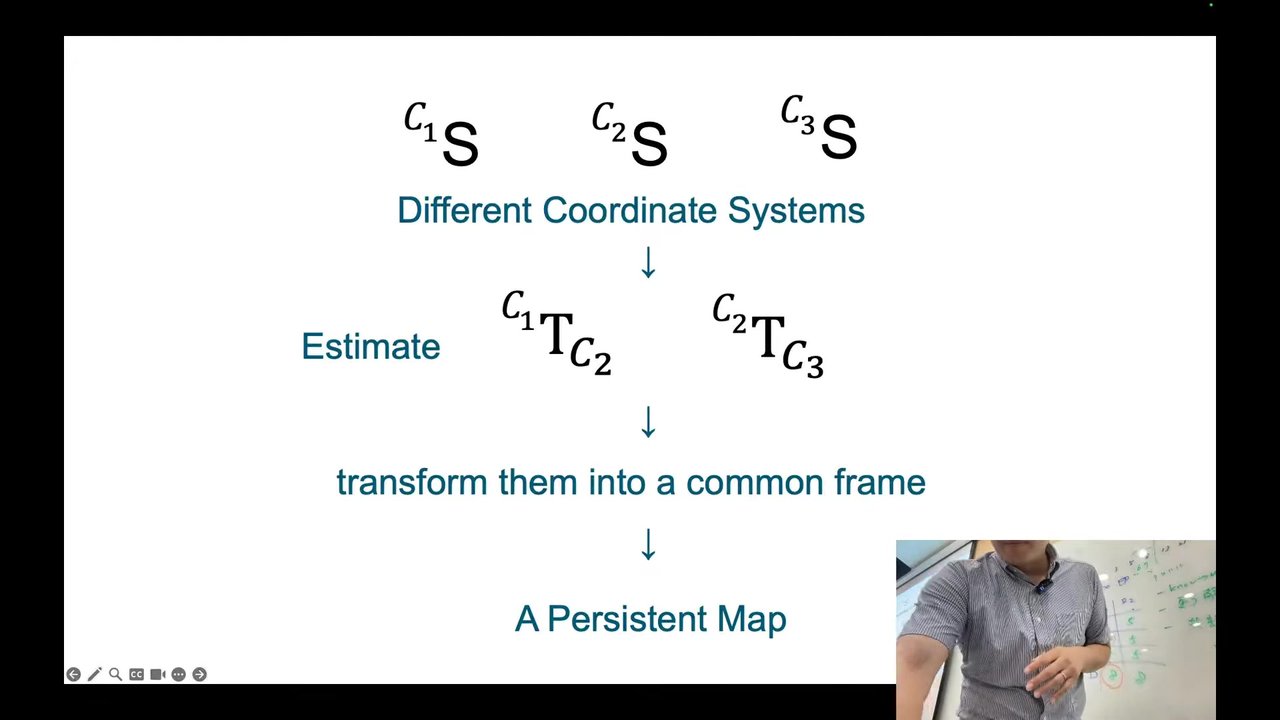
反投影給了三個 3D 觀測,但它們各自活在不同的相機座標系裡。要把它們拼成同一個物理空間,就要估計相鄰座標系之間的轉換,再全部轉到一個共同座標系。共同座標系選哪一個都可以,例如 C1;只要知道彼此之間的關係,就能轉到任何你想要的座標系。
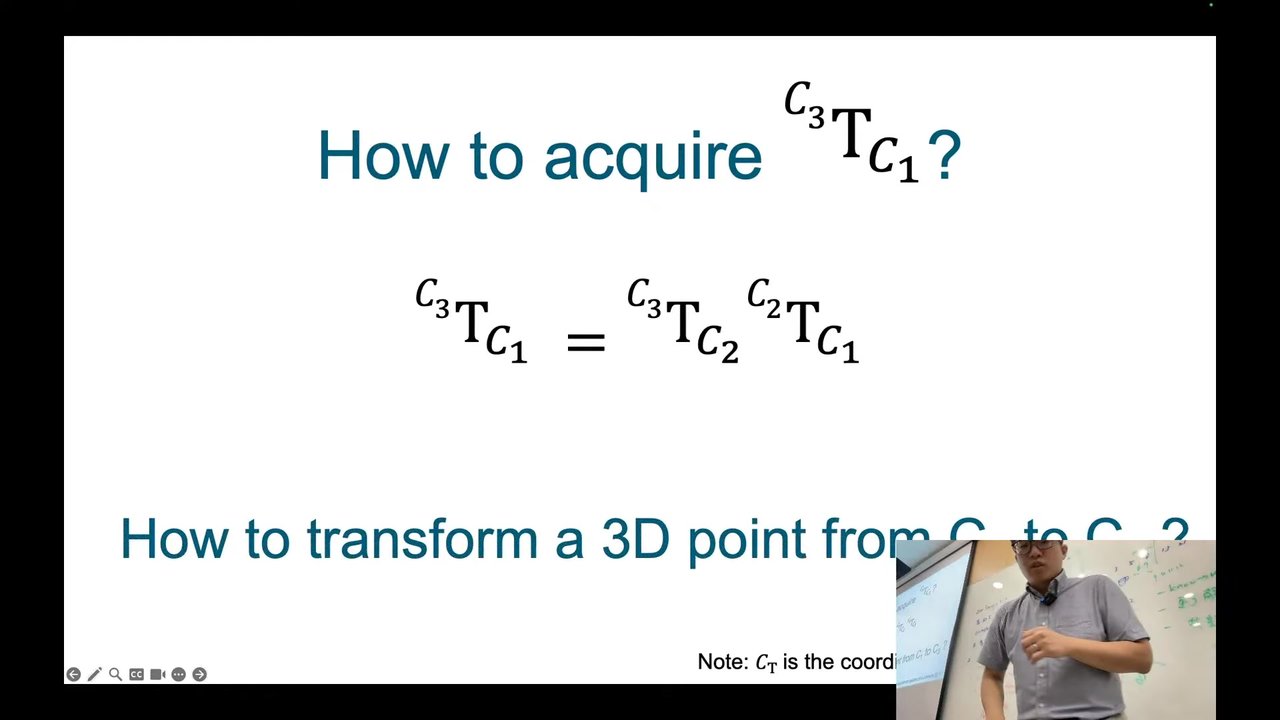
數學上很直接:C1 到 C3 的轉換,就是 C1 到 C2、再 C2 到 C3 兩個轉換矩陣相乘;實際上每一段都要估計,怎麼估計是另一個故事。講者因為時間不夠,把估計方法留到下週(或另外錄一小段),以免大家更混亂。
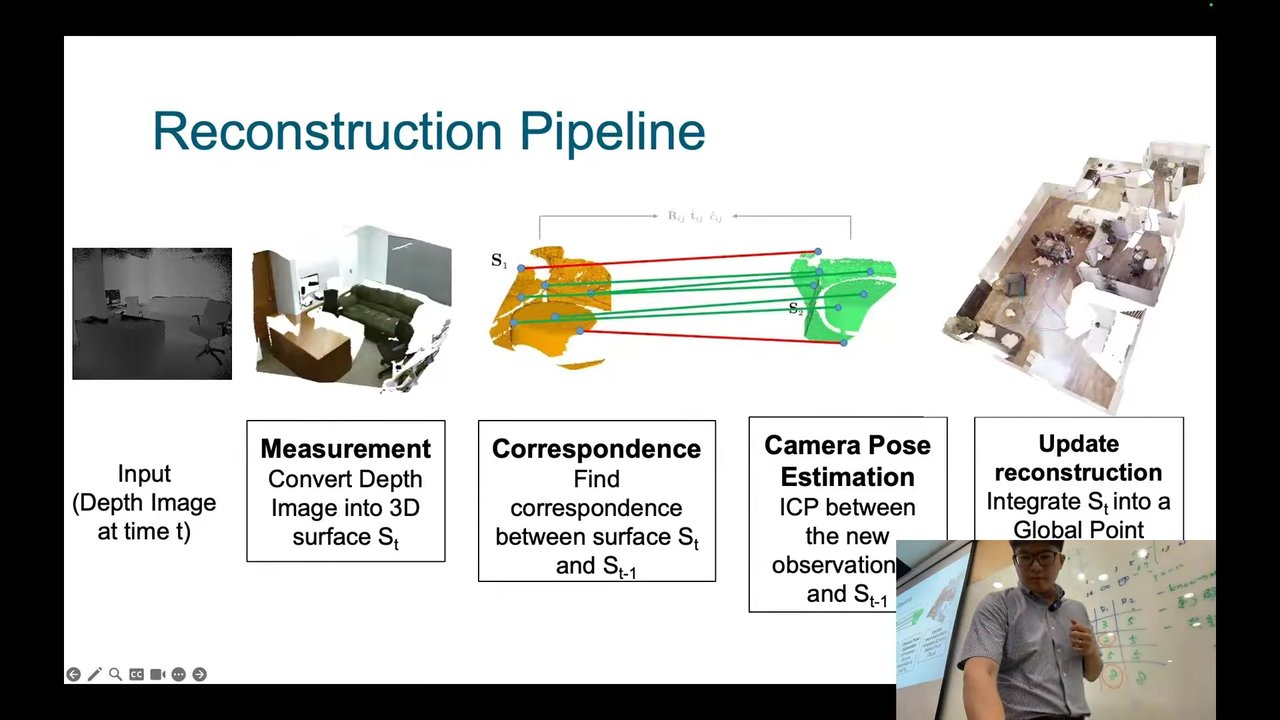
作業一就是把這些步驟走一遍:把深度影像轉成表面、估計前後兩個表面之間的轉換、把所有表面合併成一個大點雲。估出所有轉換矩陣,也就得到了底層的運動;有了運動加上表面幾何,就能合併出持久的世界。回到 UMI:它真正需要的只有這些轉換,因為目標是擷取軌跡;但要建出那條流程,前面這些基礎缺一不可。
漂移與迴路閉合:SLAM 不只是估計下一個姿態
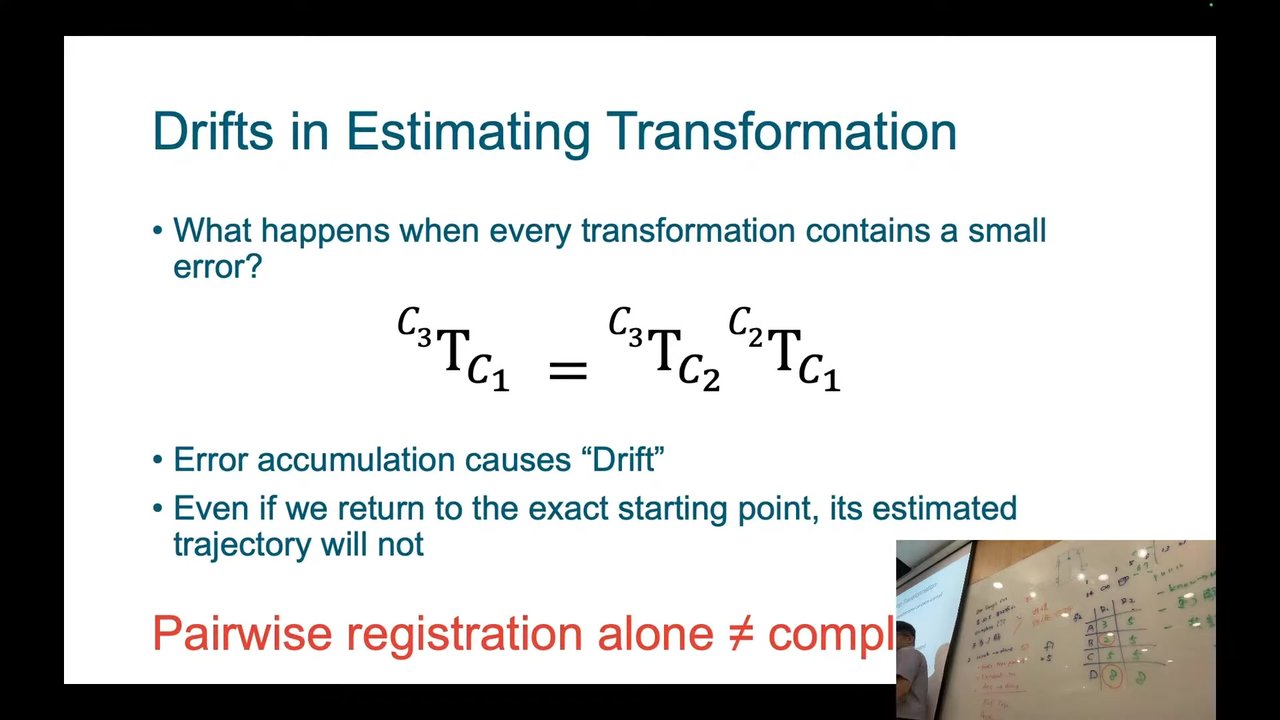
每次估計的轉換矩陣都會有一點旋轉誤差、一點平移誤差;串乘起來,誤差就一路累積。拿著裝置繞房間一圈回到原地,估出的軌跡終點卻可能落在旁邊。每一段的誤差也許很小,放到整個重建上就是大問題,這在真實世界非常常見。
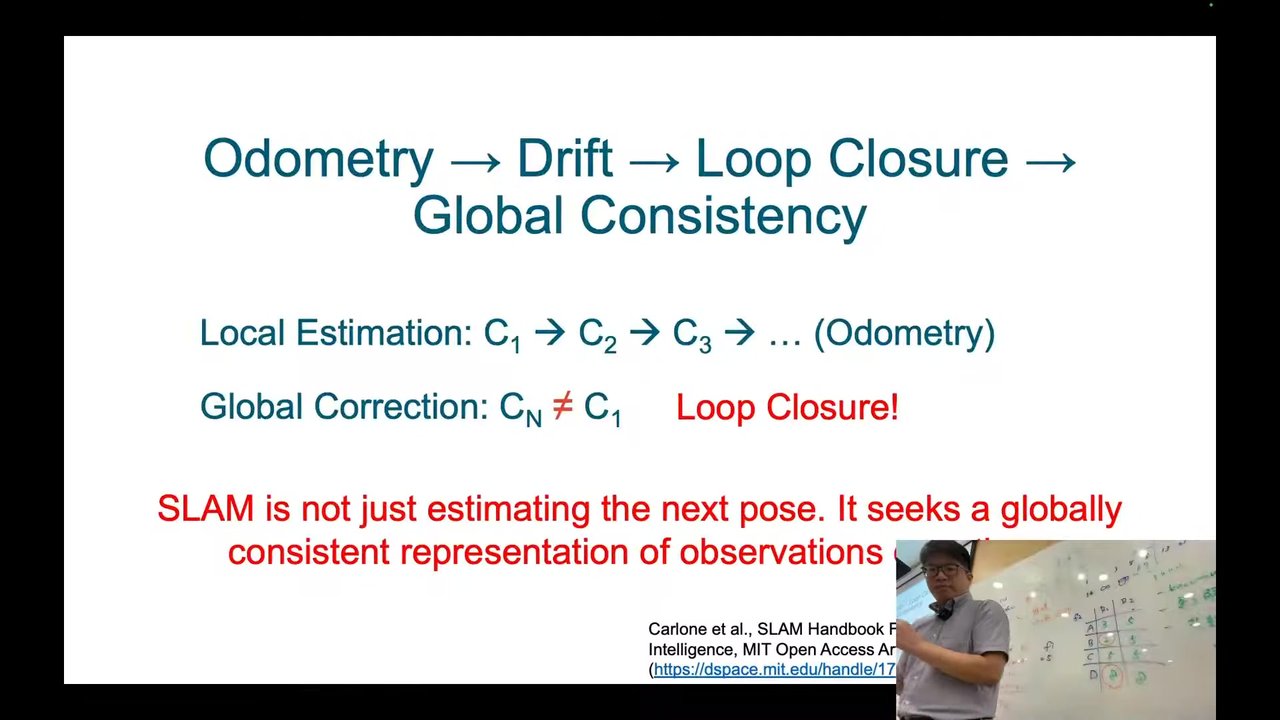
只估計相鄰兩幀之間的轉換,叫做里程計估計,作業一做的就是這個,而它一定會漂移。要成為完整的 SLAM,還需要迴路閉合:回到同一個地方時,同一個點就該是同一個點。講者說這套流程另一個重要的觀念是:只依賴線上、循序的資訊做決策,結果就會漂移;所以旁邊永遠平行跑著一條檢查的路線,不斷確認自己有沒有漂移、該回到同一點時有沒有回到,沒有就要修正。
總結與下一講:沒有深度時怎麼辦?
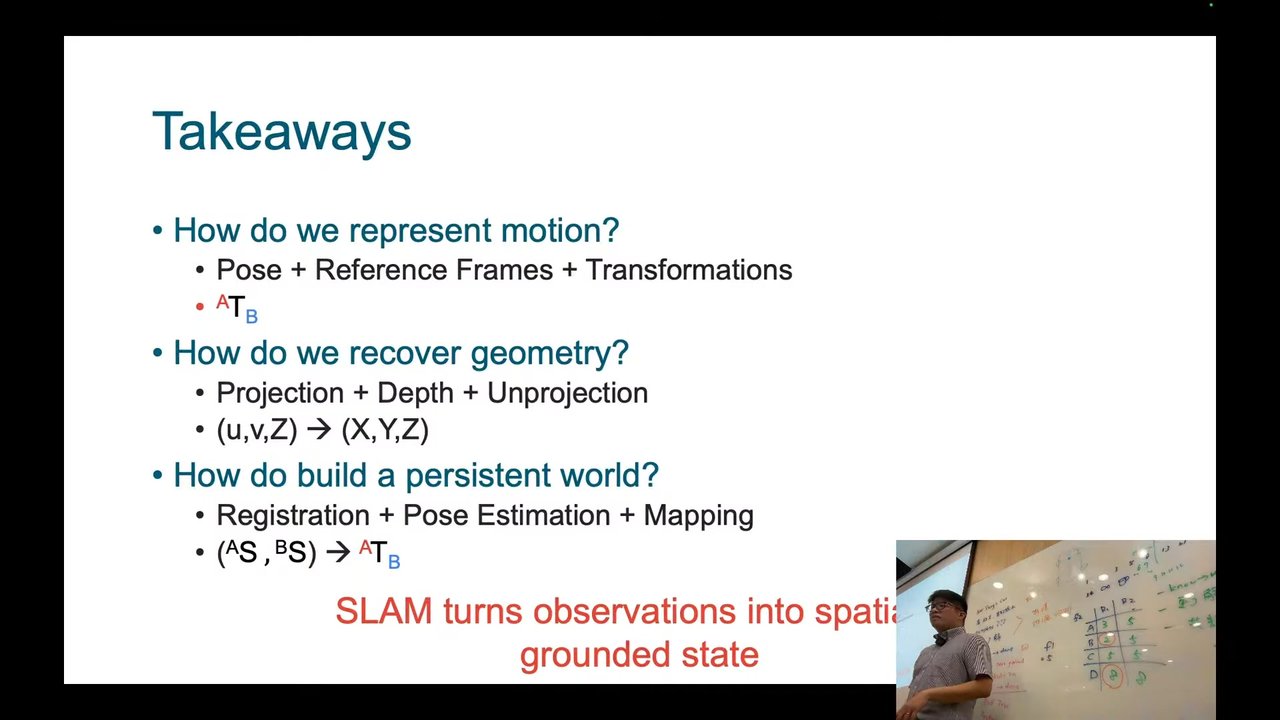
三個模組歸結起來:用姿態、參考座標系與轉換矩陣表示運動;用針孔相機模型加深度做反投影,還原幾何;用配準、姿態估計與建圖,把不同座標系下的表面放進同一個表示。講者推薦 Hartley 與 Zisserman 的經典教科書《Multiple View Geometry in Computer Vision》,也說這正是他走進電腦視覺的原因:四、五十年前的人只看著影像,就想出這麼優雅的方式,把凌亂的真實世界描述成抽象空間裡的形式。
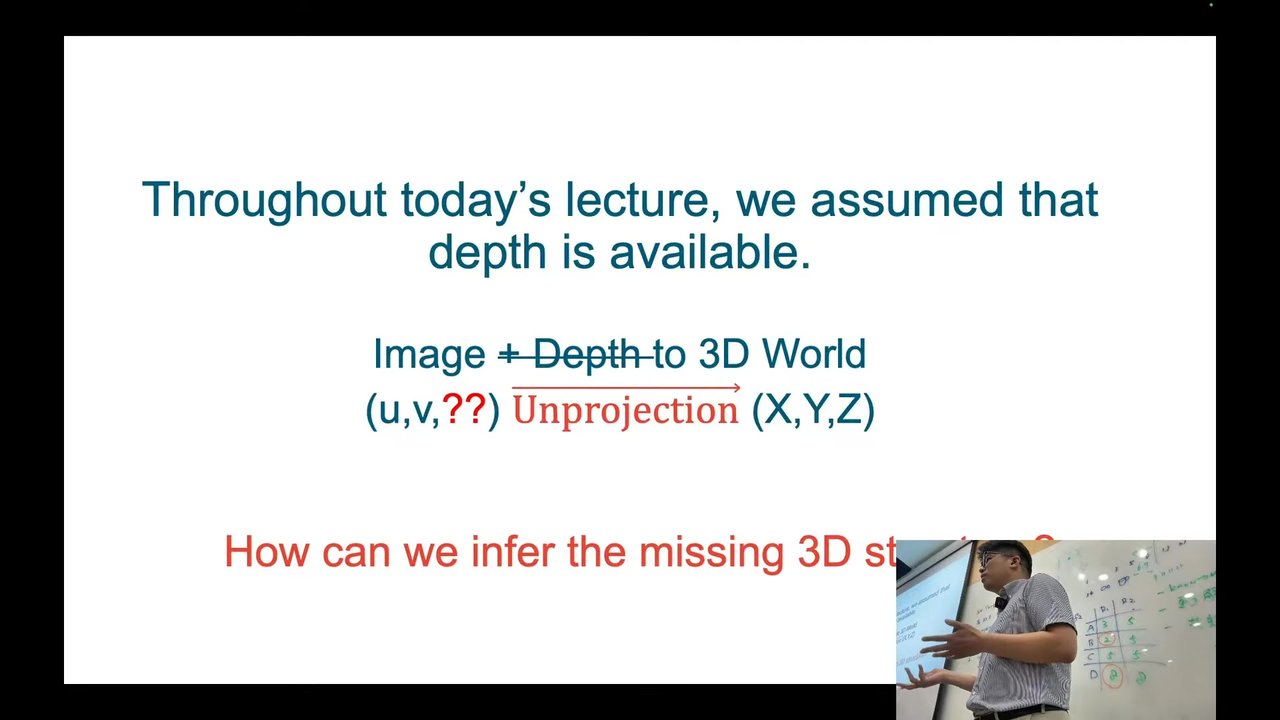
本講的前提是深度已知;拿掉深度、只剩 (u, v),要怎麼推斷缺少的 3D 結構?這是下一講「深度估計」的主題。作業一也正在改版:除了收資料、建模、估計轉換、重建世界,今年加入一個新目標——真實量測充滿雜訊,會造成或大或小的誤差,要學會用系統化的方法診斷哪裡出錯,再改進重建結果。最後有同學問,資料飛輪中的評估環節是否該加入像作業一這樣的驗證步驟;講者說之後會談怎麼把作業一的概念放進這個流程。
這一講留下的三個問題
- 如果用 UMI 或手機錄一段示範,你會把「誰的姿態」定在哪裡——夾爪中心、相機,還是 IMU?這個選擇會怎麼影響後續的校正與機器人控制?
- 深度相機在反光表面回傳 0、在細桿邊緣把物體估得比實際寬,這些誤差會怎麼一路傳到點雲、轉換矩陣,最後變成軌跡上的偏差?
- 在你的應用裡,有沒有機會「回到同一個地方」來做迴路閉合?如果沒有,系統要用什麼方式察覺自己正在漂移?
內容整理自本專案 Lecture 5 影片及 YouTube 自動英文字幕;投影片截圖取自同一課程影片。繁中字幕已依台灣用語翻譯並通過格式驗證,專有名詞與數學符號依投影片與上下文校正,正式公開前仍建議人工複核問答與收音不清的片段。本講由每週排程自動整理上線。