快速掌握
本講核心:課程從「感知—規劃—安全驗證」轉進機器人操作(manipulation),但講者在動手講抓取之前,先花大半堂課問一個問題:robot learning 到底是什麼。他以剛從 CoRL 2026(機器人學習研討會)回來的見聞,加上自己實驗室做「舀食物」的研究,說明機器人操作為什麼難、學習方法能補上什麼、以及目前社群連「通用機器人」「zero-shot」該怎麼定義都還沒有共識。本講錄影在介紹完本週的學習地圖、剛要進入「物體與抓取的表示」時結束。
- 講者回顧上週的 Isaac Sim:課程專題選擇「數位版場域加上實體機器人代理」,讓全國的修課者都能進得去,數位環境是通往實體部署的橋梁。
- 第 9 講的重點被濃縮為:先寫下預期用途與規格,再把它轉成功能、邏輯、具體場景,最後解讀證據;失敗的根本原因分析仍是進行中的研究。
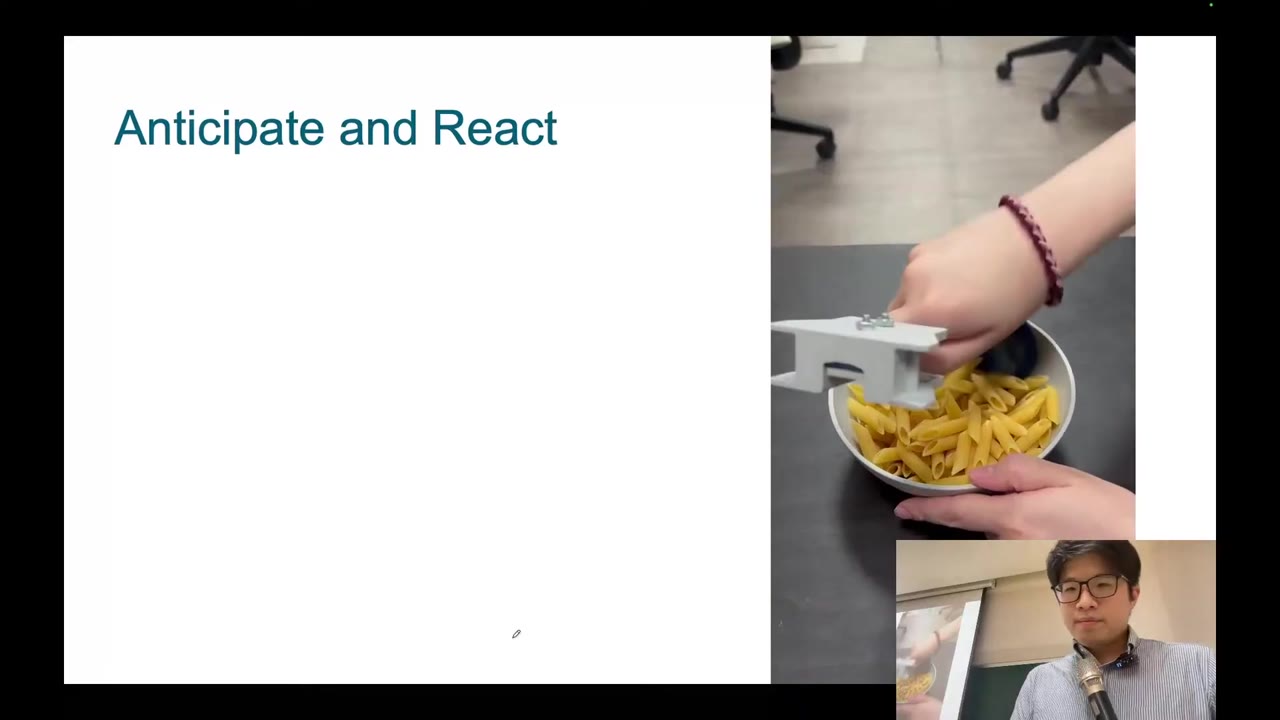
- 餵食機器人 Obi 沒有相機,只會執行編程好的動作,面對各式各樣的食物就力不從心;實驗室的做法是行為複製(人示範)加上主動感知(先攪一攪再舀),之後再用擴散策略與「預判並反應」處理灑出。
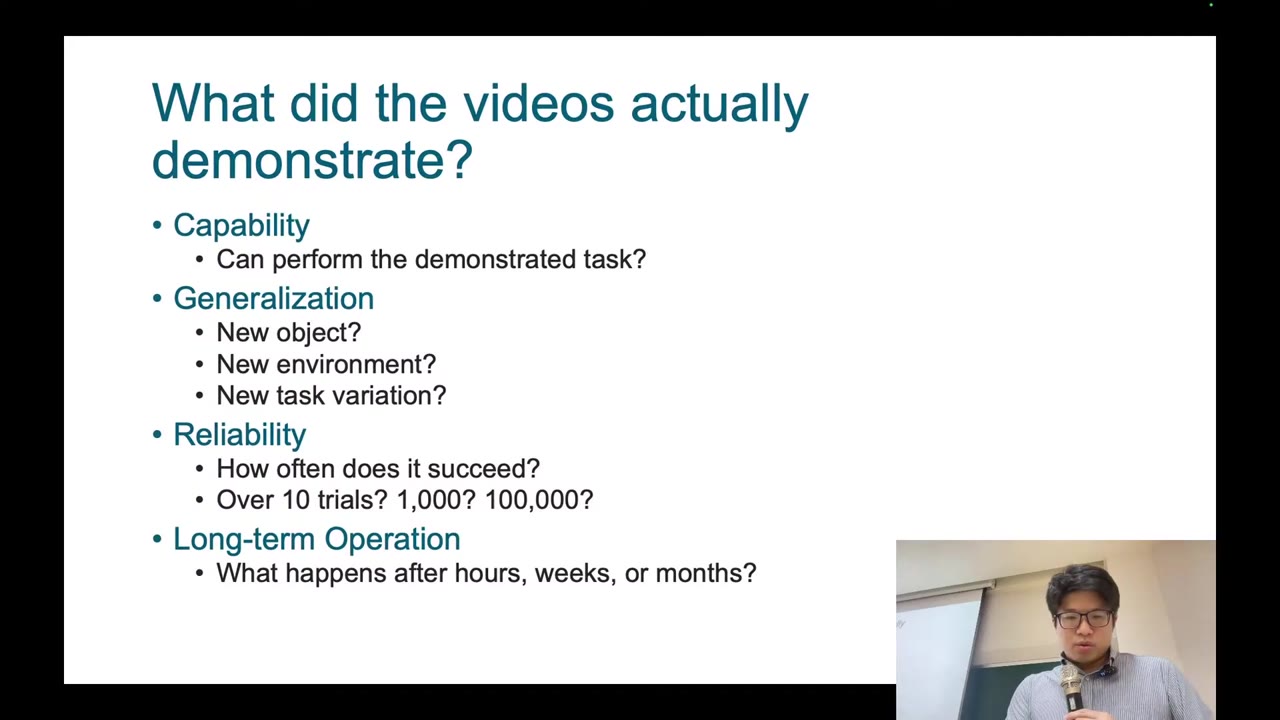
- CoRL 十年來從約 200 人長成約 4,000 人,操作與 VLA 是最大主題;講者提醒,看到 Astra、Fable 的示範影片時要追問「到底示範了什麼」:能力、泛化、可靠度、長期運行是不同層次。
- 回到本質:robot learning 是機器人學與機器學習的結合,必須先知道傳統機器人學怎麼處理「任何指令」,才知道學習究竟補上了什麼,而不是一頭栽進 VLA 之類的熱門方法。
開場與上週回顧:用數位版校園當橋梁
看老師講解(1:33)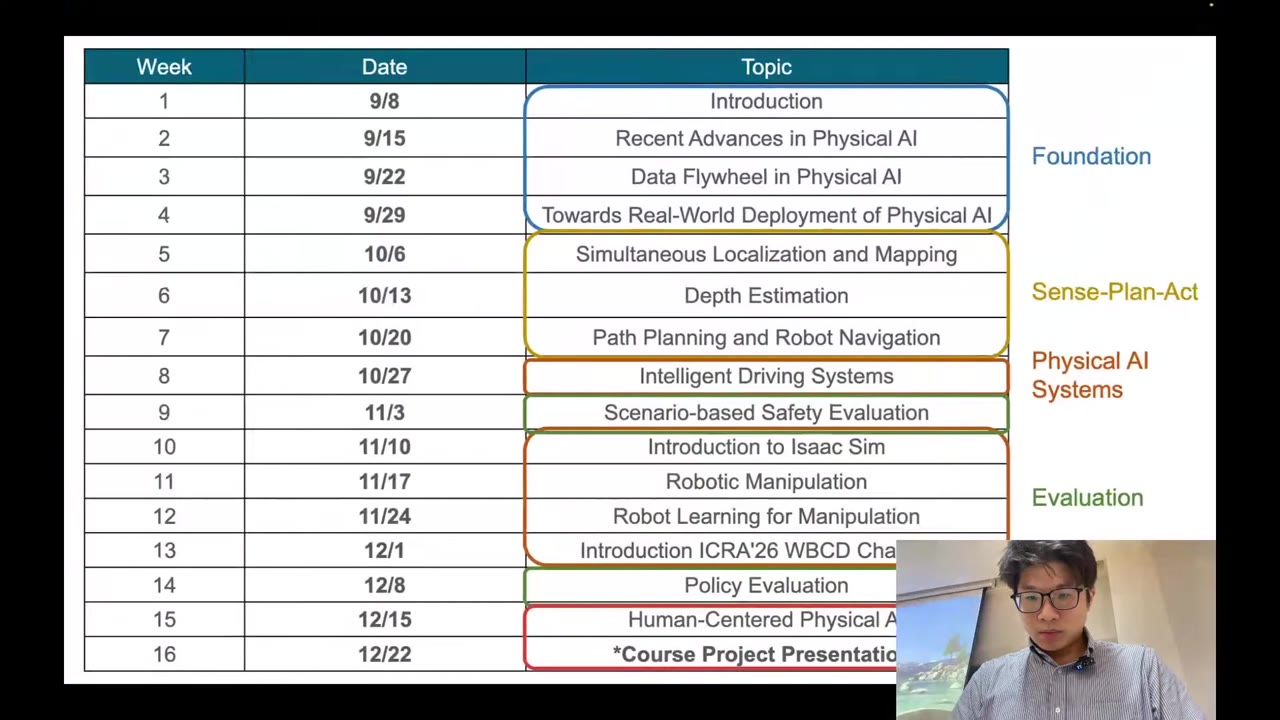
課程因教育部到系上做三年一次的評鑑而延後。講者先提到上週來賓介紹的做法:只用幾張照片就重建出教學場域的數位版本。傳統上要有人量尺寸、設計空間、手動設定反光等物理屬性,非常耗時;來賓的示範顯示照片重建已有初步能力,但要完整捕捉反射等物理特性仍有一段距離,「看起來不錯不代表能完美重建」。
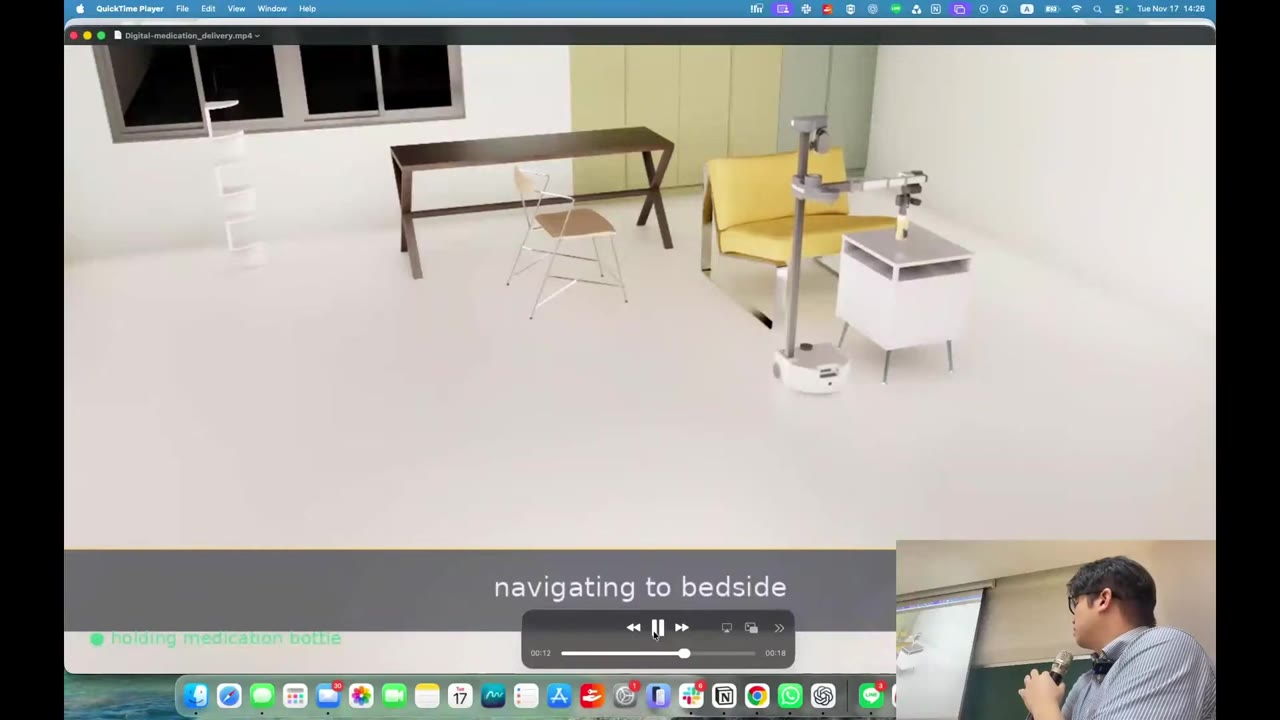
講者說明課程為什麼選擇「數位版場域,再把實體代理放進去」:全國的修課者很難都到現場,但都能進入數位版;在數位環境裡讓代理運作之後,再到實體場域嘗試部署同一個想法。數位版因此是讓大家站在同一起跑線的橋梁。他也預告,兩、三週後的課程會到系上的實體場域上,現場操作真正的機器人。
回顧第 9 講:預期用途、規格與場景式驗證
看老師講解(10:42)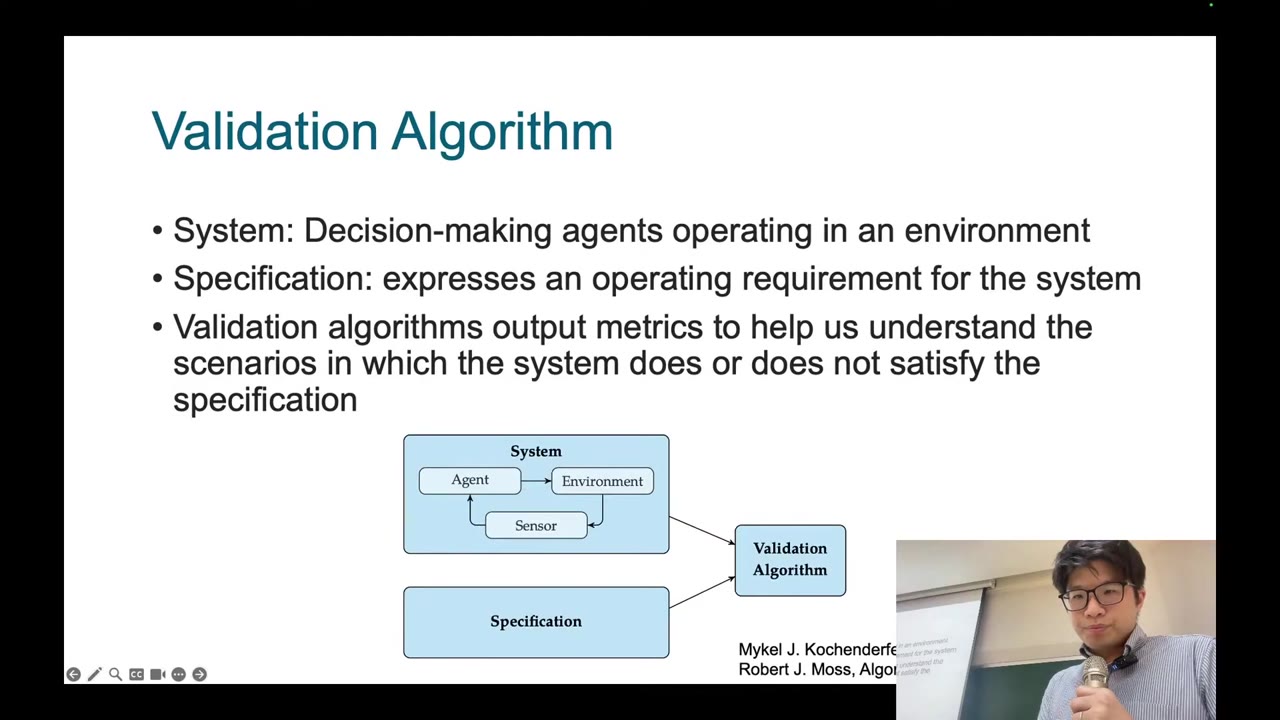
講者用三件事重述上週:一,必須先定義想做什麼,包括預期用途、安全需求、驗證與確認;二,如何把預期用途設計成場景式測試,也就是功能、邏輯、具體三種場景;三,如何解讀結果,最後得到「這個代理有多安全」的證據。驗證演算法有三個成分:系統(例如要部署去導航的決策代理)、規格(到達目的地且不碰撞、一秒內到達、遇到行人要閃避,甚至要符合社會規範)、以及輸出的指標。
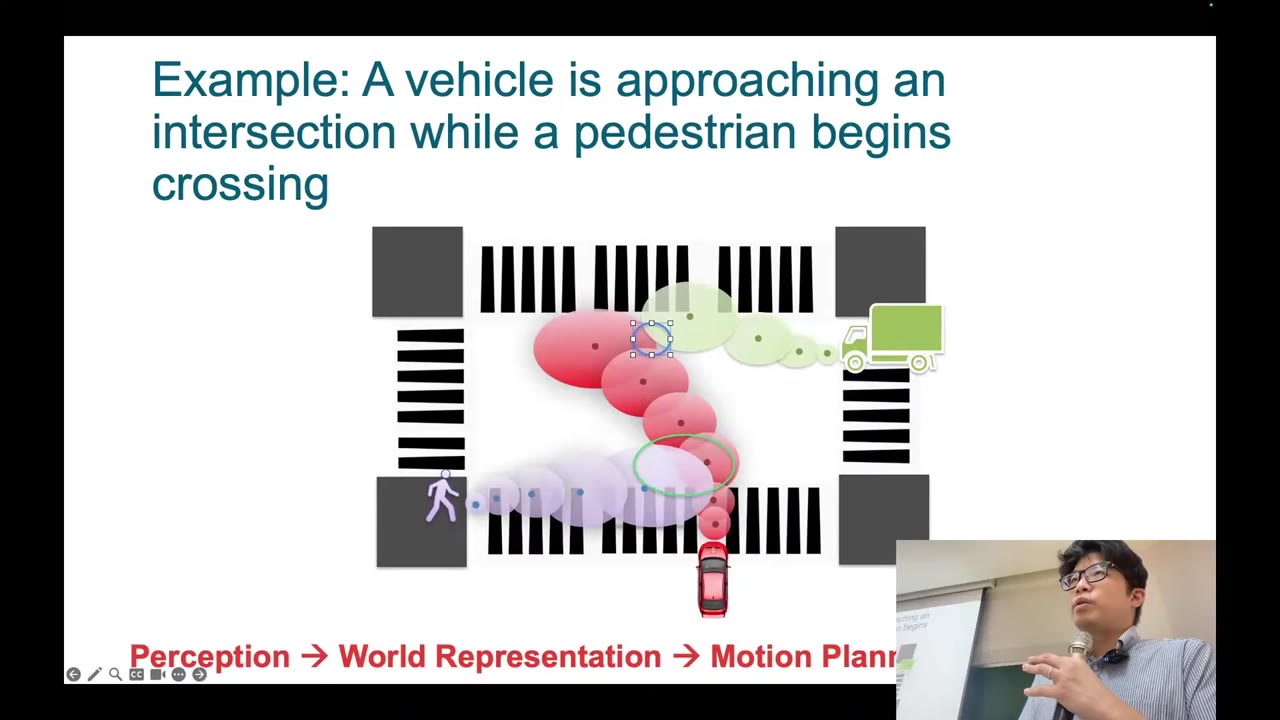
V 模型提供系統化設計需求並驗證所做系統的方法。講者上週用同一個路口與行人的例子示範,這次不再細講,請想自己設計這類系統的人回頭查看。
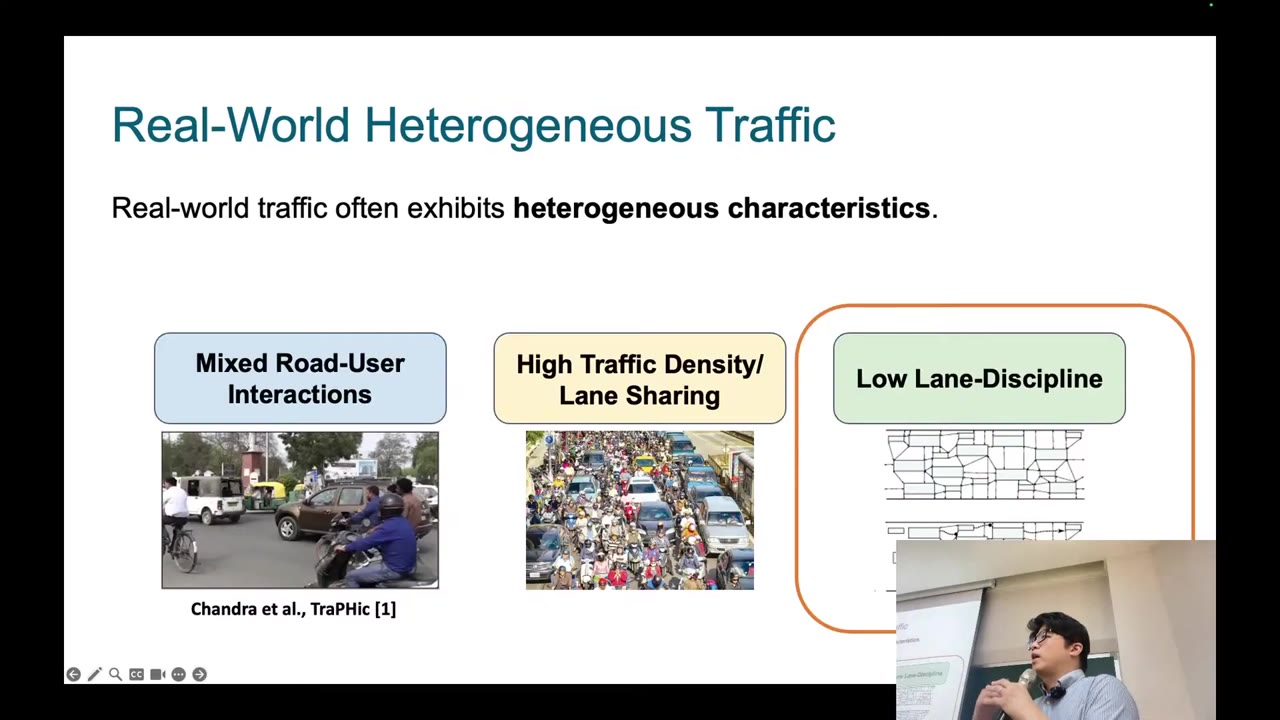
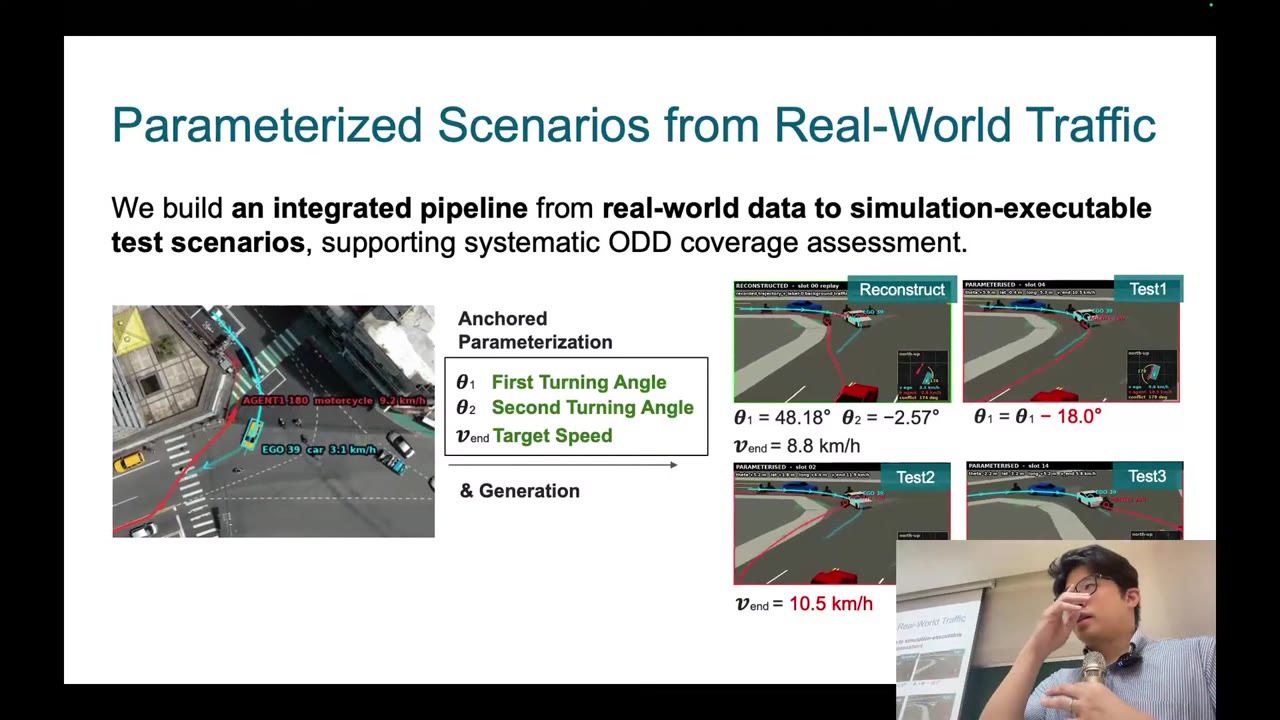
講者的結論是:定義預期用途,接著定義對應的需求,再用真實異質交通的例子建出可執行的測試。這套場景式驗證建立的是「系統何時、何處滿足需求」的證據;但失敗發生時,要怎麼分析根本原因,目前還沒有方法,那是實驗室正在做的工作。接著他轉進另一個物理系統:機器人操作。
為什麼先講 CoRL:「robot learning」是什麼意思
看老師講解(16:33)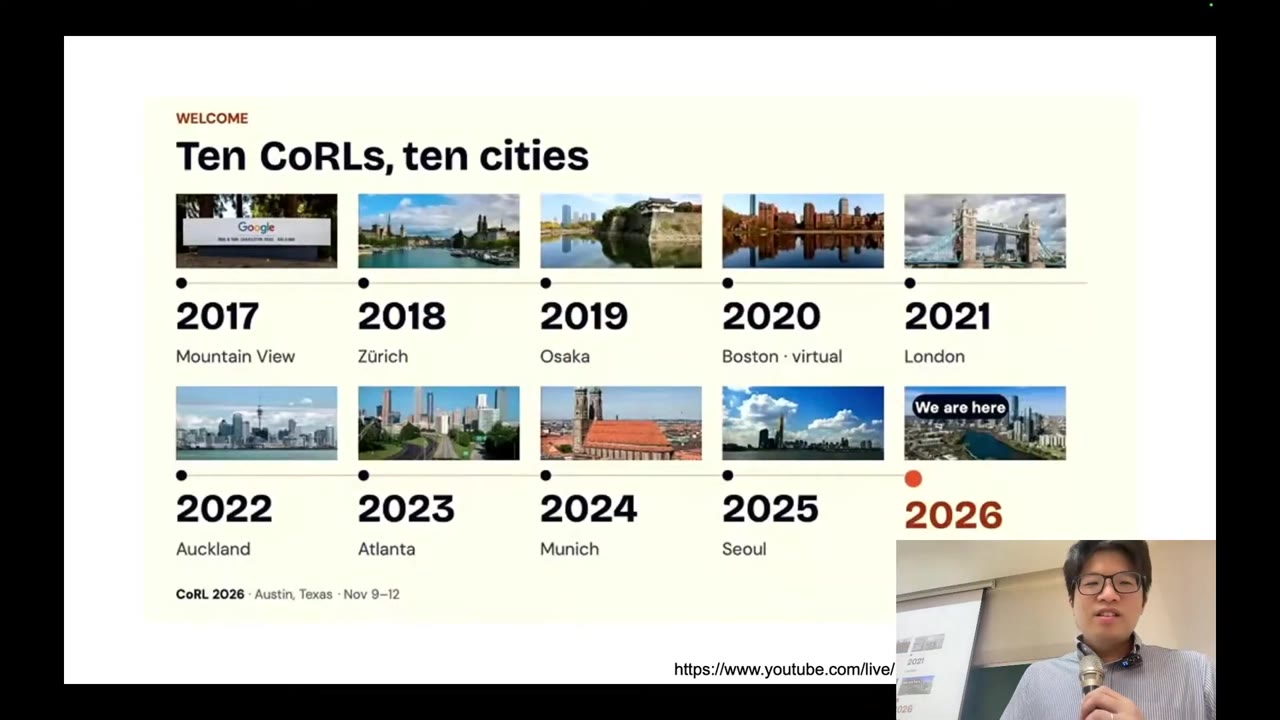
在進入操作之前,講者先分享上週參加的 Conference on Robot Learning(CoRL)。他先問在場有多少人聽過這個會議,只有少數人舉手;接著要大家把名稱拆成 robot 與 learning 兩個字,想想它們合在一起是什麼意思,並說「答案我現在先不講」,下半場才回來談。
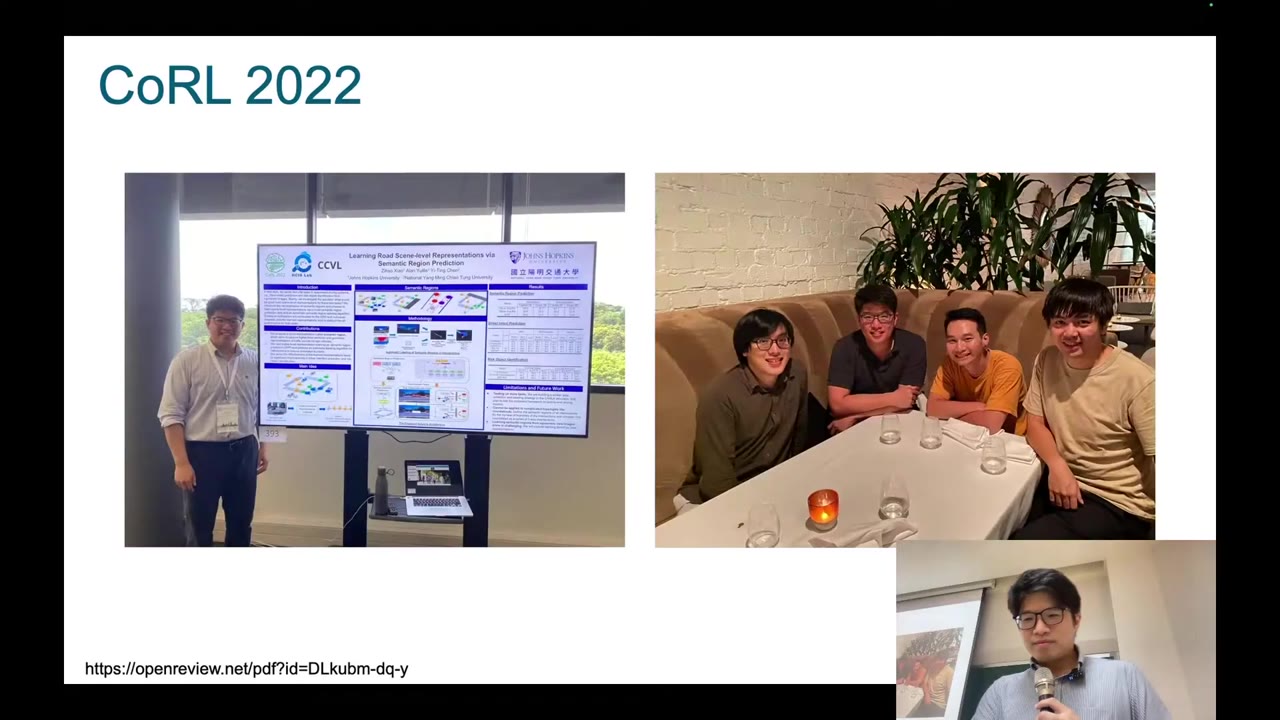
講者從 2017 年就知道 CoRL,因為他本來就身在這個領域,但第一次參加是 2022 年,當時有一篇論文並做了報告。那一年台灣出現在現場的只有他一人(其他三位台灣人都在美國)。他的老本行是自駕,但那年已經發現多數人談的是機器人操作;他自己在 2021 年回台灣後開始做操作,實驗室學生的第一篇論文發表於 CoRL 2023。
舀食物實驗與餵食機器人 Obi:為什麼編程動作不夠
看老師講解(19:36)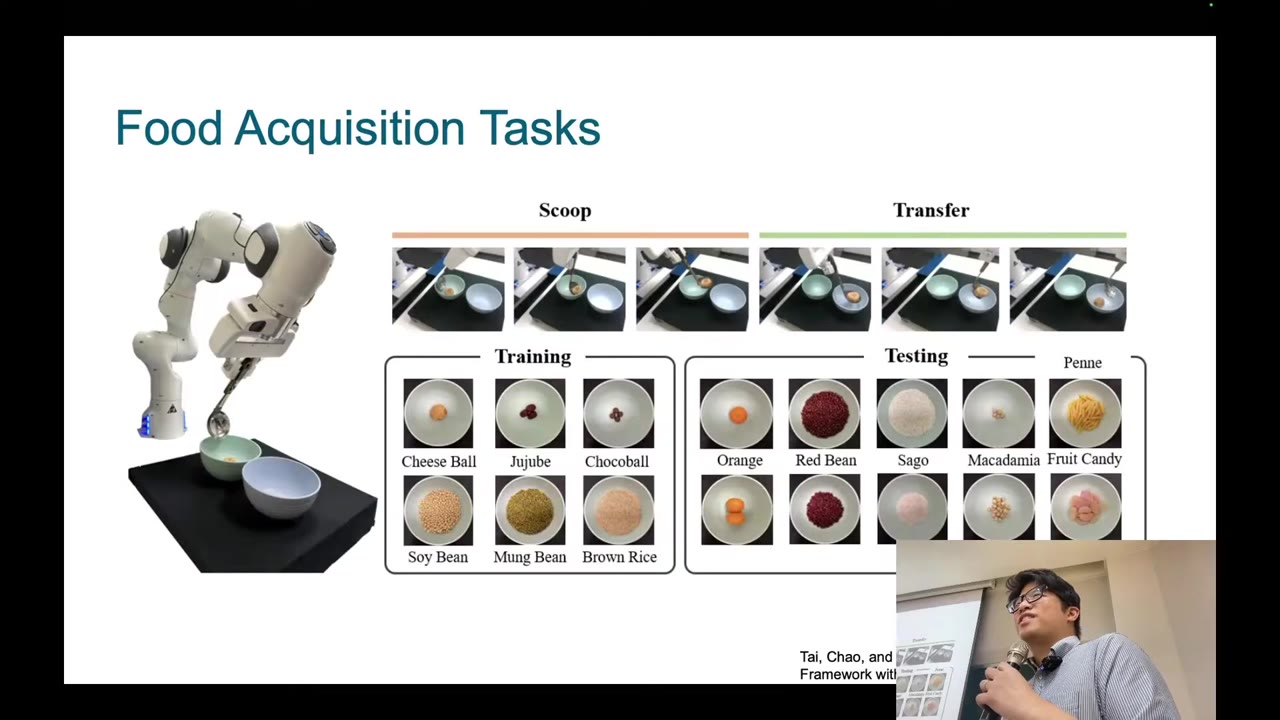
講者說明這個設定看起來不直覺,動機來自一台叫 Obi 的餵食機器人,它可以舀起食物餵給行動不便的人。他播放的影片裡,使用者有肌肉萎縮症,無法自己握湯匙,想靠這台機器獨立吃冰淇淋;但機器人把冰淇淋推開,即使舀起來,也是一大球冰淇淋送到面前,並不好吃。
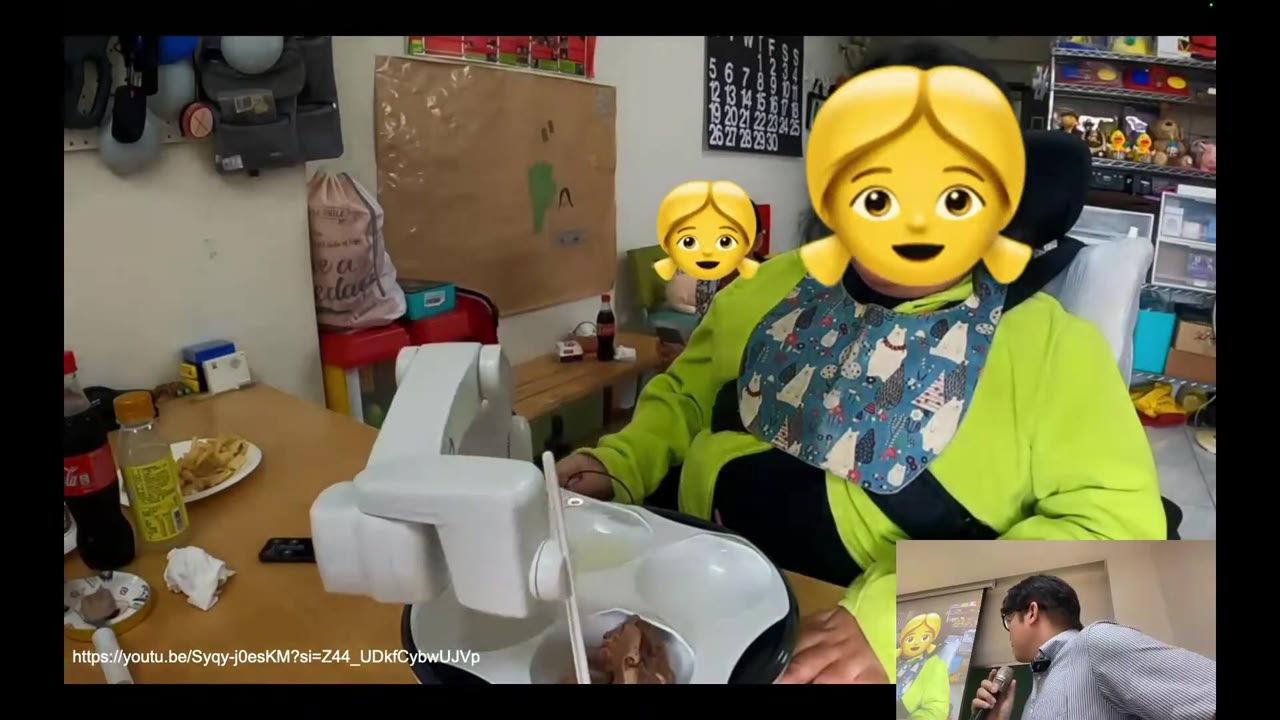
他讓聽眾猜原因。有人說盤子是固定的,也有人說冰淇淋很黏,講者接著揭曉關鍵:這台機器人沒有相機,只會做「編程好的動作」:移到左上角的盤子、做一個固定的舀取動作、再移到使用者附近。這是自動化的思路:如果食物永遠是同一種、切成同一形狀、擺在同一位置,就會有效;但真實世界裡每顆橘子大小不同、人也不會只吃一種東西。
行為複製與主動感知:先攪一攪再舀
看老師講解(27:00)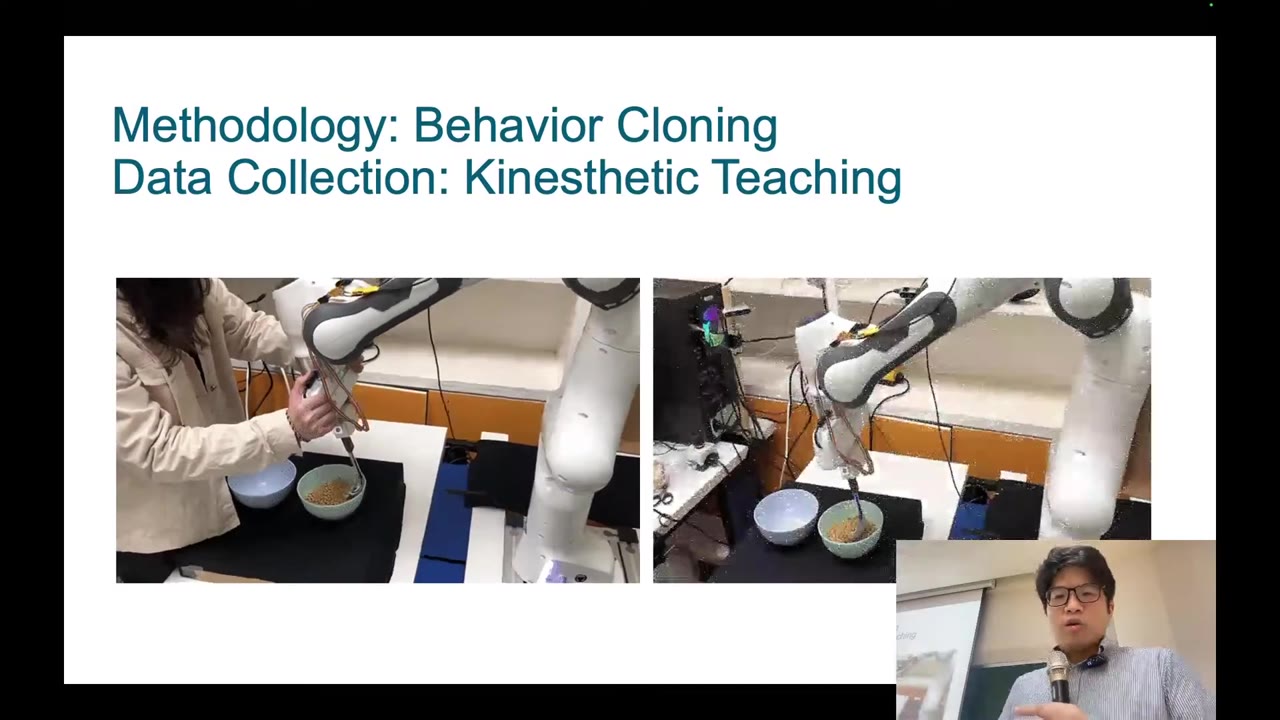
為了測試「加上相機或其他感測器之後,機器人能不能處理不同食物」,團隊採用行為複製:讓人示範如何舀橘子、如何舀各種豆子,目標是教完後機器人能舀不同的食物,而且最好能推廣到沒看過的食物。講者說行為複製會留到下週(11/24)再講。
難處與 Obi 一樣:每種食物有自己的性質,而且性質會隨時間變化;光看外觀不夠可靠。實驗室的想法是主動感知:在舀之前先與食物互動,這裡的互動是攪拌,先得到食物的特性,再去舀。講者指出這與日常生活相通:攪、搖、捏都是人用來掌握食物性質的互動。
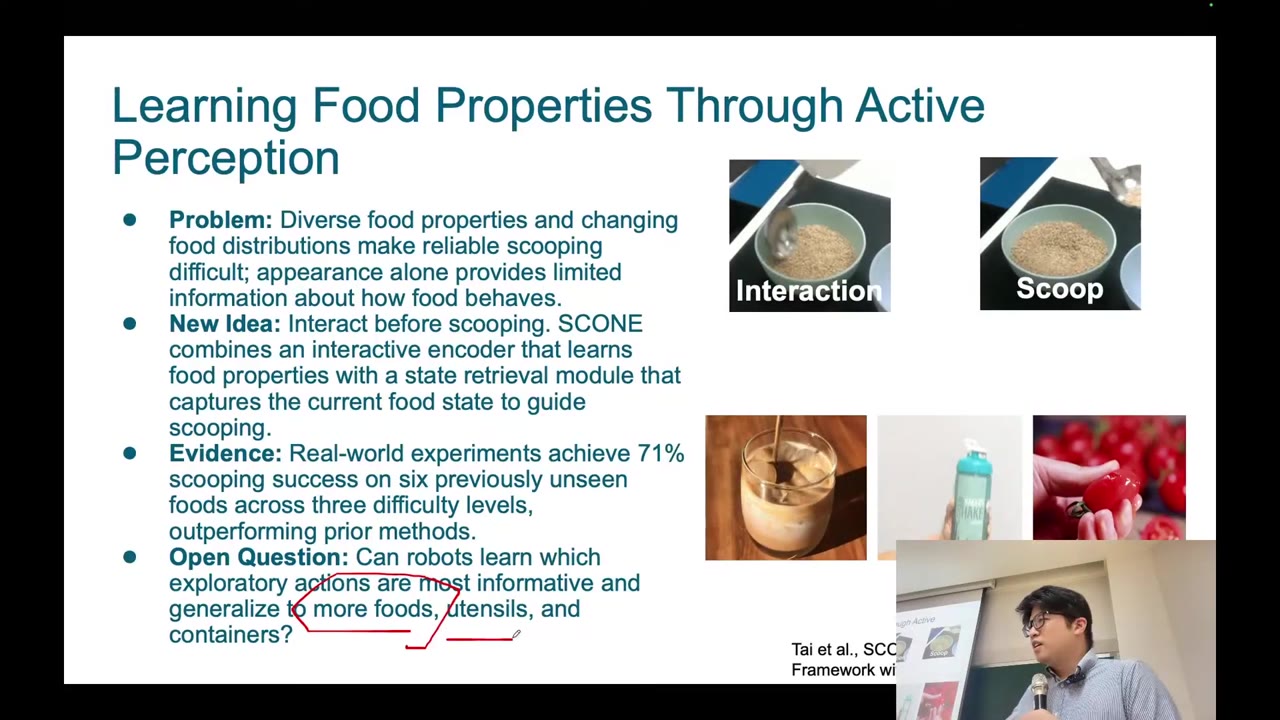
講者也坦白指出限制:只測了少數食物、只用一種湯匙與一個容器,換成更大或更小的器具、叉子,結果會怎樣仍未知;光是這個設定就已經很難。
擴散策略與「預判並反應」:會動作,但不會因應狀況
看老師講解(29:48)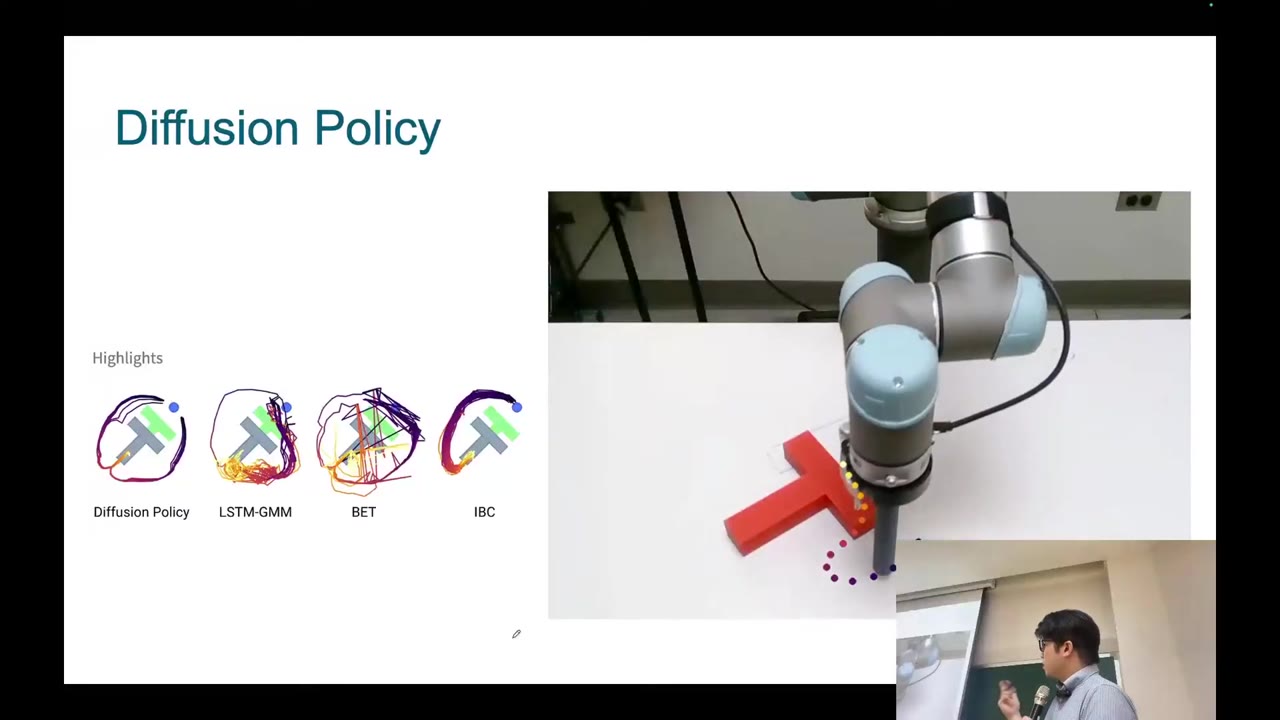
2025 年的延伸工作用了擴散(diffusion):它在生成式 AI 裡常用來生成影像,這裡用來生成動作。講者說擴散策略有許多好處,之後會再講。同樣的舀食物設定下,機器人能把動作做得不錯,但放置得不精準、灑出來。
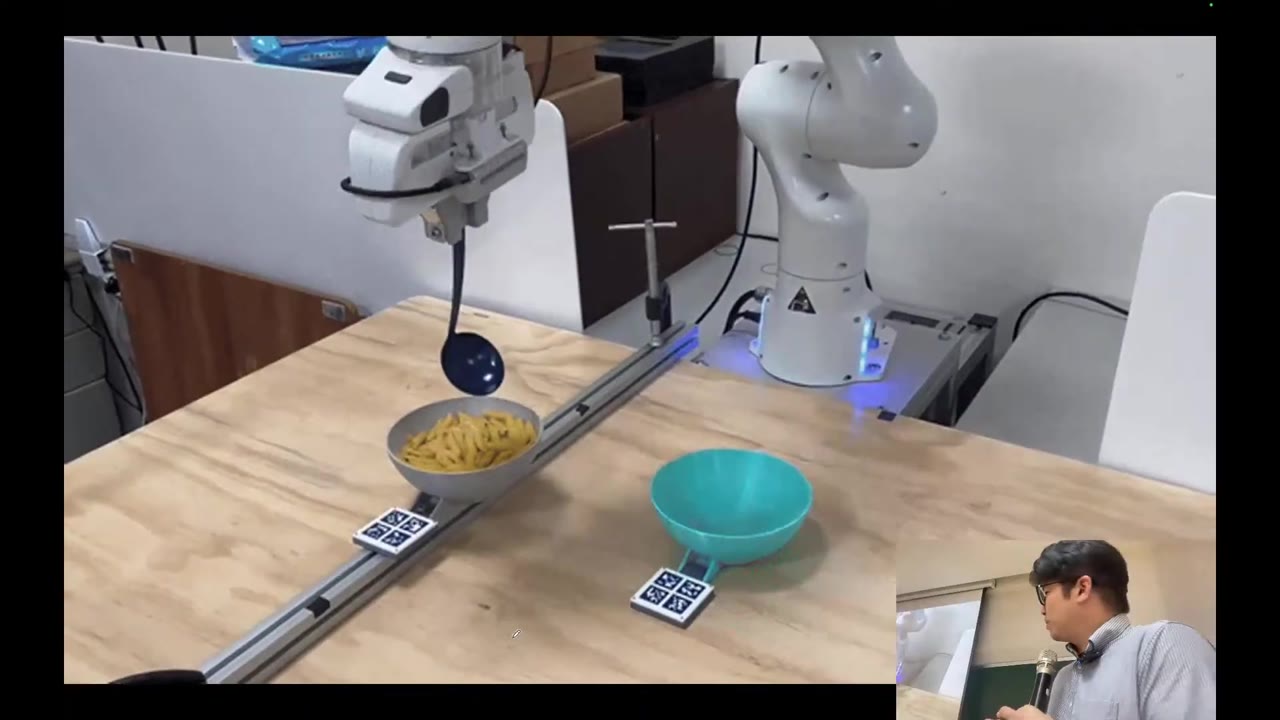
原因是它學到了行為,卻沒有適應當下的情況:訓練時碗裡沒有裝滿食物,測試時碗的位置又稍微改變,策略沒有正確調整。人在舀滿滿的食物時會很小心、做很細微的動作調整。於是團隊提出「預判並反應」:先預測「如果採取這個動作會不會灑出來」,會灑就調整。
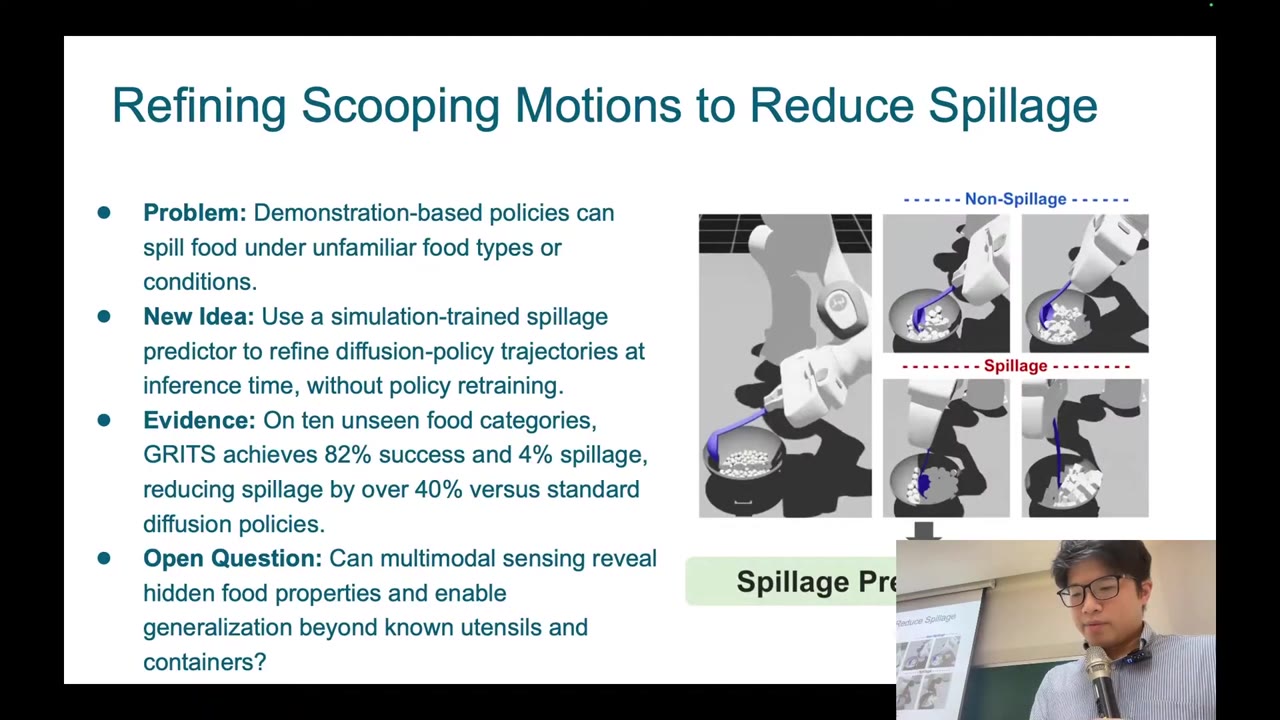
為什麼用模擬?因為在現實中收集失敗案例既痛苦又不舒服:每次失敗都要清桌子、把食物放回去、再收集一次,不像標註影像,錯了改一下就能往下走。結果模擬已經能提供不錯的近似,即使它還不夠好、也還不能模擬很多種食物。講者列出尚待解決的問題:食物性質太多、難以模擬與量測;一旦超出固定器具與固定容器,模型能不能處理,還不知道。
CoRL 2026 的規模、台灣的位置與關鍵字
看老師講解(36:12)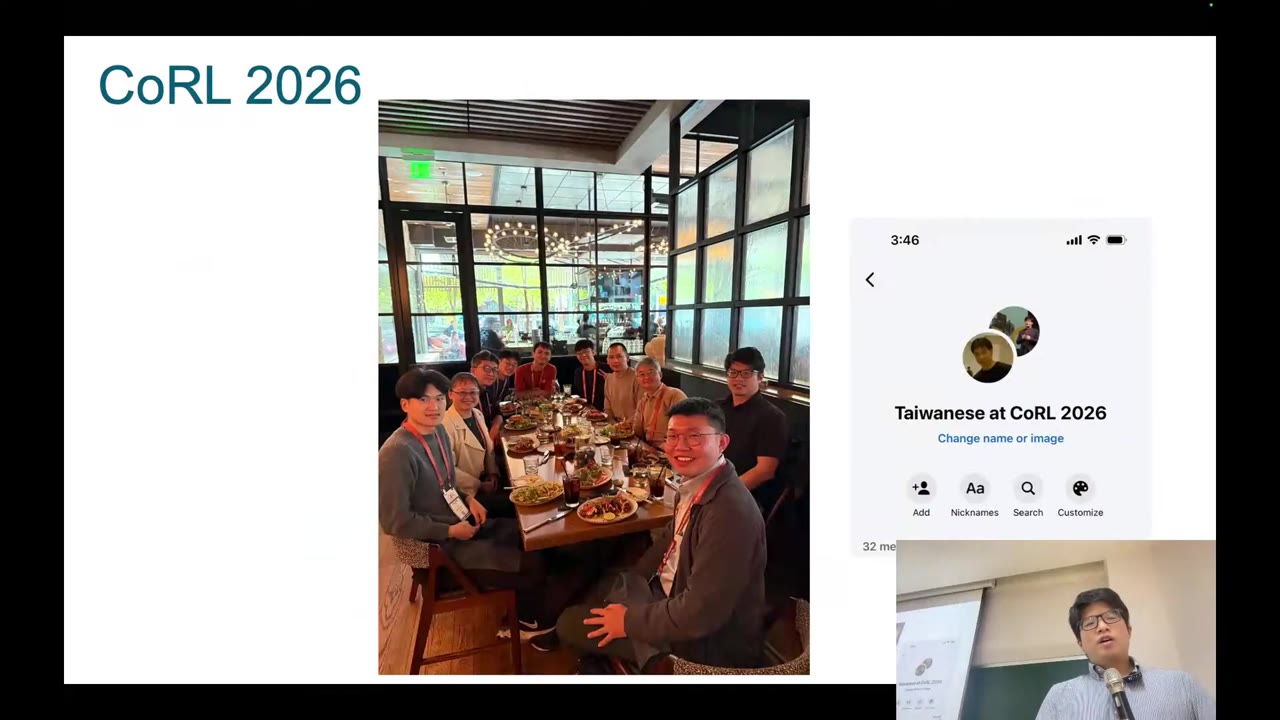
與 2022 年只有講者一人相比,今年台灣人多了很多,但在各國出席人數中仍偏少:排除主辦國美國與因簽證問題只有約 300 人出席的中國之後,韓國、日本、新加坡甚至香港都比台灣多。講者說,台灣是去年才開始加入這個方向,因為 NVIDIA 大力推動;但知道這個領域的人還是很少。
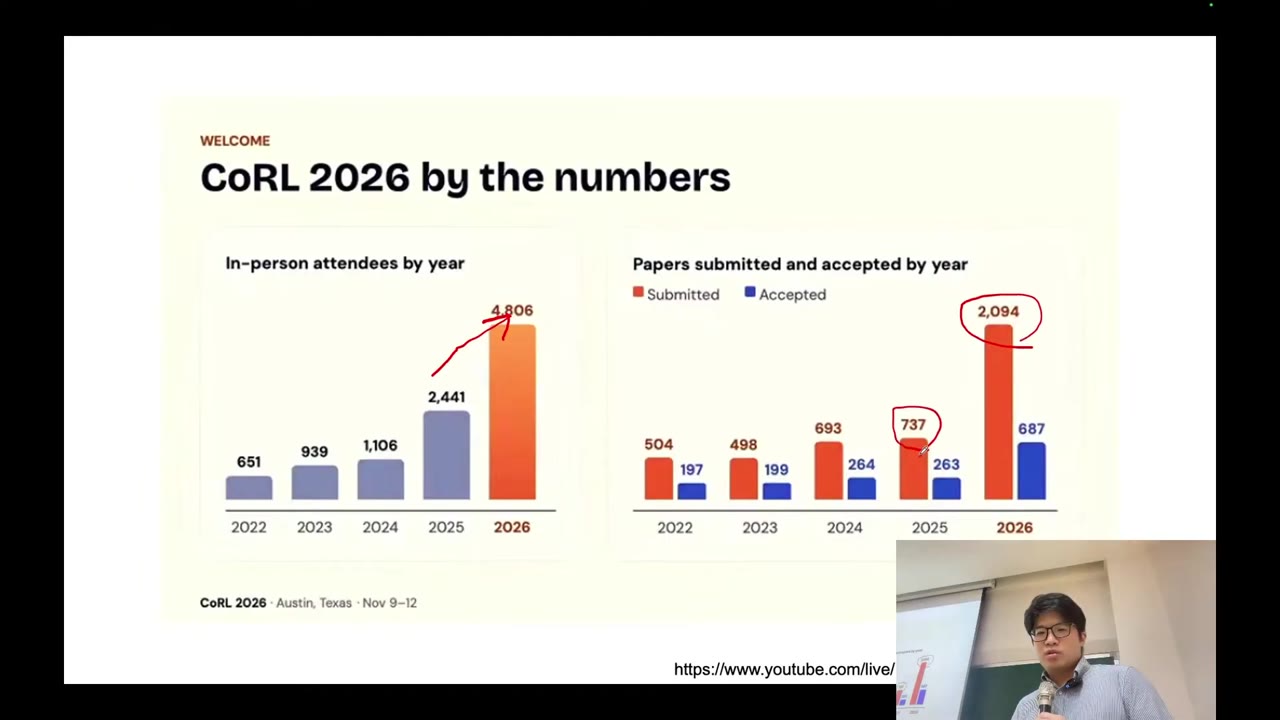
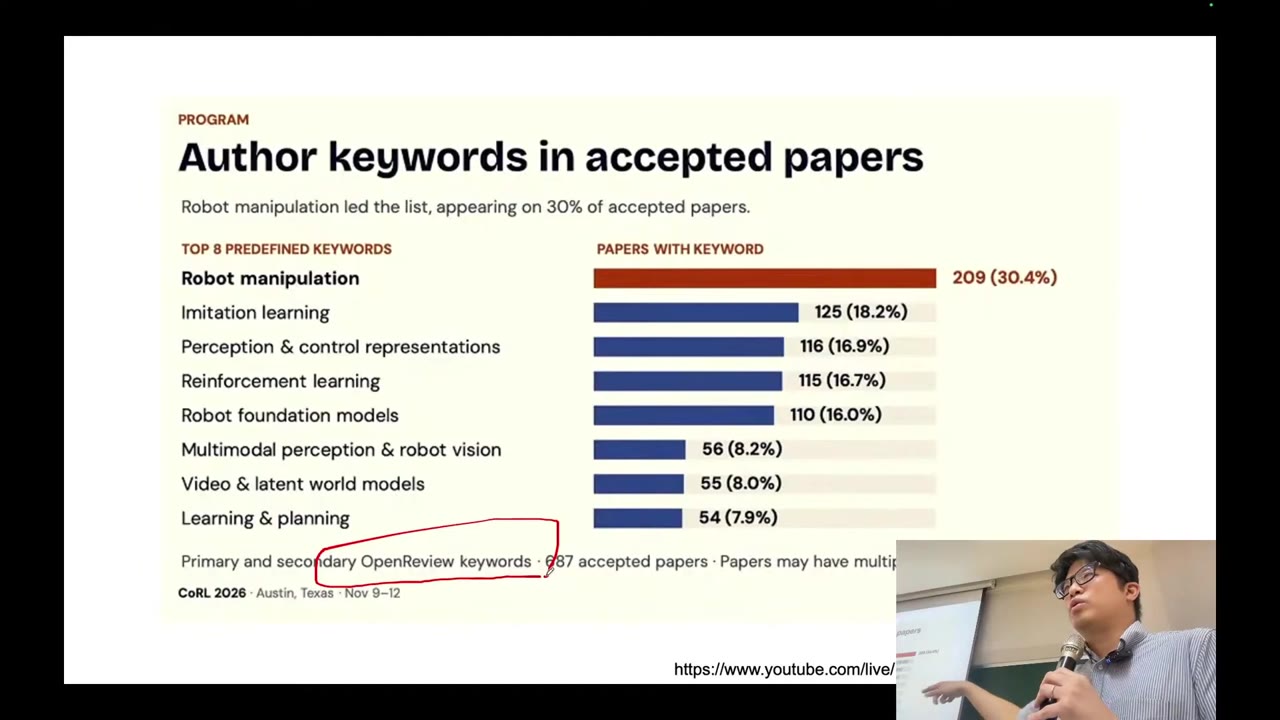
講者讓大家看最重要的關鍵字。主辦單位用 OpenReview(一個投稿與審查平臺,審稿意見事後公開,讓大家看到同行對論文的評論,也讓審稿人更用心)的關鍵字統計:機器人操作最大宗,其次是模仿學習、感知與控制表示、強化學習、機器人基礎模型等。
講者自己的做法是把錄取論文的標題丟給 ChatGPT 做成文字雲:最大的字仍是操作,但多了 VLA(視覺語言動作模型)、人形機器人、靈巧、抓取,放大看還有泛化、接觸、跨形體等。他建議有興趣的人去看 CoRL 的 YouTube 直播,所有演講與主題演講都有。
Astra 與 Fable:看到示範影片時要問「到底示範了什麼」
看老師講解(43:48)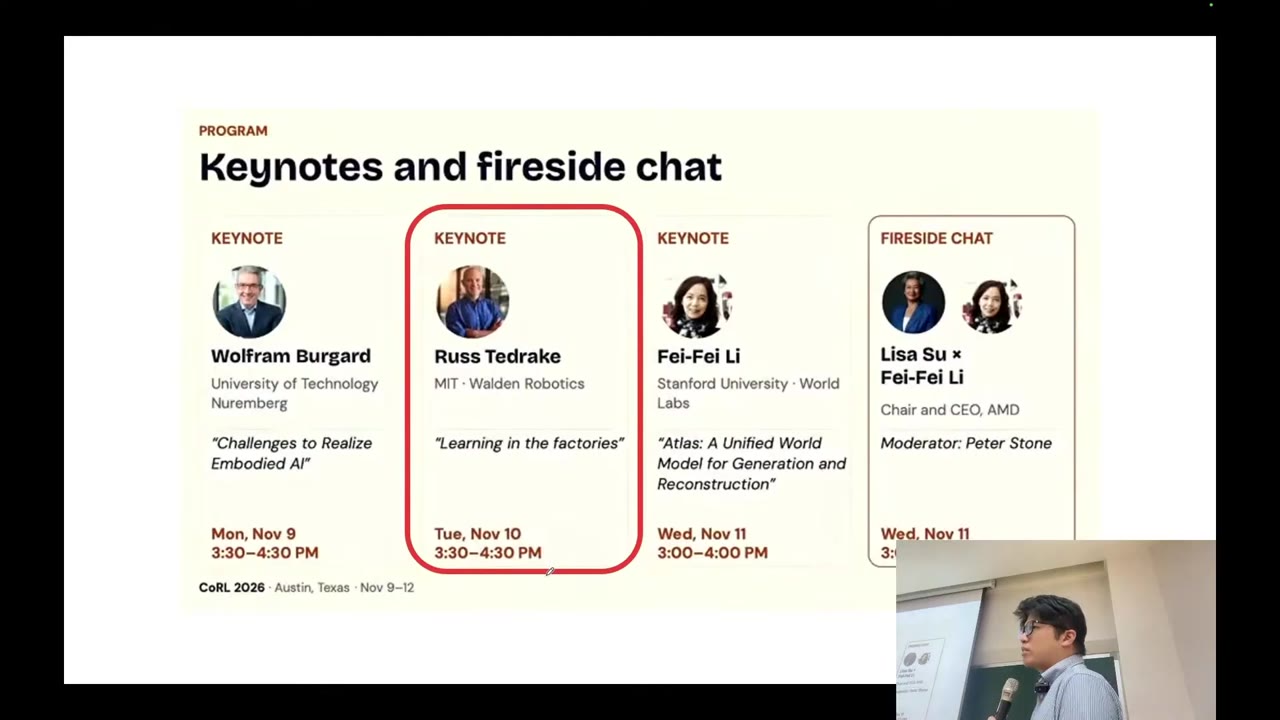
他先提到 Astra 與 Fable 這兩個代理,說它們對日常生活與機器人界都造成很大衝擊;會議裡有好幾次有人提出「我們該擔心嗎」「我的工作會被取代嗎,還是我什麼都不用做」。講者說他們認為要想想怎麼看待這兩個東西的進展。
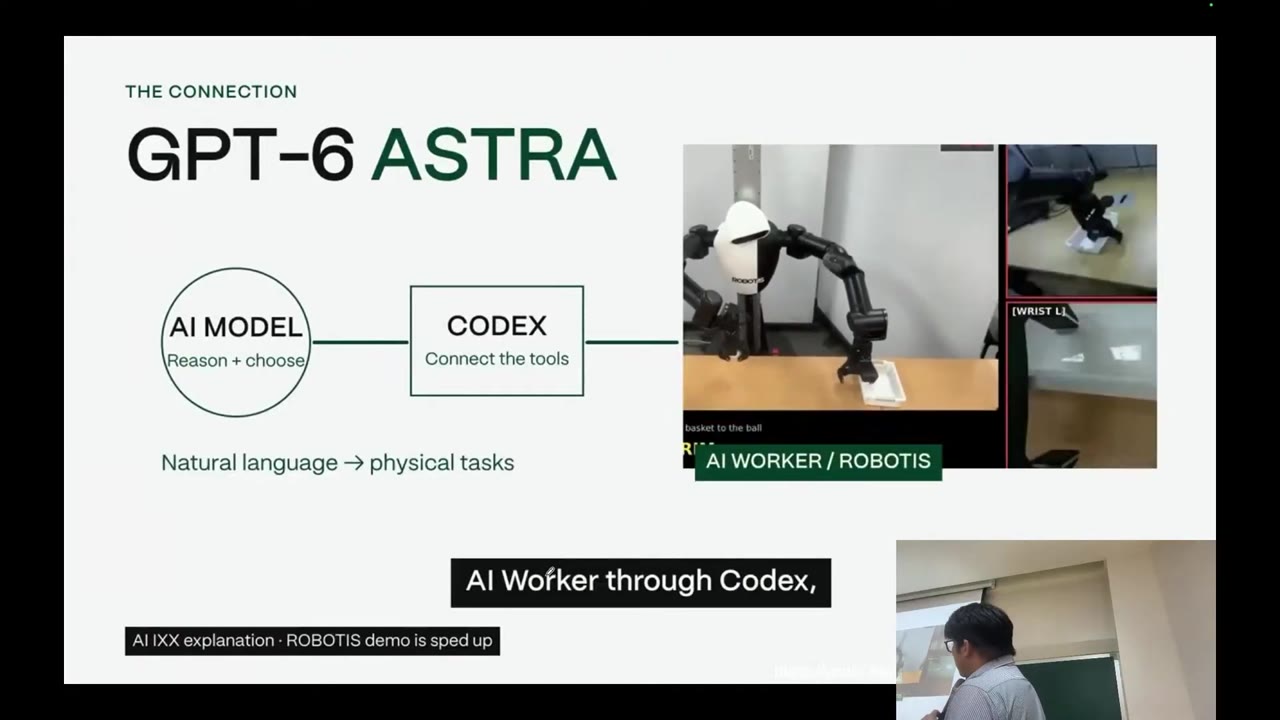
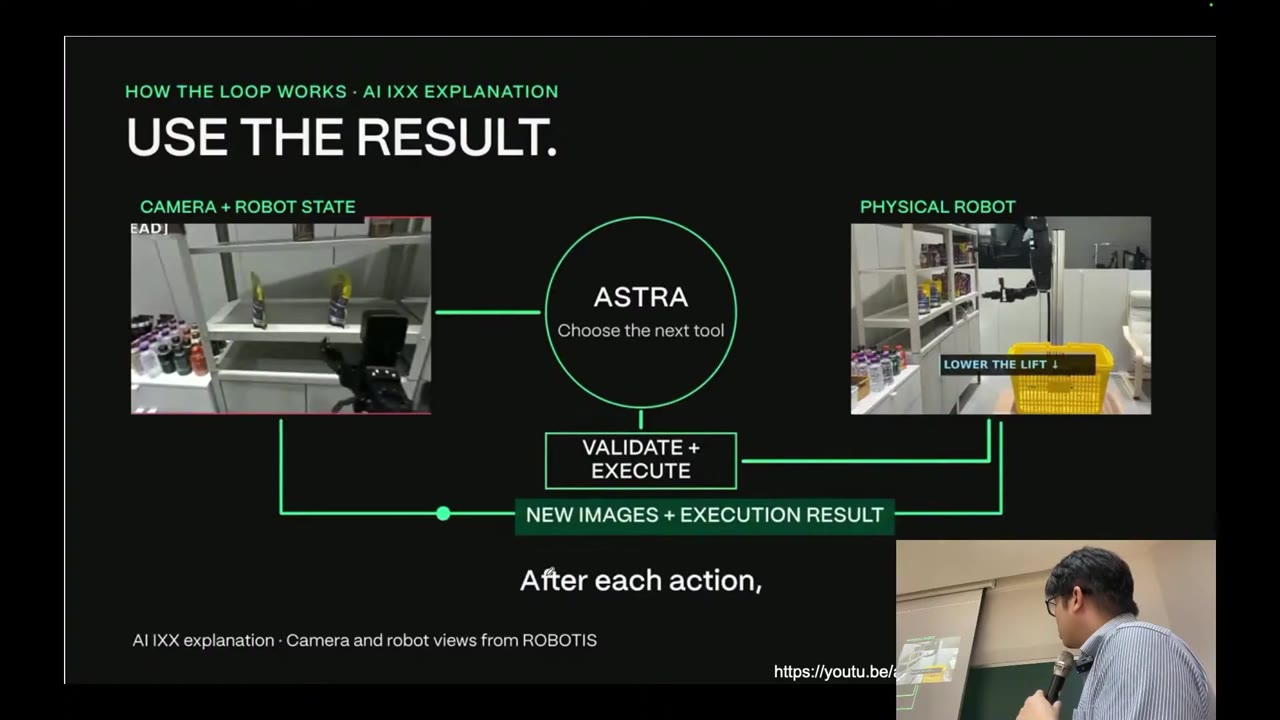
影片中機器人能抓取物品、放進推車。講者說上週 NVIDIA 的來賓也展示過類似的東西,社群因此一直在討論「機器人問題是不是已經解決了」。他提醒第一堂課說過的訊息:這支影片實際示範了什麼?
Russ 的新創:先部署、full-stack、最有價值的資料在現場
看老師講解(50:09)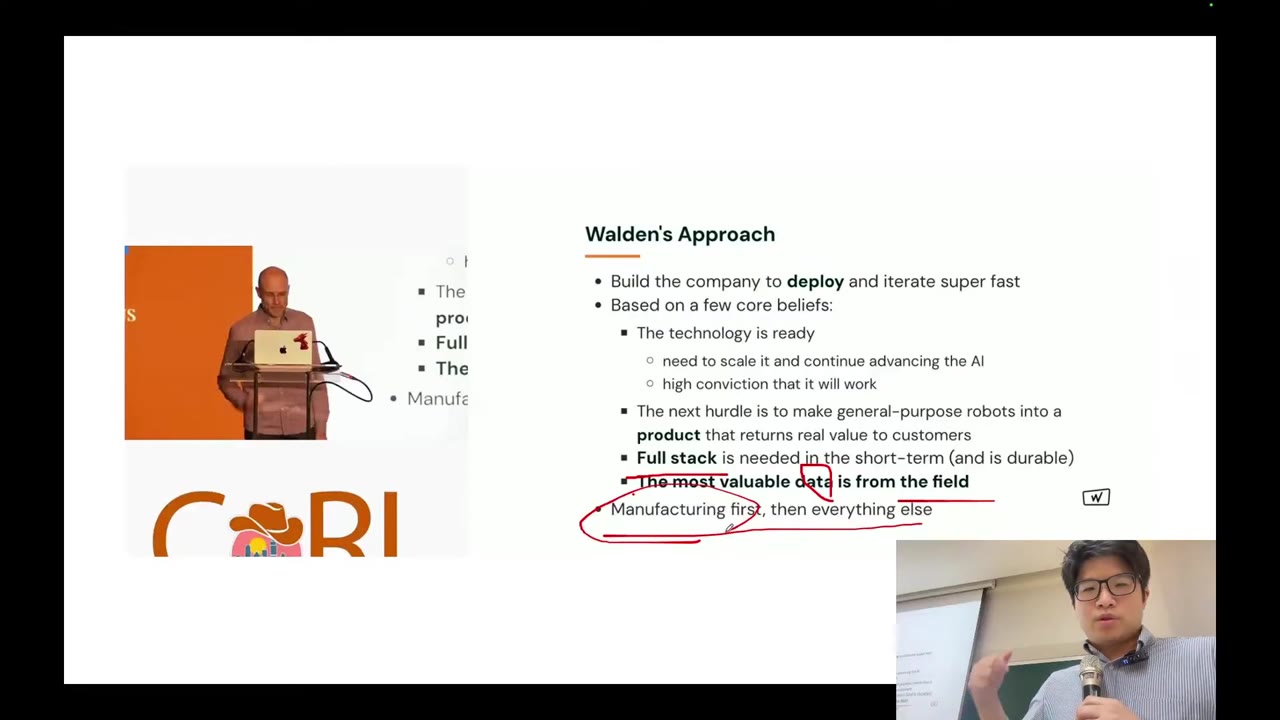
講者說 Russ 最近創辦了一家新創公司(字幕自動聽寫為 Warden,投影片寫 Walden),他的演講強調「部署」。他們有幾個信念:技術已經準備好,只需要規模化;下一道關卡是把通用機器人做成能為客戶帶來實際價值的產品。講者還提到課程曾講過的另一家公司(聽寫為 Dina,專注在摺衣服這類任務),也是同一套思路:證明某個具體任務能為客戶帶來價值。
他問大家「full stack」是什麼意思,學生答「從硬體到軟體」。講者補充:他們不是買一台機器人再把軟體裝上去,還會回饋給硬體、調整硬體;甚至環境本身要不要改,也值得討論。講者最喜歡的一句是:最有價值的資料來自現場,因為那才是真正部署的地方,只在實驗室做實驗得不到足以推進技術的困難資料;他們選擇製造業作為第一步。
CoRL 辯論:行為複製預訓練加領域內微調會通往通用機器人嗎
看老師講解(55:51)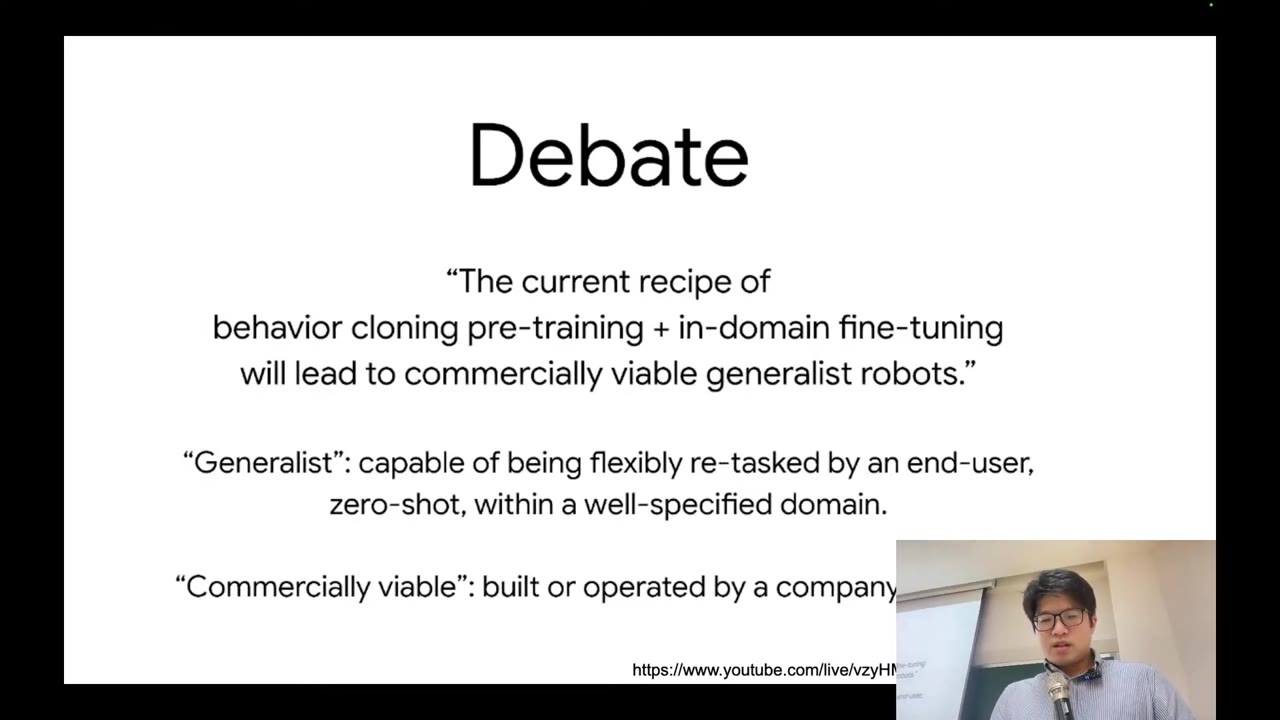
第二個要看的是台上六、七位來賓的辯論。「領域內微調」是講者以教室為例說明:如果在這間教室訓練,要部署到隔壁房間,就要在隔壁房間做領域內微調。
講者坦言很難跟上這個辯論,因為題目本身定義不清:誰是終端使用者?zero-shot 的定義人人不同;「定義明確」要多明確?「商業上可行」又是什麼?他觀察到很多時間都花在爭論詞義。他的個人看法是:這代表社群還沒有共識,而且可以把題目講得更具體,例如把「通用型機器人」放到特定領域(像 Russ 剛講的製造業與特定任務),大家才有辦法深入討論。
錄影中這段之後是約十一分鐘的休息(約 56:25–67:47)。
休息後:robot learning 是機器人學加上學習,別直接跳進 VLA
看老師講解(67:47)回到休息前的第一個問題:robot learning 是什麼? YouTube · 67:47 講者說這是兩個領域的結合:機器人學與(機器)學習,所以要回到各自的根本定義。他設計的課程路線,是先從 VLA(視覺語言動作模型)這類技術出發,因為相關論文數量很多;但他認為必須追問,為什麼要把這兩個領域合起來,否則很容易掉進「VLM 不夠好就去改 VLM、VLA 不夠好就去改 VLA」的循環,卻忘了當初的目標。
他用語言當例子:現在說到「語言」,大家都聯想到大型語言模型與 ChatGPT,你可以跟它說任何要求,要它生成投影片、程式碼,或解決複雜任務。但若要對實體機器人下指令,例如「去把廚房清乾淨」「幫我做功課」或「我想要一罐啤酒」,而啤酒在一個還沒拆封的箱子裡,機器人得先開箱、拆包,再把啤酒拿給你。傳統機器人學過去是怎麼處理「任何指令」的?如果不知道,就不知道語言模型到底能為機器人社群帶來什麼價值。
同樣地,如果不知道傳統領域做得到與做不到什麼,就無法判斷學習的新想法是不是真的補上了關鍵缺口,也就不可能有突破。講者因此提醒大家:在被各種演算法、技術與方法吸引之前,先想想原本的領域做不到什麼、你正在推進的是不是那一塊。他也說自己不會一開始就跳進炫目的演算法或操作,因為那很容易變成陷阱:沒有搞懂原本領域能做什麼,做出來的進展是否有意義,其實不知道。
本講地圖:表示物體與抓取、規劃可行動作、執行並驗證
看老師講解(80:18)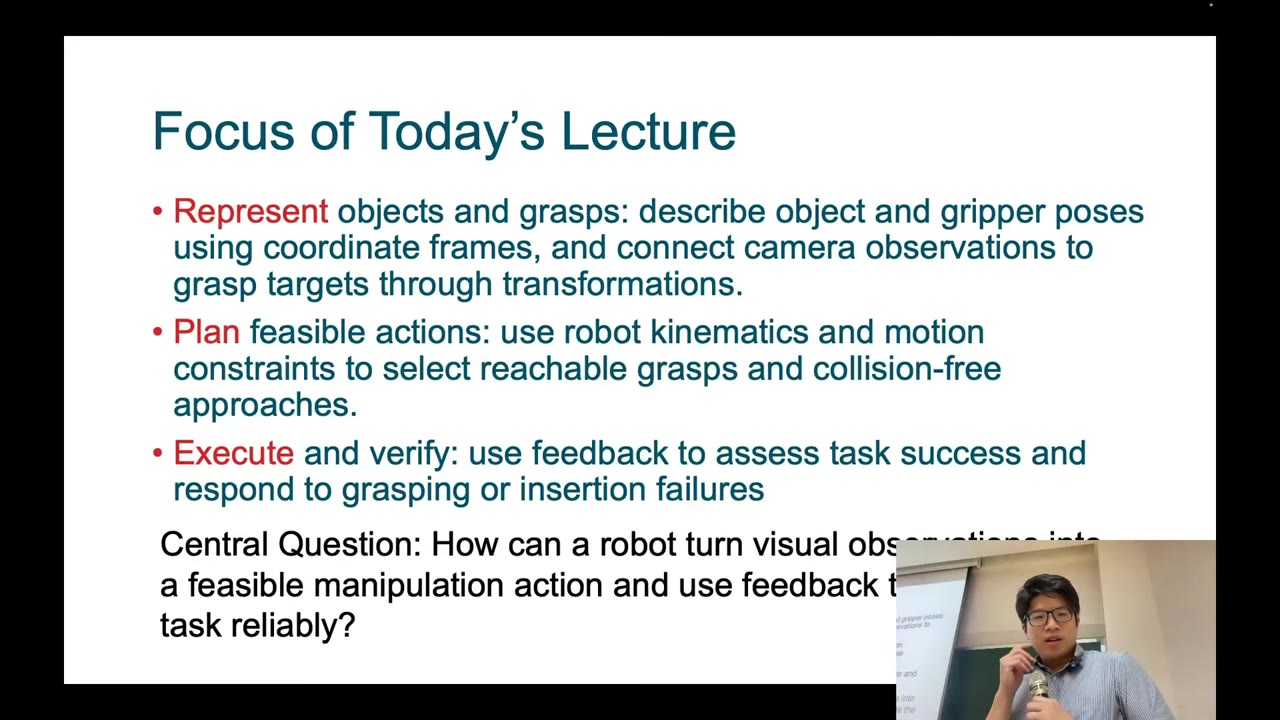
講者最後說明本講預計講的內容:第一部分是「表示物體與抓取」,描述物體並以座標系重新表示,把相機觀測透過轉換連到抓取目標;接著規劃可行的動作。他也誠實指出,他查了這兩個關鍵字(抓取與物體),近期論文裡幾乎找不到專門做這些的,因為社群多半聚焦在前面講的主流題目;但他還是想先講清楚這些基礎。
本講錄影在這裡結束,停在「再來規劃可行的動作」這句話的中途(約 1:20:22),後續的座標系、抓取與運動限制內容不在這支影片中。
複習與理解檢核
這一講大多是講者的觀察與提問,而不是公式。回答時請盡量區分:哪些是講者說的事實(實驗設定、會議數字)、哪些是他的個人看法(辯論該怎麼提問)、哪些是自動字幕不確定的地方(Astra、Fable、Walden 等名稱)。
一、數位橋梁與場景式驗證回顧
- 為什麼課程專題選擇「數位版場域加實體代理」?它對修課者與對後續實體部署各有什麼好處?
- 講者說照片重建場域「看起來不錯,不代表能完美重建」,缺的是什麼?
- 用自己的話說明驗證演算法的三個成分,並舉一個「規格」的例子,包含最低限度與更嚴格的版本。
- 第 9 講的場景式驗證留下了什麼還沒解決的問題?
作答檢核
- 全國的修課者很難都到現場,但都能進入數位版;先在數位環境讓代理運作,再到實體場域嘗試部署同一個想法;數位版是讓大家站在同一起跑線的橋梁。
- 完整的物理屬性,特別是反射等材質特性,目前示範只有初步能力;重建不等於可直接拿來當作可靠的模擬。
- 系統(決策代理)、規格(對系統的運行要求)、驗證演算法輸出的指標;規格例:保持安全距離(最低限度),再加上不急煞、不讓乘客不適,或符合社會規範(更嚴格)。
- 當失敗發生時,如何分析失敗的根本原因;這是實驗室正在進行的工作。
二、舀食物實驗:從 Obi 到擴散策略
- Obi 為什麼舀不好冰淇淋?指出講者認為的關鍵原因,並說明它與「自動化」的關係。
- 比較「編程動作」與「行為複製」:各自假設了什麼、各自在什麼情況下會失效?
- 什麼是主動感知?為什麼在舀之前先攪拌,而不是直接用影像判斷食物?
- 擴散策略為什麼能把舀取動作做得不錯卻還是會灑出來?「預判並反應」補上了什麼?
- 為什麼要用模擬來學灑出預測器?它有哪些限制?
- 列出這系列實驗講者自己承認的三個限制。
作答檢核
- 機器人沒有相機,只會執行編程好的固定動作;自動化假設食物與位置永遠固定,真實世界的食物形狀大小與種類都不同,而預期用途(讓行動不便者獨立進食)又很大。
- 編程動作假設環境與物件固定,一旦變化就失效;行為複製靠人示範,可推廣到示範過的種類,但遇到沒見過的食物或狀態改變(如碗裝滿、位置移動)仍可能不會調整。
- 先與物體互動(攪、搖、捏)取得它的性質;食物的性質多樣且會隨時間改變,單靠外觀可靠度有限。
- 它學到示範的行為,但訓練時碗沒裝滿、測試時碗位置改變,策略沒有因應當下狀況調整;「預判並反應」先預測此動作會不會灑出,會灑就修正軌跡。
- 真實收集失敗案例很痛苦(要清桌子、補食物、重做);模擬能提供不錯的近似;但模擬還不能模擬很多種食物,食物性質難以量測與模擬。
- 只測少數食物、只用一種湯匙與一個容器;模擬不夠好;食物性質太多。
三、CoRL 與社群觀點
- CoRL 十年來的變化說明了什麼?這跟本課程選擇講操作有什麼關係?
- 講者為什麼不只引用主辦單位的關鍵字,還自己用錄取論文標題做文字雲?兩者看到的差異是什麼?
- 看到 Astra 與 Fable 的示範影片,為什麼不能直接說「機器人問題解決了」?請用四個層次說明你會追問什麼。
- Walden 的做法中,「full stack」與「最有價值的資料來自現場」分別意味著什麼?
- 講者對那場辯論的批評與建議是什麼?這與第 9 講的規格概念有何關聯?
作答檢核
- 從約兩百人成長到約四千人,投稿量也大增,操作與 VLA 是最大主題,所以先用一講理解操作;也顯示台灣社群還很小,是機會也是門檻。
- 主辦單位的八個類別很高層;標題文字雲多了 VLA、人形機器人、靈巧、抓取,放大才看到泛化、接觸、跨形體,更貼近實際研究熱點。
- 能力(任務能做嗎)、泛化(新物件、環境、任務)、可靠度(10、1,000、100,000 次的成功率)、長期運行(數小時、週、月);一支影片多半只回答第一層。
- full stack:硬體、軟體甚至環境一起調整,不是買現成機器人再裝軟體;現場資料才是真正部署會遇到的困難資料,只在實驗室做無法推進技術。
- 題目的詞義不明(終端使用者、zero-shot、定義明確的領域、商業可行),導致花大量時間爭論定義;建議把領域與任務說具體;關聯:沒有清楚的規格與預期用途就無法評估。
四、什麼是 robot learning
- 為什麼講者說直接跳進 VLA 是陷阱?
- 情境應用:對機器人說「我想要一罐啤酒」,而啤酒在未拆封的紙箱裡。列出傳統機器人學需要處理的步驟,並指出學習可能補上哪些部分。
- 為什麼要先知道傳統機器人學做得到與做不到什麼,才能在 robot learning 做出突破?
作答檢核
- 容易只在熱門方法內打轉(VLM 不夠好就改 VLM),忘記整合兩個領域的原始目標,也看不出自己究竟在補哪個缺口。
- 理解指令、找到啤酒在哪、開箱、拆包、抓取、搬運交給人;學習可補上的部分例如理解開放式語言、辨識沒見過的包裝、適應不同箱型的動作(作答只要能指出缺口與原因即可)。
- 不知道傳統領域的邊界,就無法判斷新方法解決的是不是真正做不到的事,進展就可能沒有意義。
五、最終口述挑戰
- 用三分鐘回答:「為什麼 Obi 這樣的餵食機器人做不好舀食物?如果你要讓它在沒見過的食物上也可靠,會怎麼設計,又怎麼判斷它真的做到了?」必須依序提到編程動作、行為複製、主動感知、預判並反應與模擬的角色,並用能力、泛化、可靠度、長期運行四個層次說明如何評估。
通過標準
能先指出 Obi 沒有相機、只執行固定動作,無法因應食物差異;說明以人示範(行為複製)學習舀取,並用主動感知先攪拌掌握食物性質;說明擴散策略雖能做出動作但不會因應當下狀況,需要預判灑出並修正,且可用模擬產生失敗資料但受限於模擬逼真度;最後用能力、泛化(沒見過的食物、器具、容器)、可靠度(多次試驗成功率與灑出率)與長期運行說明驗證,並誠實承認目前只測少數食物與單一器具與容器。
內容整理自本專案 Lecture 11 影片及 YouTube 自動英文字幕;投影片截圖取自同一支課程影片(開頭、休息與部分段落只拍到講者鏡頭,略過)。本次影片為第 11 講;第 10 講(NVIDIA 來賓的 Isaac Sim 介紹)尚未上線,待人工處理。繁中字幕已依台灣用語翻譯並通過格式驗證,Astra、Fable、Walden 等名稱依投影片與上下文校正,正式公開前仍建議人工複核收音不清的片段。本講由每週排程自動整理上線。