快速掌握
本講核心:第一段錄影前半補完第 6 講沒講的第三條路——從資料學習深度。單張影像推不出深度,但影像裡的紋理、遮擋、物體大小等線索可以靠大量資料學起來;難處在監督訊號從哪裡來。講者依序比較 RGB-D 感測器、模擬、3D 電影、人工標註與影片,重點介紹兩個用影片的作法:Mannequin Challenge 用靜止的人群讓 SfM 產生深度真值;view synthesis 則把「用預測的深度與姿態重建相鄰影格」當成監督,把幾何約束放進目標函式。後半進入路徑規劃:路徑、軌跡、策略的差別,以及為什麼只看自由空間不夠,要用組態空間同時考慮機器人實體與環境。第二段錄影把組態空間落到實作:視覺觀測 → 深度 → 點雲 → 佔用網格 → 組態空間 → 路徑;網格解析度是可行性與計算量的取捨;自由度一高,網格搜尋就算不動,於是改用取樣式規劃(PRM),最後提醒幾何上無碰撞的路徑仍可能不安全。
- 學習式單目深度利用的是影像的整體構成(紋理、遮擋、物體大小),這些線索很難只靠多視角幾何利用。
- 每種監督來源都有代價:感測器有雜訊與距離限制、模擬有 sim-to-real 落差、人工標註只有相對深度、影片自監督要假設光度一致。
- Mannequin Challenge 的關鍵是靜態世界假設:人都不動,SfM/MVS 才能產生可信的深度真值;學到的模型還能補上 MVS 的破洞。
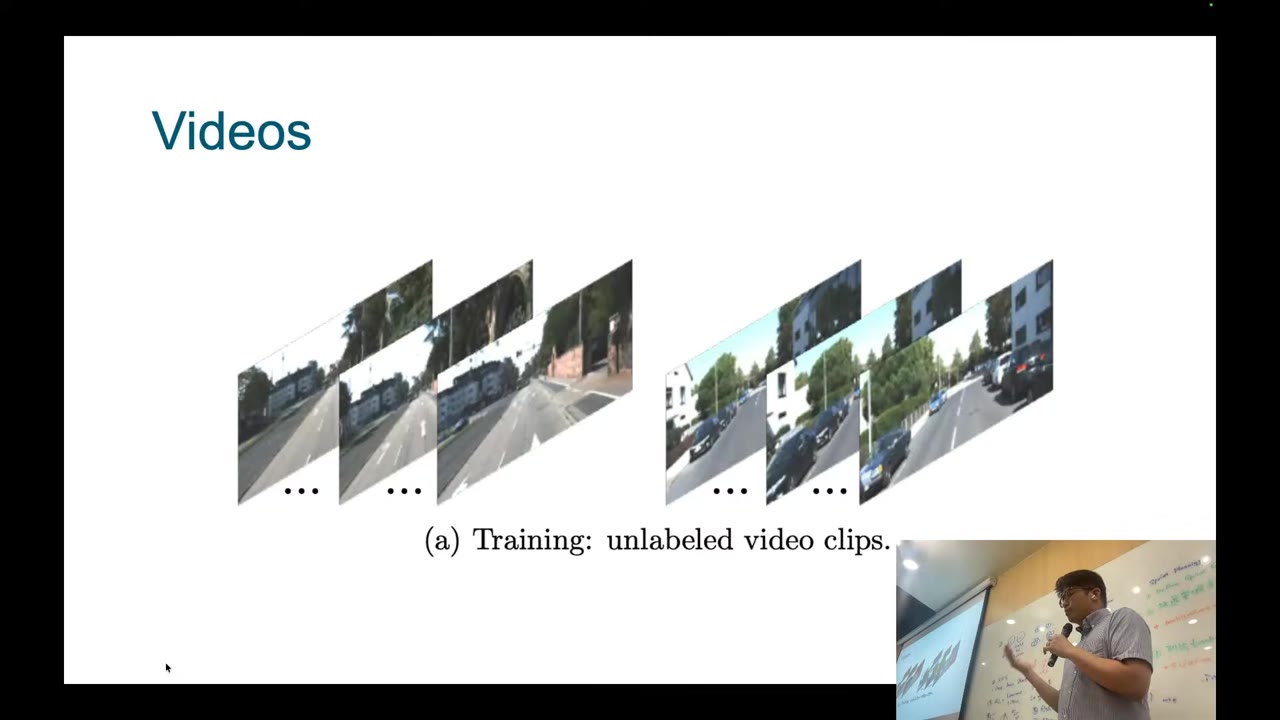
- view synthesis as supervision:深度網路預測 D_t、姿態網路預測相機運動,把第 t 幀的點 warp 到相鄰影格,用光度一致性當損失。
- 路徑 q(s) 不管時間,軌跡 q(t) 要管時間,策略 π(a|x) 要對當下狀態做反應;路徑可行的前提是機器人整個實體都能沿著它移動,這就是組態空間的出發點。
- 佔用網格只描述環境;把機器人尺寸算進去才是組態空間。網格切太粗可能找不到路,切太細計算量暴增。
- PRM 先在自由空間隨機取樣、連成路線圖,再把起點與終點接上去做圖搜尋;它具機率完備性,但不保證在固定時間內找到解。RRT(作業二要實作)留到下一講。
課務說明,與深度估計的三條路
看老師講解(Part 1 · 6:20)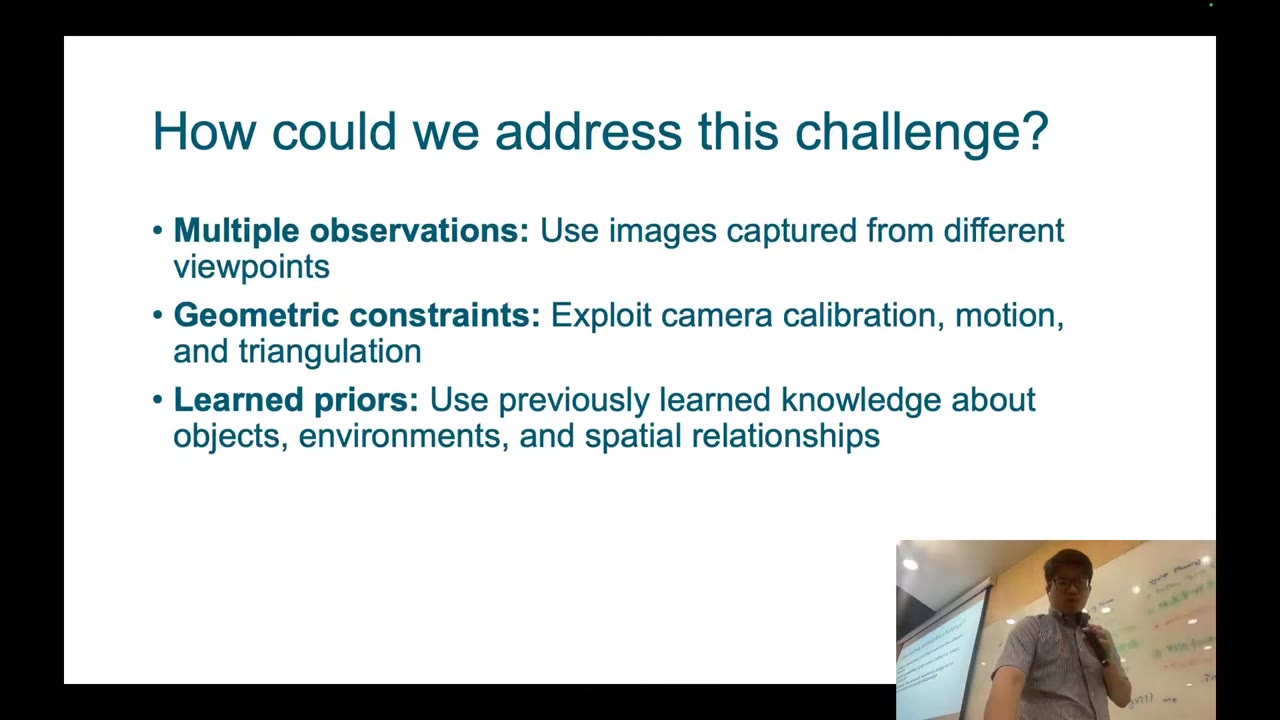
上課前講者先說明作業的行政安排:陽明交大的同學,作業公告與評分都在 E3;今年因為是全國性的跨校授課,講義等資訊也會放在 NTU COOL。不過其他合作學校的作業何時釋出、怎麼評分,課程團隊不代為處理,請各校同學洽詢自己學校的共同協調人或助教團隊。
接著回到上週的深度估計。單目深度估計是 ill-posed 問題:從相機原點射出一條射線,射線上任何一點投影到成像平面都落在同一個像素,就像遊客「扶著」比薩斜塔的錯覺照片。要化解這種模糊性有三條路:一是多個觀測,也就是 structure from motion(特徵擷取與匹配 → 極線幾何估計姿態 → 三角測量 → bundle adjustment);二是幾何約束,例如基線已知的立體相機;三是今天的主題,從資料學到的先驗。
「對應、對應、對應」:Kanade 教授的兩個故事
看老師講解(Part 1 · 8:28)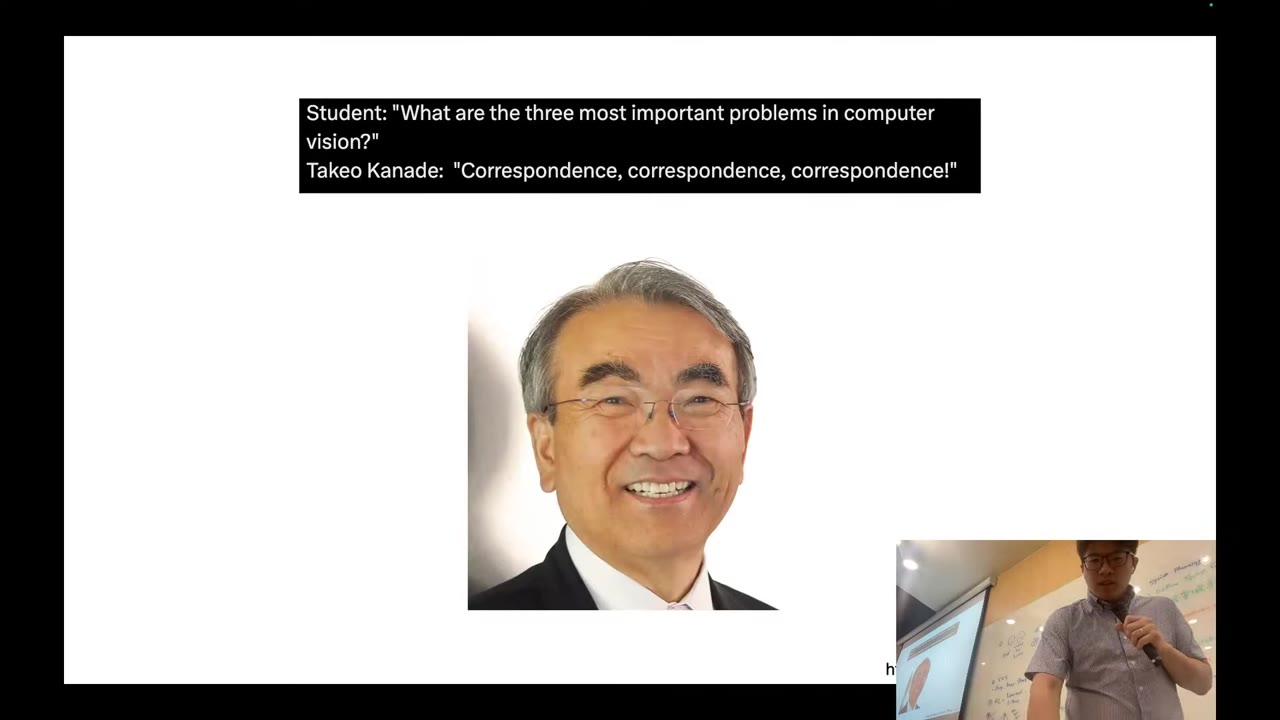
上週那句「電腦視覺最重要的三個問題」出自 CMU 的 Takeo Kanade 教授。講者介紹他的一項代表作:CMU 的圓頂攝影棚,牆上裝了 500 多台同步的相機,人可以在裡面跳舞、互動、做日常動作,系統擷取全身、臉部與手部的 3D 關鍵點,也能重建出人在圓頂裡的位置。
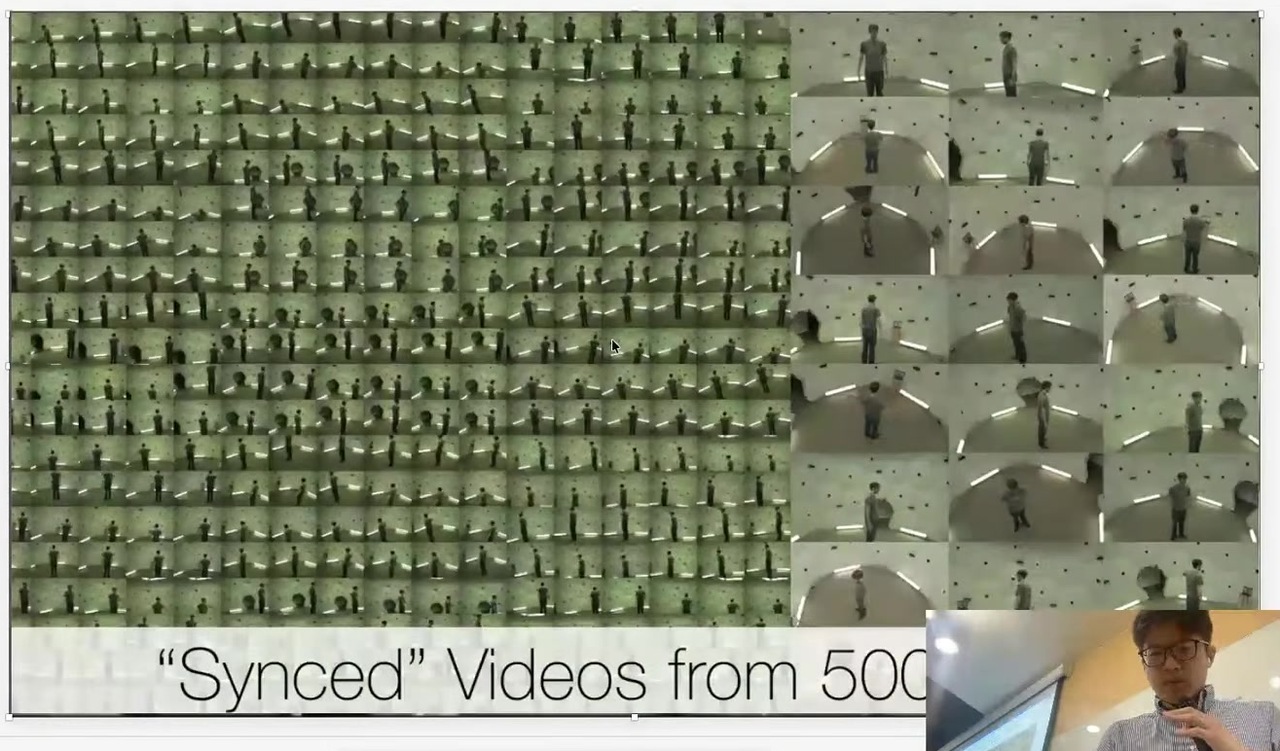
講者說這是今天大家談的虛擬實境、擴增實境的很早期版本。要重建 3D 物體以及它們怎麼隨時間移動,可以用 SfM 重建場景結構,再一路追蹤每個人的動作——對應點是讓這項技術成立的基礎。
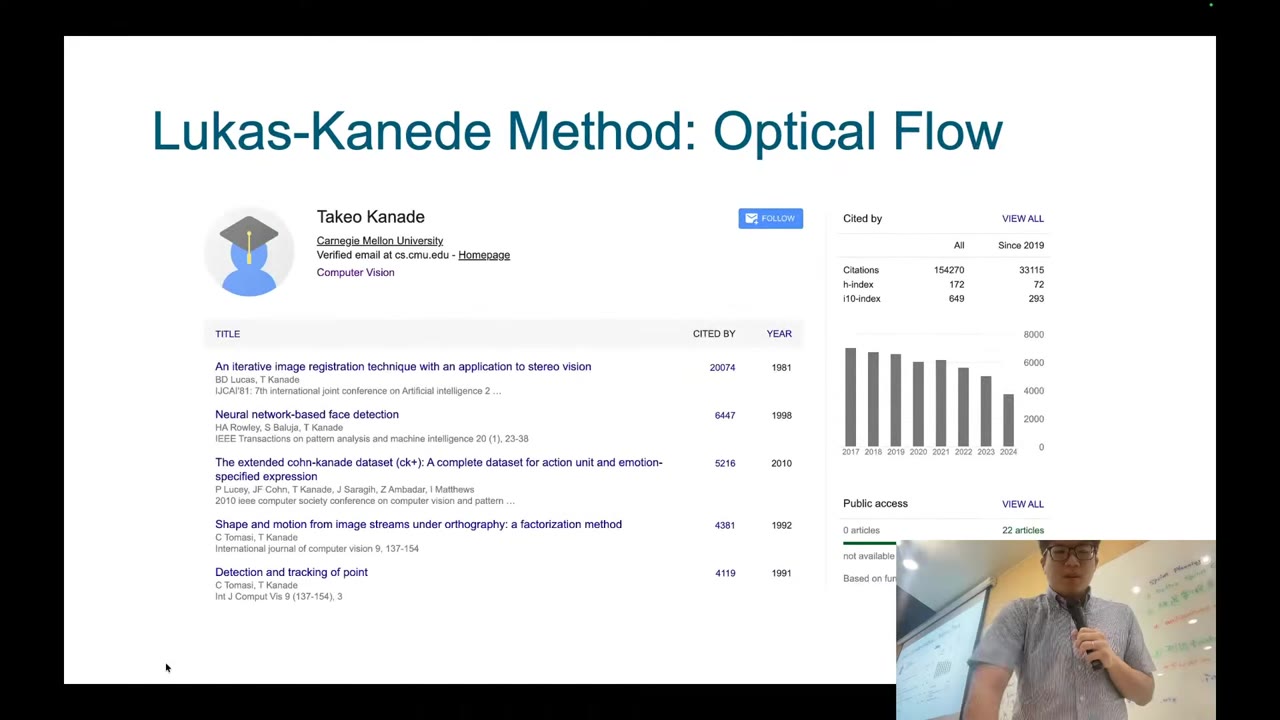
第一個故事:博士生 Lucas 向指導教授 Kanade 提議,用一階泰勒展開來解光流。Kanade 覺得這個想法太簡單、不值得發表,Lucas 卻堅持「夠簡單又有效,為什麼不行」。Kanade 只好說那就投到沒什麼人讀的地方——因為他的名字會掛在上面。多年後,這篇成了他被引用最多的論文;他在演講裡常拿這件事開玩笑:「不要相信你的指導教授。」專家經驗多,知道怎麼把事情做成,但也可能被既有的想法綁住;年輕人如果相信自己的想法能帶來突破,就堅持下去。
第二個故事:講者遇到 Kanade 時請他在書上簽名,他寫的是「Yi-Ting, please revolutionize how a car perceives the environment」。過去四、五十年已經有無數感知方法,連 Kanade 都還認為會有新的突破。講者至今仍在想「徹底改變車輛感知環境的方式」到底是什麼意思;同樣地,Physical AI 系統怎麼與物理世界互動,也還有很多問題等著大家。
第三條路:從資料學習深度先驗
看老師講解(Part 1 · 19:13)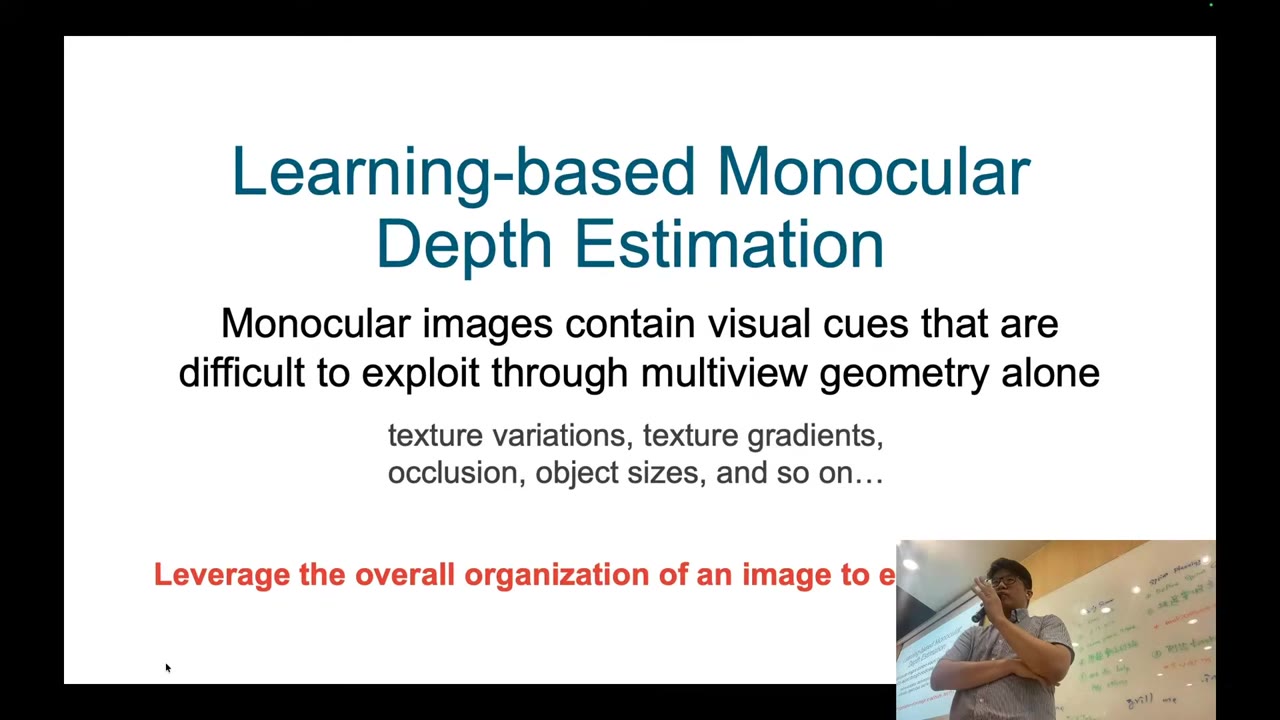
前兩條路利用的是特徵、對應點與幾何約束;可是一張影像裡還有很多別的資訊:紋理的變化與梯度、誰擋住誰、物體看起來多大。如果利用影像的整體構成,能不能學到一些模式,幫我們推回 3D 結構?這跟前兩種方法很不一樣,也是近幾年很熱門的方向。
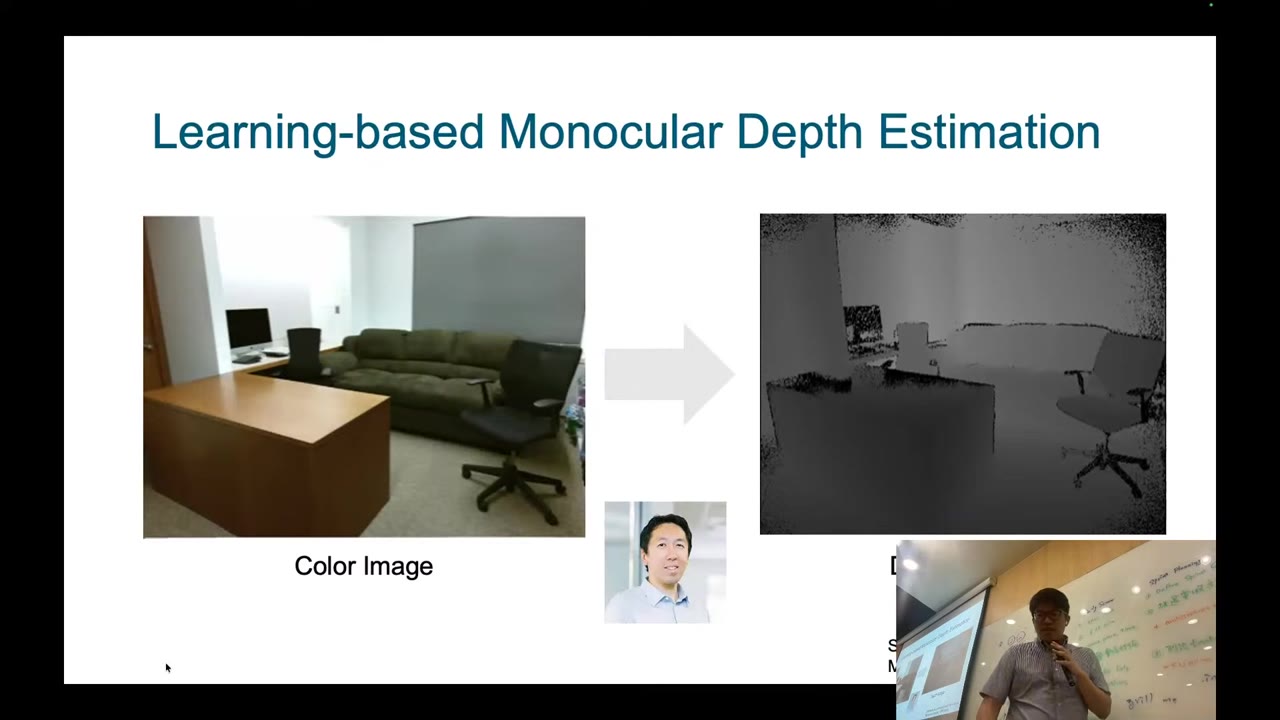
Andrew Ng 的團隊當年問的是:能不能收集大量資料,訓練模型去預測對應的深度?要這樣做,就得先回答一個問題:監督訊號從哪裡來?
監督從哪裡來:感測器、模擬與 3D 電影
看老師講解(Part 1 · 22:17)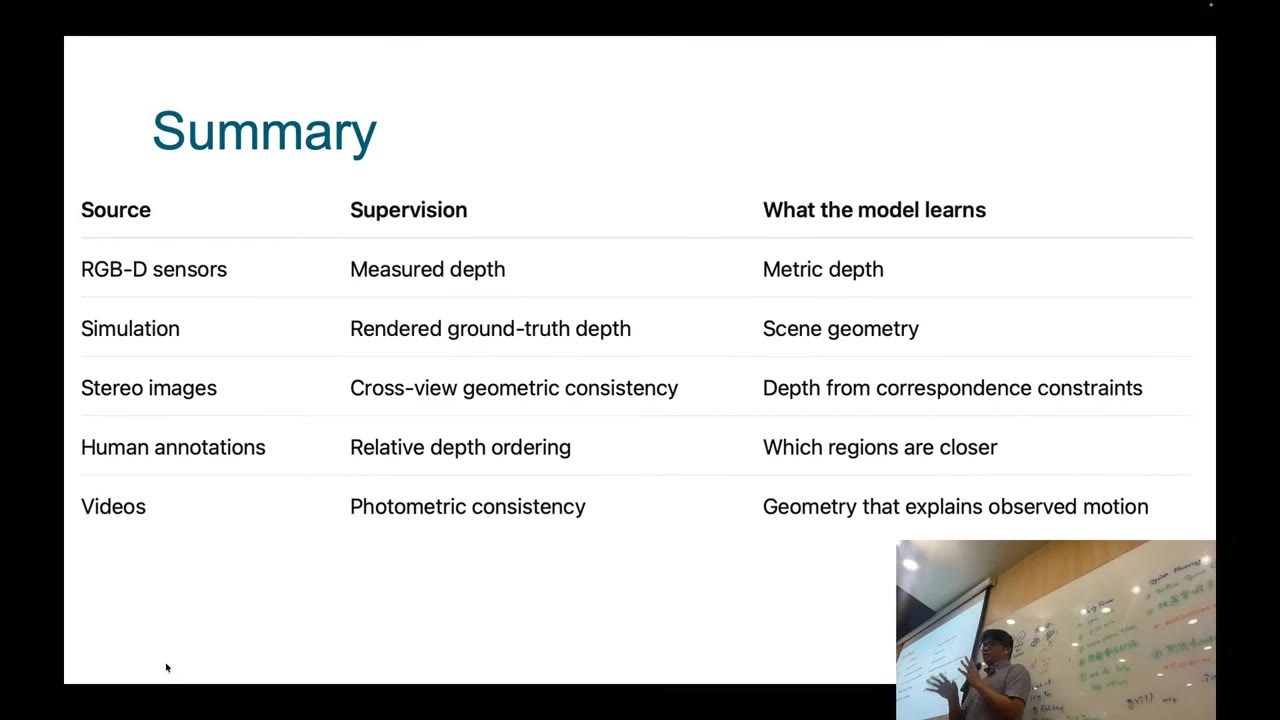
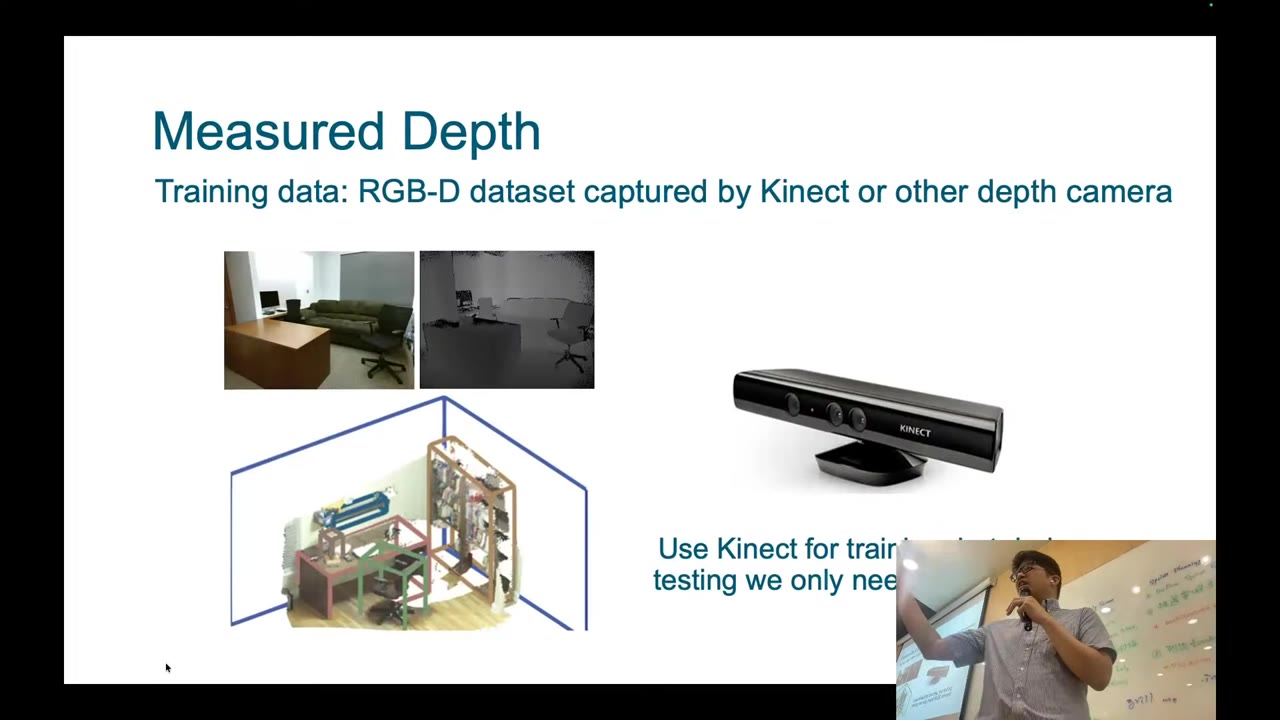
第一種最直接:深度相機本來就能量出深度,那就大量收集彩色影像與深度的配對。不過這很耗時,而且上週講過,視差估計只要差一點,深度的不確定性就會很大,RGB-D 相機的量測本身就有雜訊。
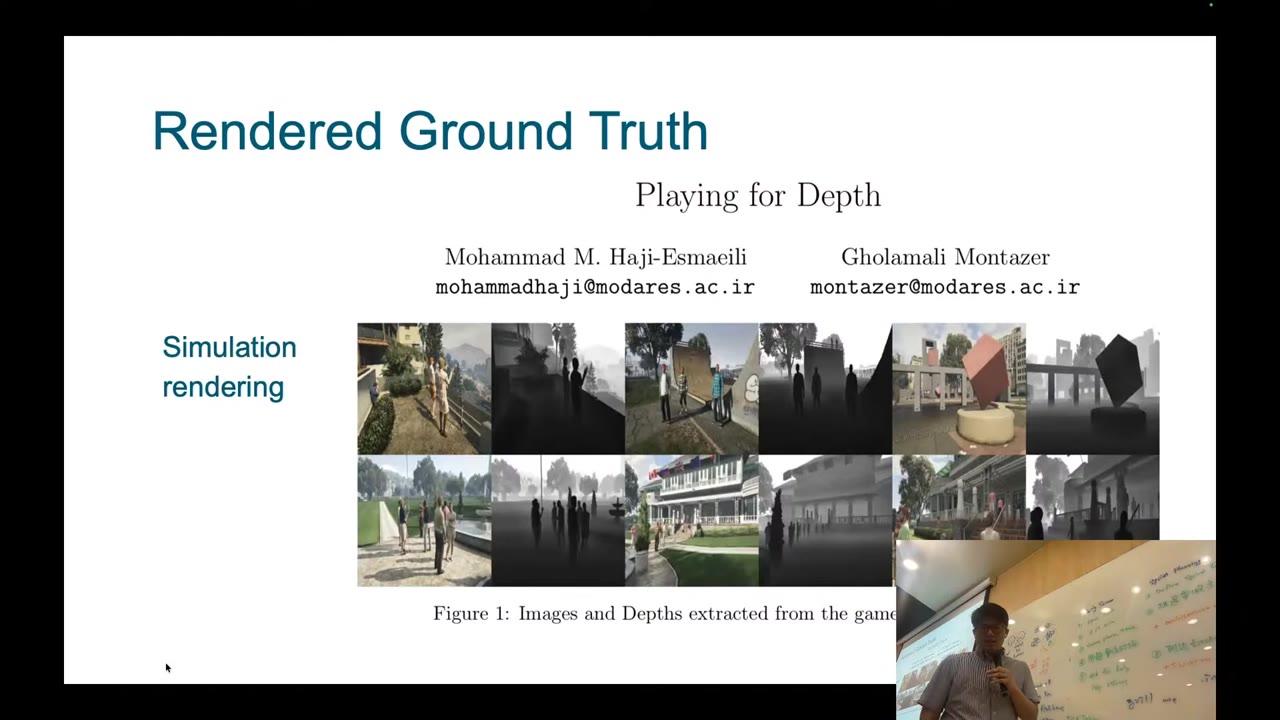
第二種是模擬。3D 結構是自己設計的,所以深度完全已知;做法和前一種一樣,給 RGB 影像、預測深度。講者提醒,之前談模擬是為了控制機器人與物體互動,這裡則是拿模擬來學從單張影像推 3D 場景結構。
人工標註與影片
看老師講解(Part 1 · 26:15)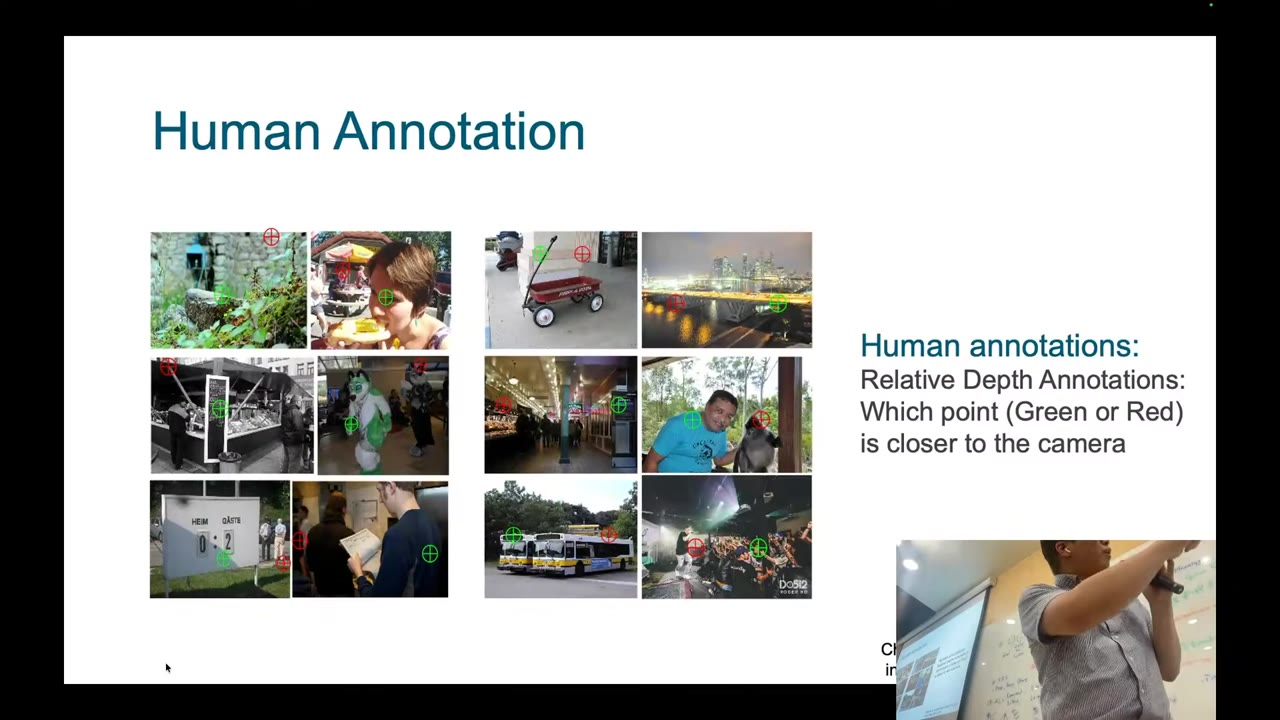
有時候不需要精確的 3D,只要標「這個人比較近、那個物體比較遠」。這和前兩種的公制深度不同:相對深度只能告訴我們誰比較近,不能告訴我們相機到物體究竟多遠。
Mannequin Challenge:讓世界靜止,SfM 就能產生真值
看老師講解(Part 1 · 27:35)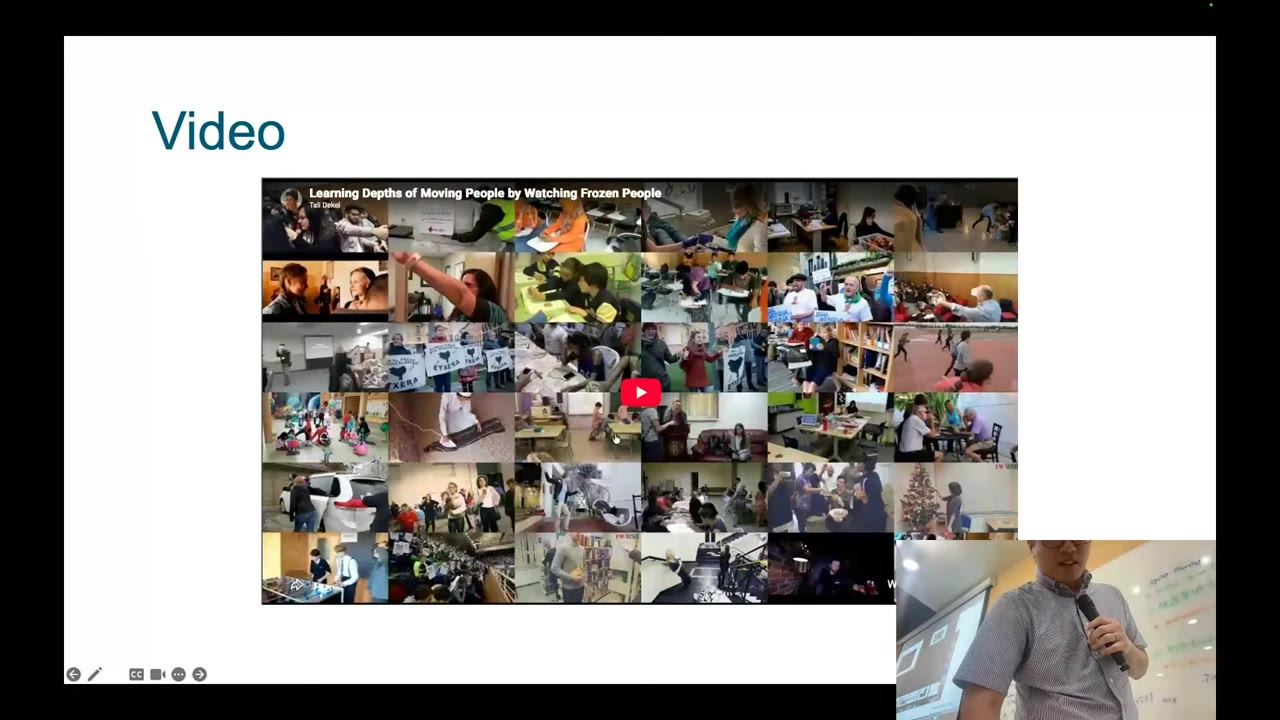
講者很喜歡這篇。他先停下來問大家:有了這些影片,要怎麼做出監督訊號?監督式學習需要彩色影像與深度影像的配對,但影片只有彩色影像。有同學答「找對應點」,也有同學答「用 SLAM 做 3D 重建」——講者說後者正是這篇的想法。
SLAM 或 SfM 有一個重要前提:靜態世界假設。場景裡若有會動的物體,重建就很困難;而 Mannequin Challenge 剛好替我們創造了一個靜止的世界。把多張影像丟進 structure from motion(再加上多視角立體,MVS),就能得到場景的 3D 點雲。要變成某一幀的深度影像,還需要針孔相機模型:先把點雲轉到該幀的相機座標系,再投影到成像平面,保留每個點的 Z 值。
講者提醒,這樣得到的深度是相對尺度的:只靠多張影像,無法還原實際的公制大小(scale ambiguity),要得到公制深度還需要立體相機這類幾何約束。對這篇的目的——分出前景的人和後面的背景——已經夠用。
比較 MVS 的重建與學到的模型的預測,可以看到差異:MVS 的深度常有破洞或缺值,模型的預測卻幾乎每個像素都有值。原因是神經網路把整張影像當輸入,從鄰近像素找模式與相關性;而整個 Mannequin Challenge 資料集裡,總有一部分像素有真值可學。單一場景的幾何重建只能用到那一場的觀測,學習式方法則能從大量資料學到「看到這種影像,深度大概長這樣」。
各種監督的取捨
看老師講解(Part 1 · 48:04)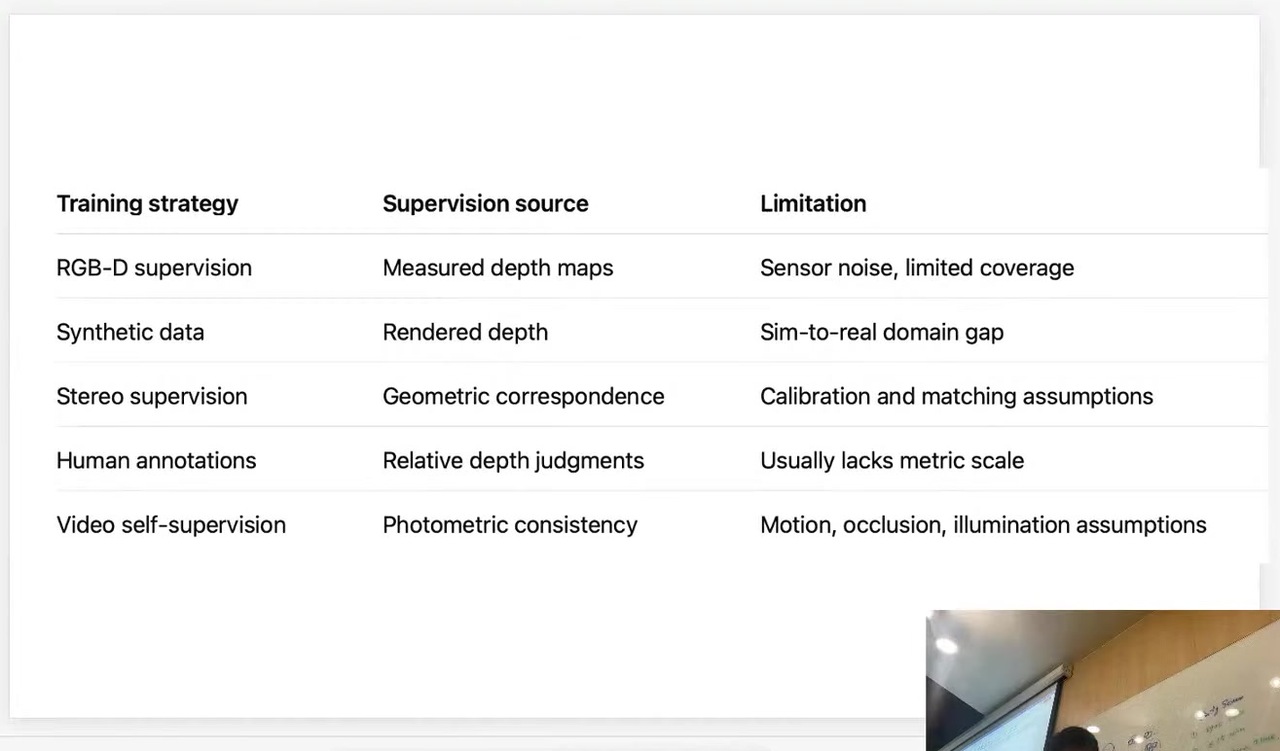
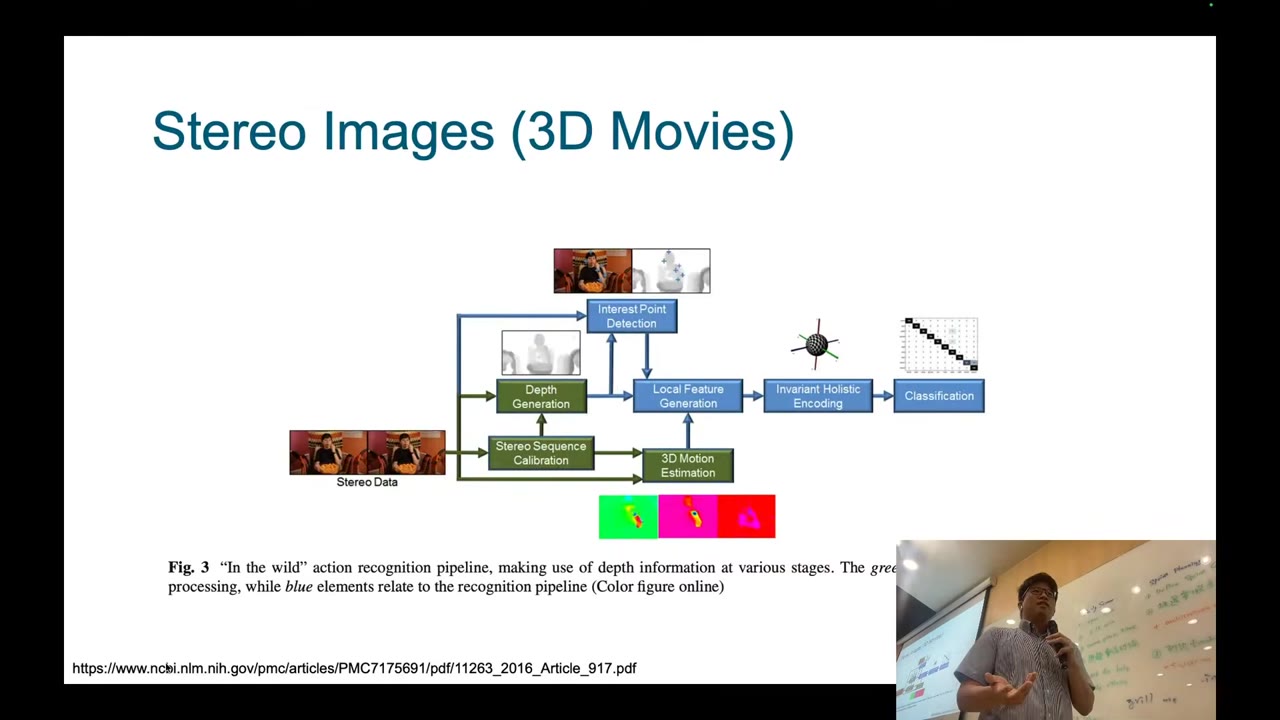
下課前講者把各種來源整理一次:RGB-D 相機有雜訊、量測距離有限,太遠的深度預測不了;模擬要面對 sim-to-real 落差;立體監督的好處是有幾何約束,可以還原公制深度,但要處理很多讓約束成立的細節;人工標註只能給相對深度;影片監督靠的是光度一致性,下一節再講。
他也把過去一小時串起來:SfM 能推出 3D 結構,但只到一個尺度;立體相機用已知基線補回公制深度;只靠幾何約束,深度圖可能破碎;用大量資料學習,就有機會從單張影像預測完整的深度。今天介紹的可能是較舊的方法,但較新的大模型背後的基本想法,仍來自 SfM 與幾何約束。
實驗室機器人 Sid,與 view synthesis 的想法
看老師講解(Part 1 · 1:09:49)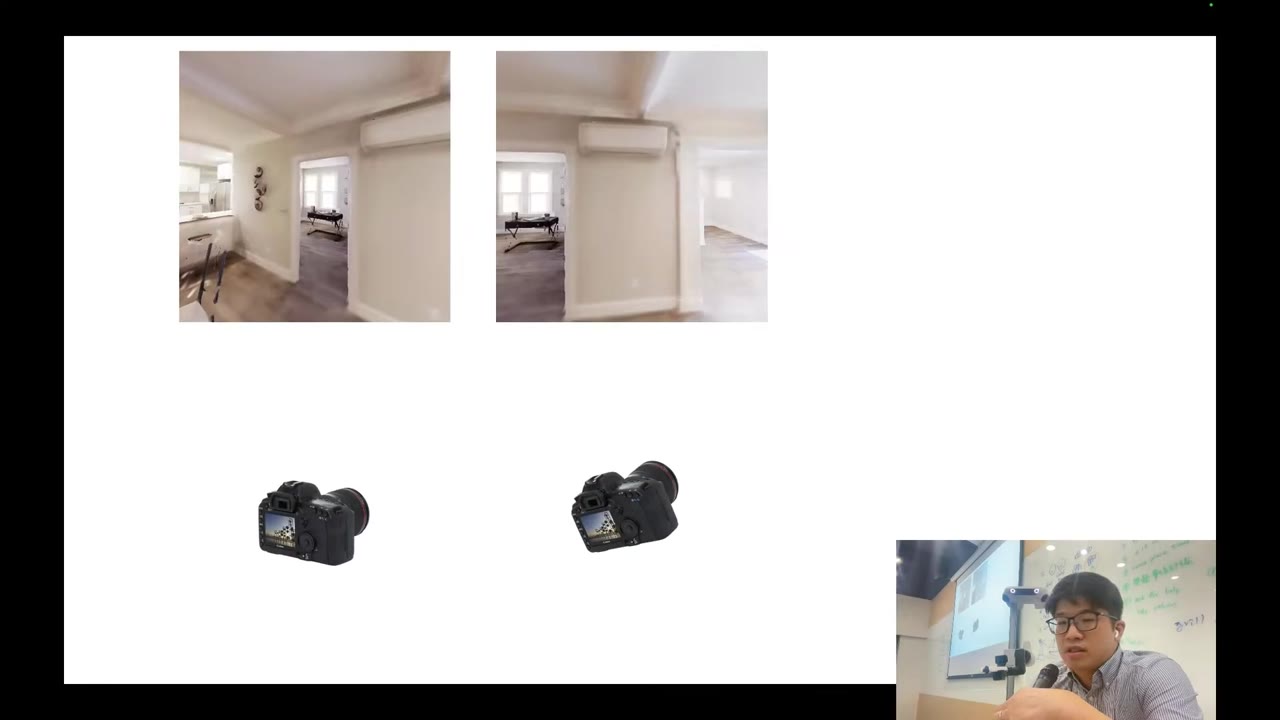
下課後,講者把實驗室的機器人帶到教室。學生說它長得像《冰原歷險記》的樹懶,所以叫它 Sid。它的「眼睛」其實是兩台平行的相機——立體相機;基線由廠商決定、已知,所以能還原公制深度。但立體相機只看得到一定距離內,Sid 要在環境中導航,不能只看一公尺,所以身上還有兩個 LiDAR,主動打光出去、量反射回來的距離。手上還有另一組立體相機,基線比較短:基線越寬,深度估得越好,但對應點越難找;手上的相機只需要看手邊要操作的物體,短基線就夠了。
前兩講談的 SLAM、SfM、立體視覺,就是讓 Sid 理解空間的方法。目前 Sid 還是用遙控器操作;如果要它從櫃子上拿麥克風、送到後排同學手上,它得知道自己在哪、麥克風在哪,還要規劃路徑。講者說,坐在教室聽了好幾週的演算法,這就是真的硬體:要讓它動起來,背後有非常多細節,而這門課講的就是這些細節。
回到深度:Mannequin Challenge 的作法需要先用 SfM 把影片處理過,才拿得到監督。有沒有不必先前處理資料的作法?這就是 view synthesis as supervision:給場景的一個視角,合成從另一個相機姿態看到的新影像。影片裡下一幀天生就是監督訊號,難的是要同時預測出相機在兩幀之間怎麼移動。
深度網路+姿態網路:用光度一致性訓練
看老師講解(Part 1 · 1:14:01)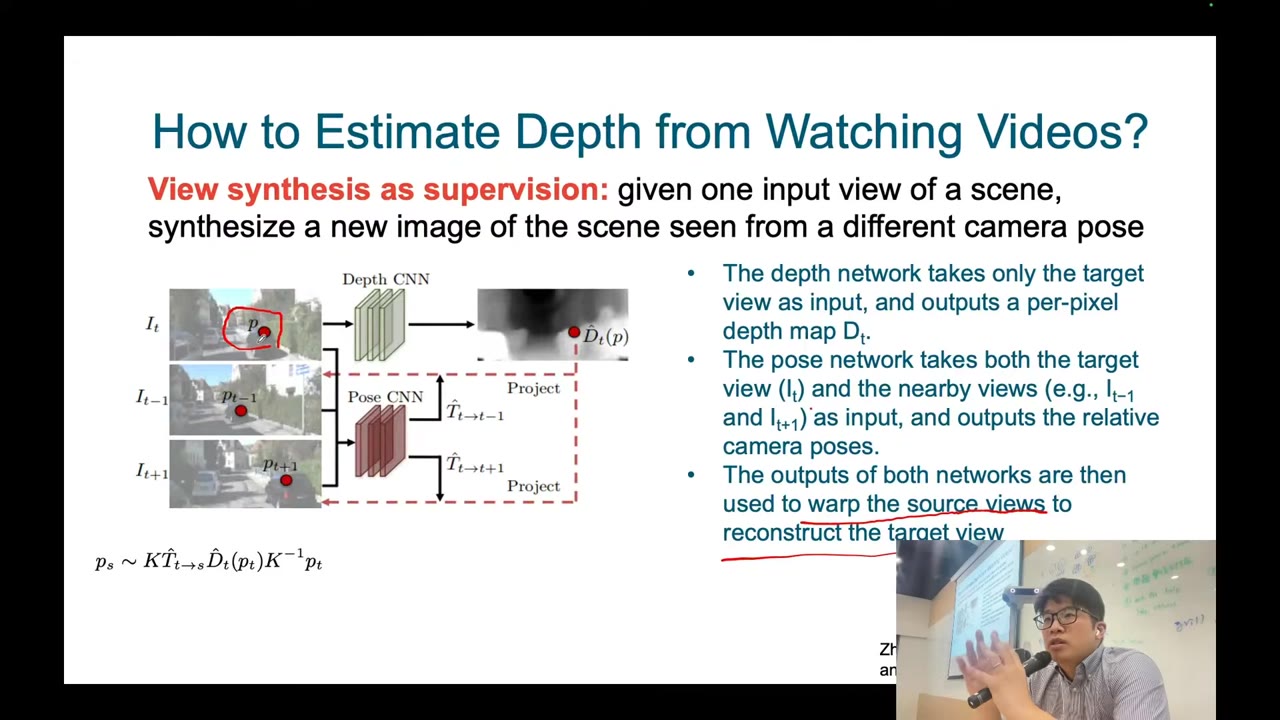
架構有兩個網路。深度網路是我們真正要的:給一張影像,預測深度。但要預測下一幀,還得知道兩幀之間的轉換,所以另外有一個姿態網路,預測第 t 幀到第 t−1 或 t+1 幀的轉換矩陣。訓練時從影片取連續三幀。
關鍵假設是:第 t 幀上的某個點 p,對應的 3D 點也出現在第 t−1、t+1 幀。把 p 先反投影到 3D——需要內參矩陣 K 與這個像素的深度——再用預測的轉換搬到另一個相機的座標系,最後再用 K 投影回 2D,就得到它在另一幀上的位置 ps。這個從一個影像平面「搬」到另一個影像平面的動作叫 warp。
但光有這條式子還不夠,還需要另一個假設:光度一致性。同一個 3D 點被兩個相鄰視角拍到,投影到兩張影像上的像素值應該差不多。如果深度或轉換估錯了,pt 與 ps 的 RGB 值就會差很多,目標函式的誤差就大;調整深度與轉換的估計直到誤差最小,深度網路和姿態網路就一起訓練好了。
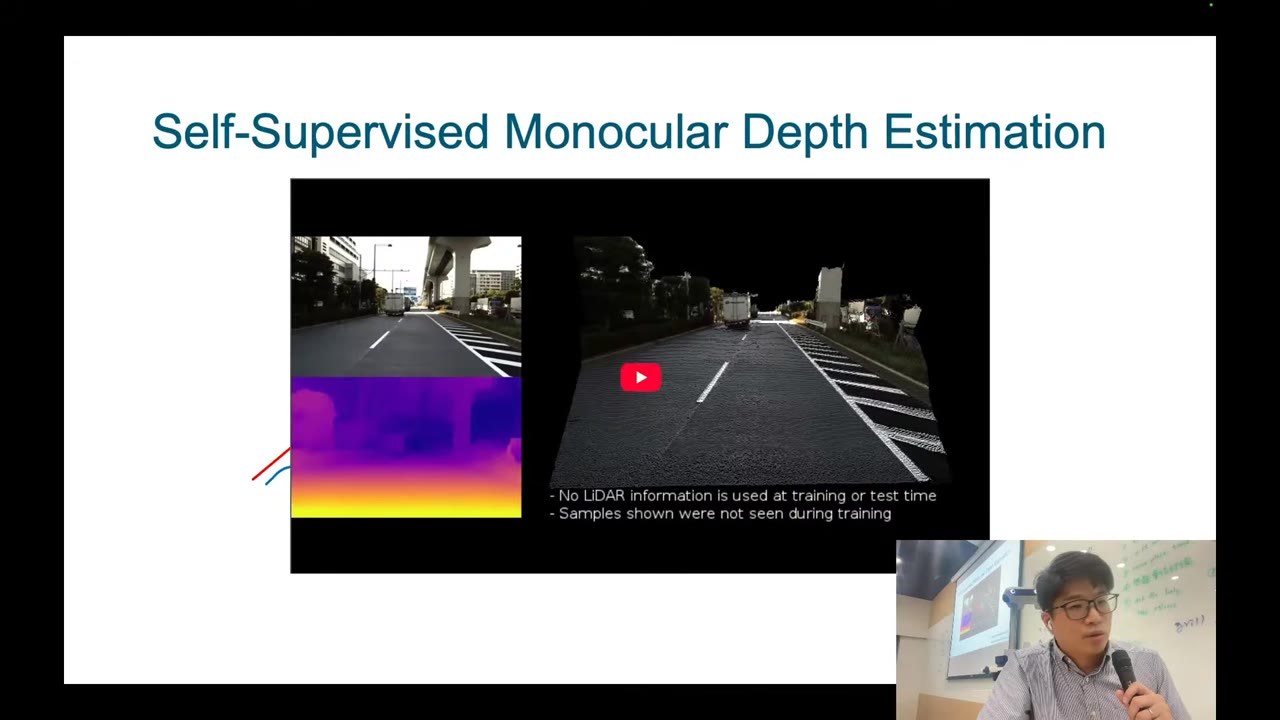
講者喜歡這篇 CVPR 2017 論文的原因是:它不只是丟一堆資料給網路,而是把幾何約束放進網路設計裡——不直接回歸深度值,而是把對應關係與光度一致性寫進目標函式。單純這個方法效果不算很好,但啟發了大量後續研究持續改良架構。
從深度到路徑規劃:本講的三個問題
看老師講解(Part 1 · 1:35:30)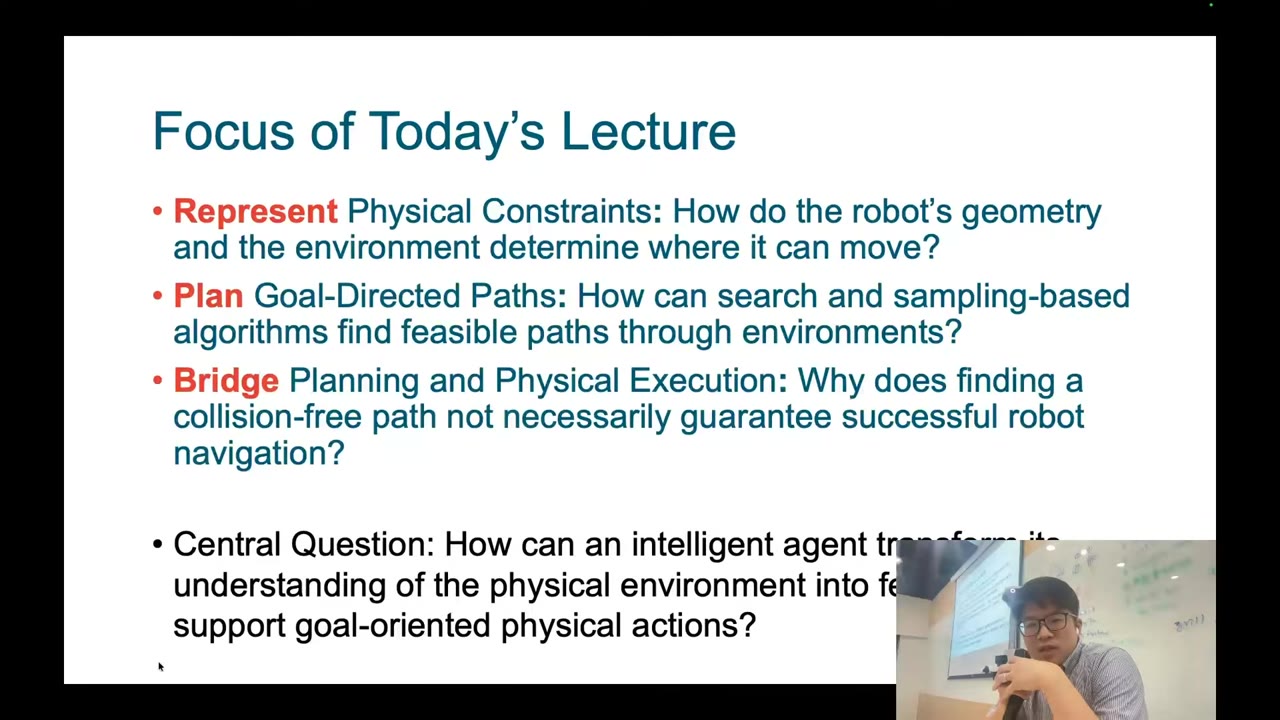
進入新主題前,講者再提一次上週的評估問題:模型 A 的平均深度誤差 2 公分、模型 B 4 公分,只看這個指標會選 A;可是 A 在障礙物附近的誤差高、碰撞率高、導航成功率低。可能的原因是自由空間佔了大量像素,A 在那裡做得好,平均誤差就低;樹幹邊緣只佔少數像素,B 在那裡估得比較準,卻拉不動平均。哪個模型比較好要看應用:要讓 Sid 導航,就不能只最佳化深度估計這一個元件,要把應用放在心上設計評估。
一個機器人導航系統
看老師講解(Part 1 · 1:37:17)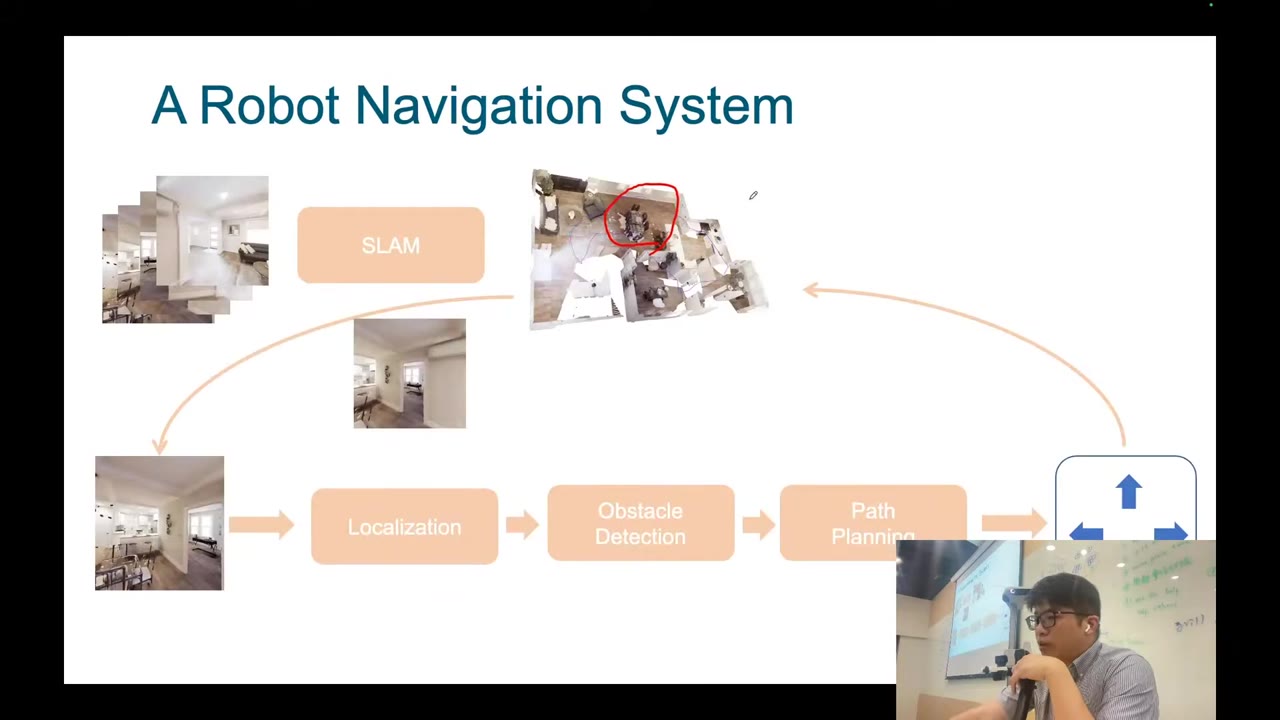
講者用一個例子走過整個流程:假設眼前這個畫面是在飯廳附近拍的,「大概在這裡」還不夠,要知道確切位置,這是定位;接著要知道哪些區域可以進去,這是障礙物偵測;知道自己在哪、障礙物在哪之後才規劃路徑並執行。轉了一點方向,看到的畫面就完全不同,又得重新定位、檢查障礙物、調整路徑。今天聚焦在其中的路徑規劃。
路徑規劃與運動規劃
看老師講解(Part 1 · 1:39:06)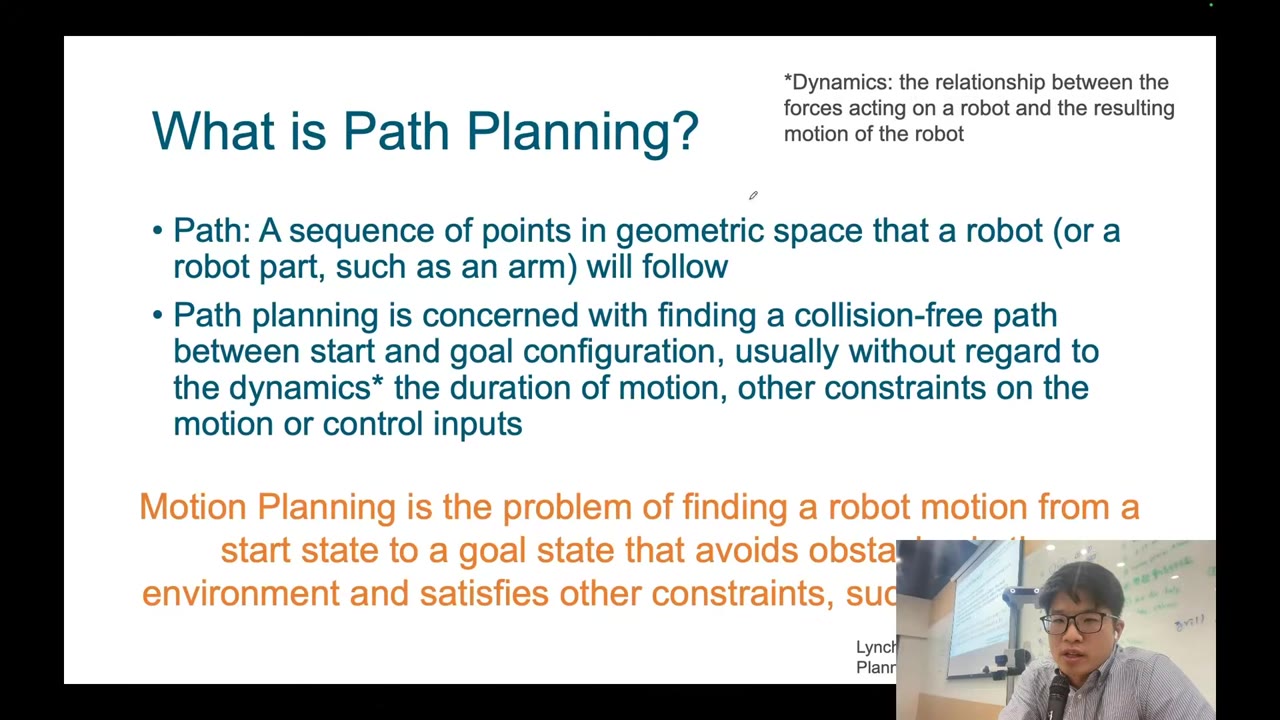
兩者的差別在於考慮多少物理:路徑規劃只問「哪一串點不會撞到東西」,不管力、速度與硬體限制;運動規劃則把機器人與環境的動力學納入考量。想深入的同學,講者推薦投影片下方引用的教科書(作者 Lynch 等人)。
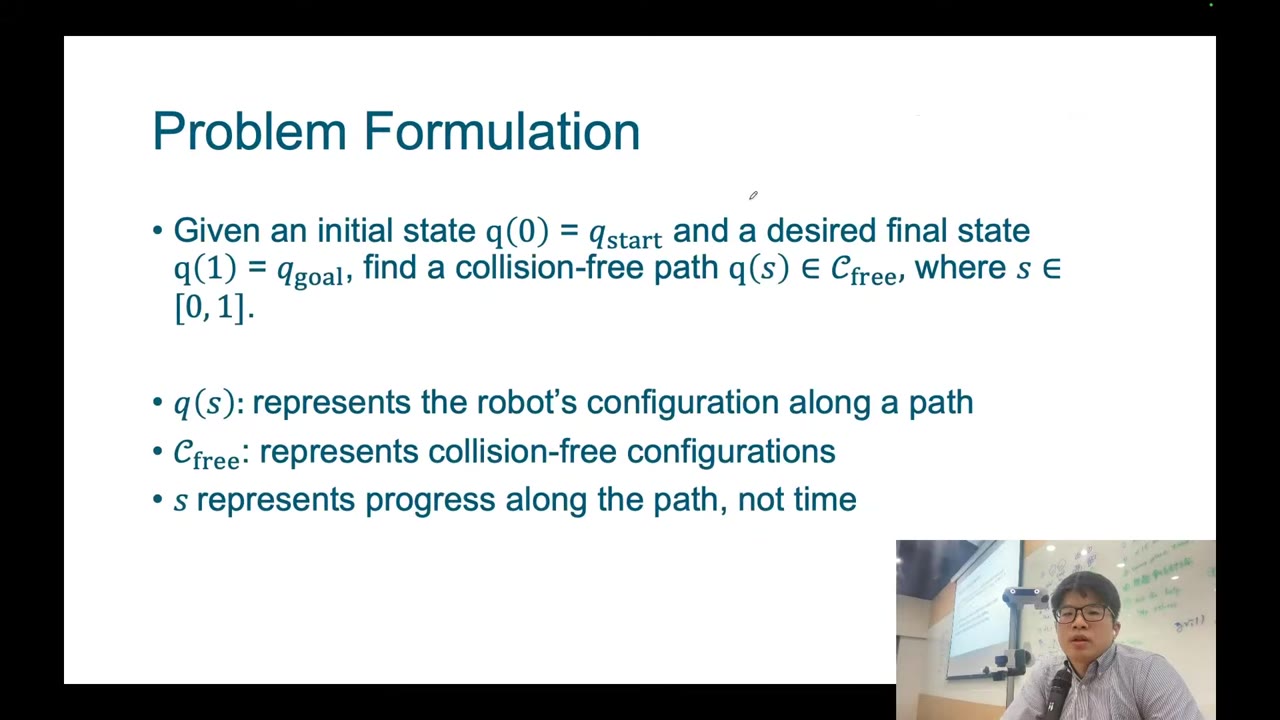
為什麼寫成 q(s) 而不是 q(t)?因為路徑不考慮時間:它只規定從起點到終點要經過哪些點,不規定什麼時刻要到哪裡。一旦要求「在第 t 個時間步到達某一點」,問題就變成了軌跡。
路徑、軌跡與策略
看老師講解(Part 1 · 1:42:23)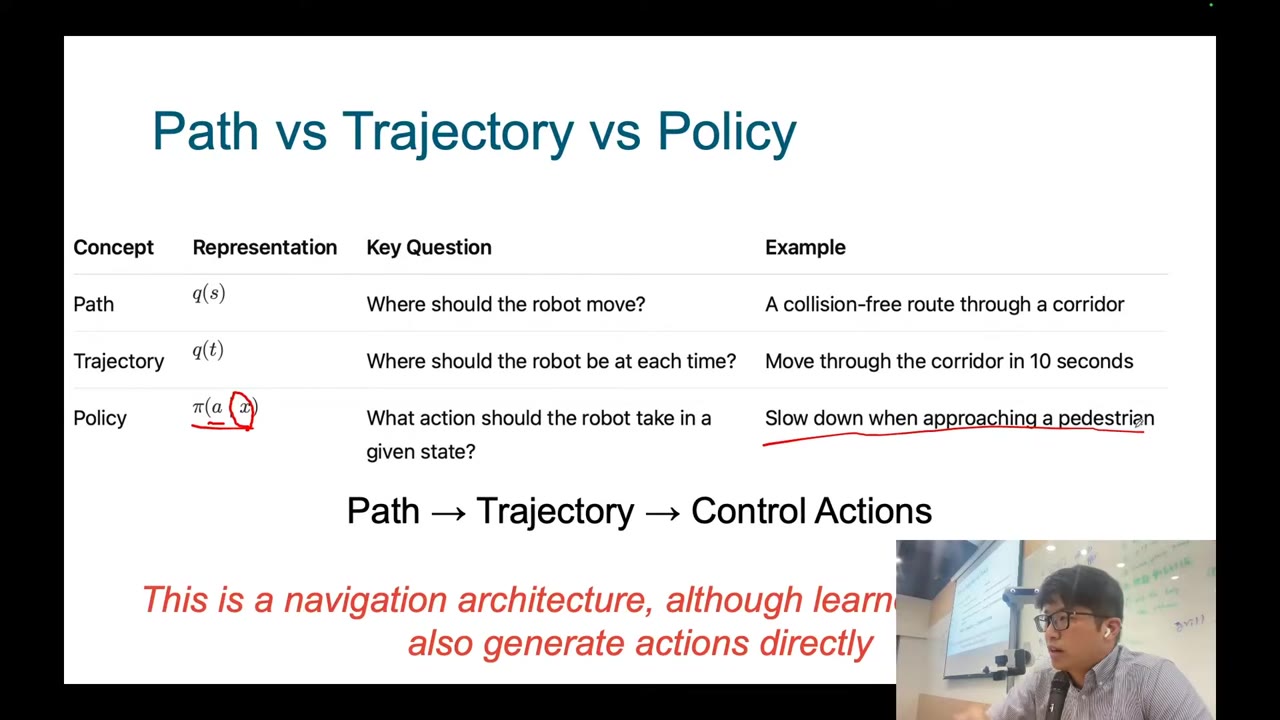
三者回答不同的問題。路徑與軌跡處理的是哪條路不會撞、從 A 到 B 要走多快;策略則是當有東西闖進剛規劃好的路徑——例如迎面走來的行人——要怎麼反應。完整的流程是先規劃無碰撞路徑、再決定什麼時候該到哪(軌跡)、最後是控制。
講者提到,模仿學習或強化學習也可以直接預測路徑、動作或策略,跳過一步一步的拆解;但這門課會先把路徑、軌跡、控制逐一講清楚,因為那些更進階的方法其實也內嵌了同樣的概念。至於近年的方法為什麼想跳過這些步驟,之後再談。
機器人怎麼算出路徑:作業二的範圍
看老師講解(Part 1 · 1:45:56)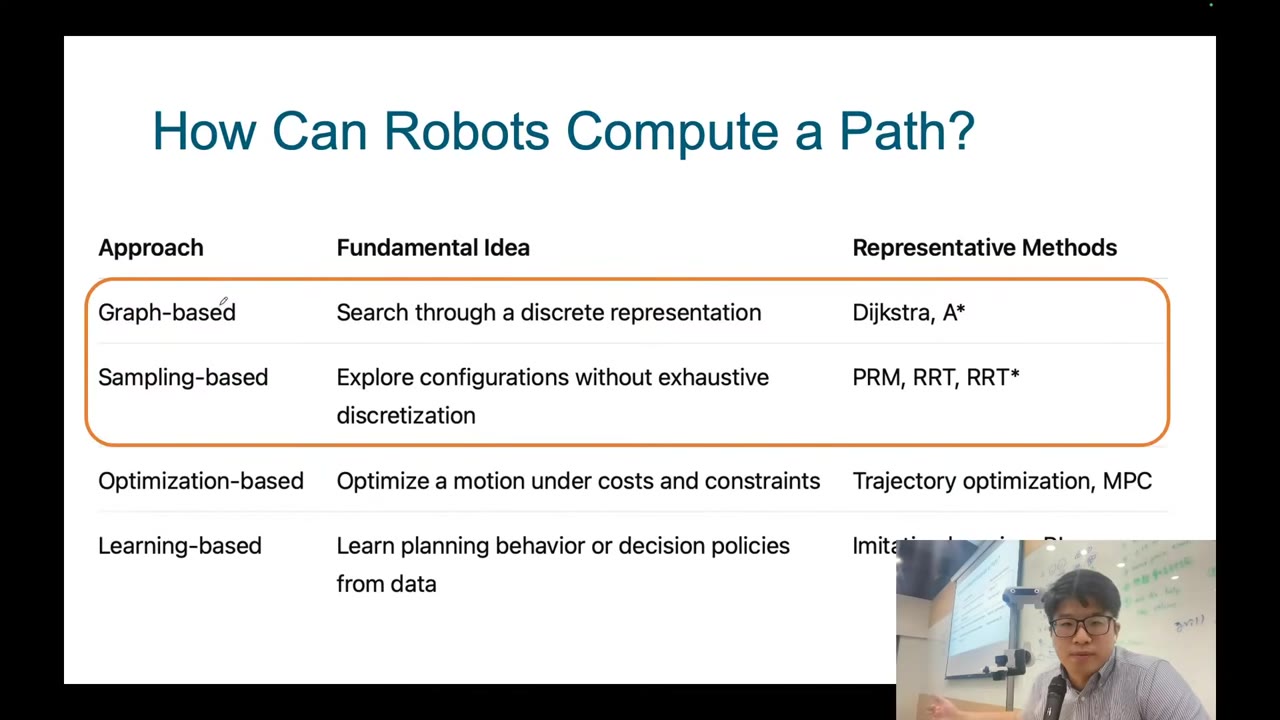
本講只講圖搜尋式與取樣式,作業二要實作的也是這兩類;最佳化式與學習式之後再談。講者也播放了作業二的示意影片:先根據多張影像建立對場景的理解,在環境中規劃一條無碰撞路徑,再控制相機在環境中移動,抵達指定位置——例子是走到冰箱前面。要做到這件事,得從組態空間這個概念開始,最後一路講到取樣式規劃。
表示環境:自由空間不一定可通行
看老師講解(Part 1 · 1:47:25)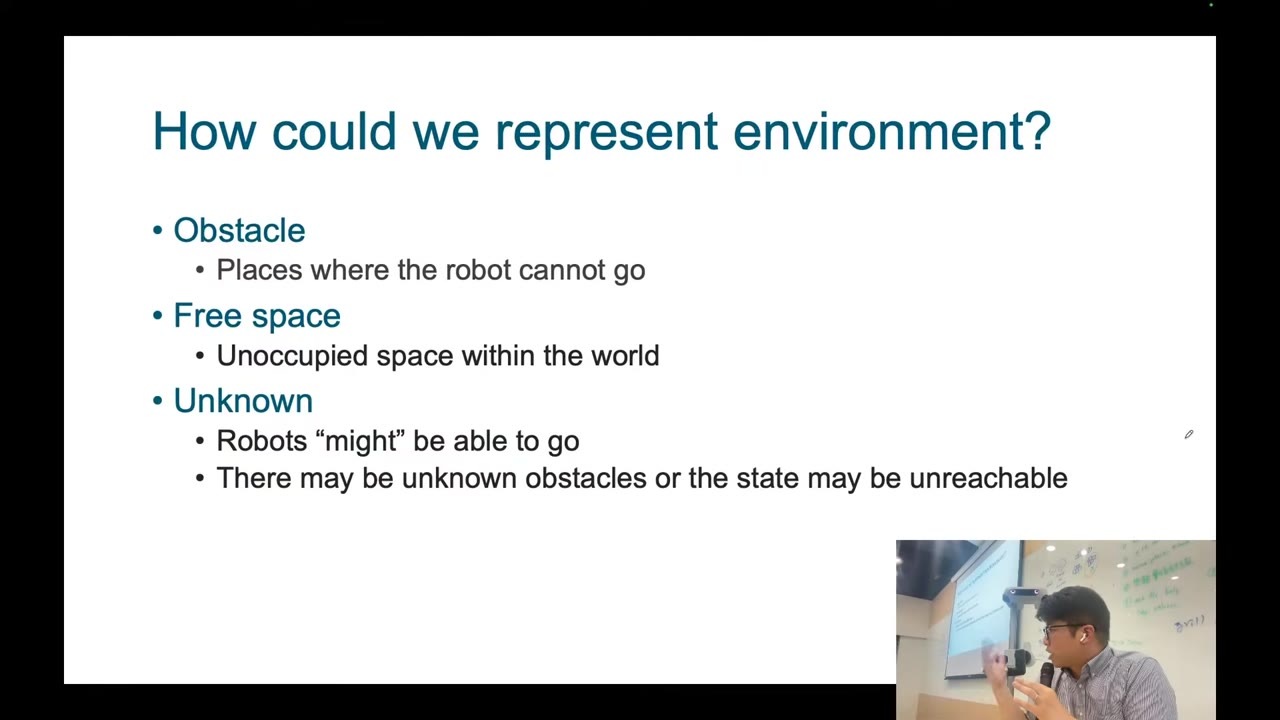
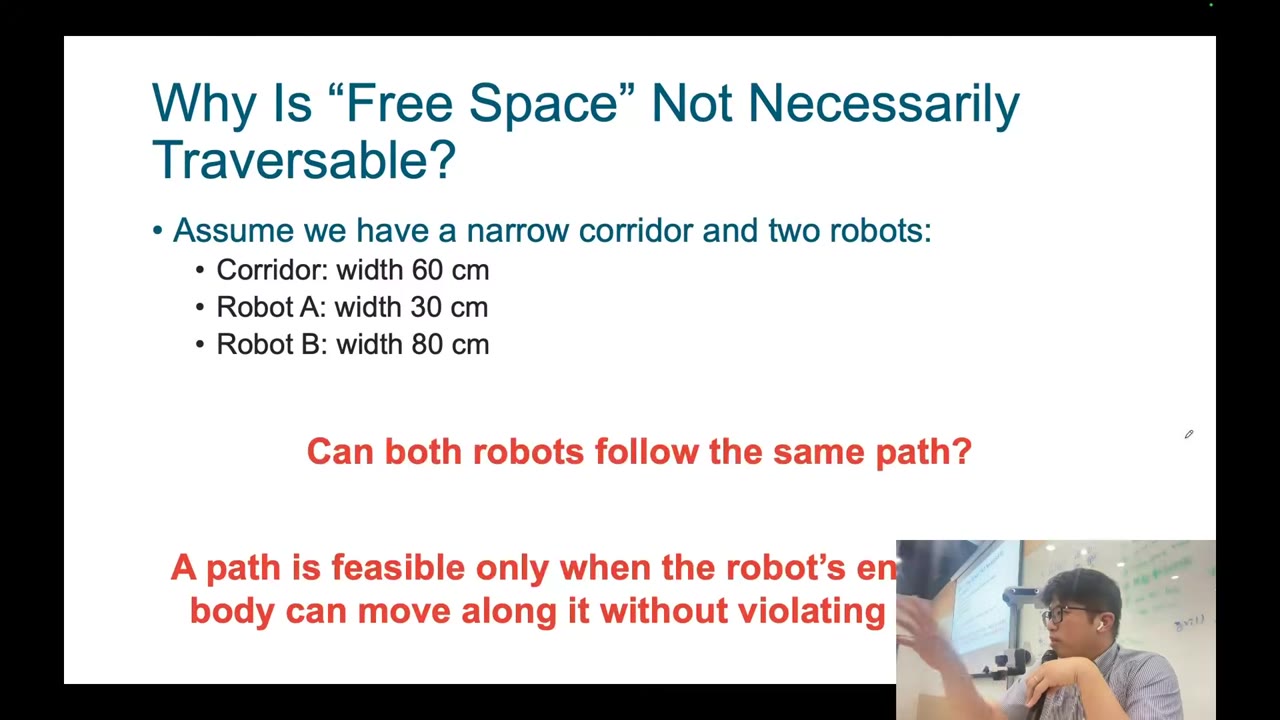
直覺上,只要是自由空間,機器人就不會撞到東西、應該走得過去。但寬 80 公分的機器人 B 顯然過不了 60 公分的走廊。只考慮環境不夠,還要考慮機器人本身長什麼樣子——像 Sid 這樣的身形,走廊再窄一點就過不去了。我們需要一種同時考慮機器人與環境的表示。
組態、自由度與組態空間
看老師講解(Part 1 · 1:50:30)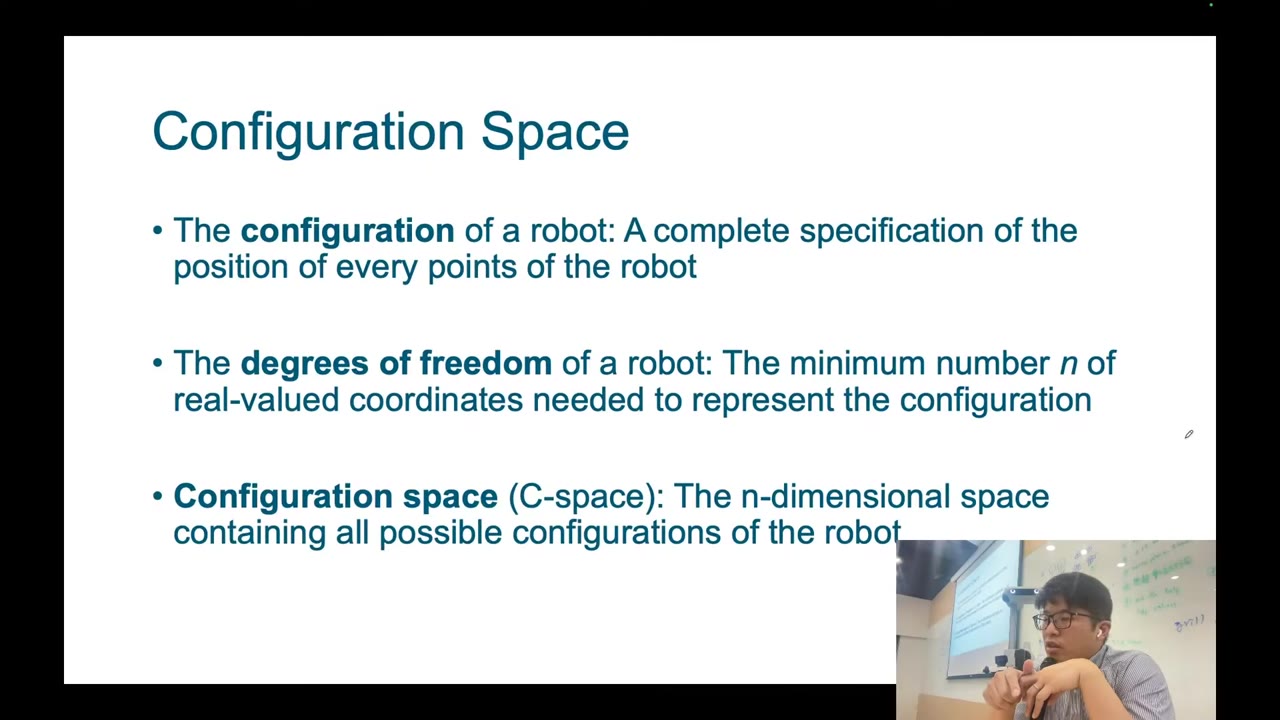
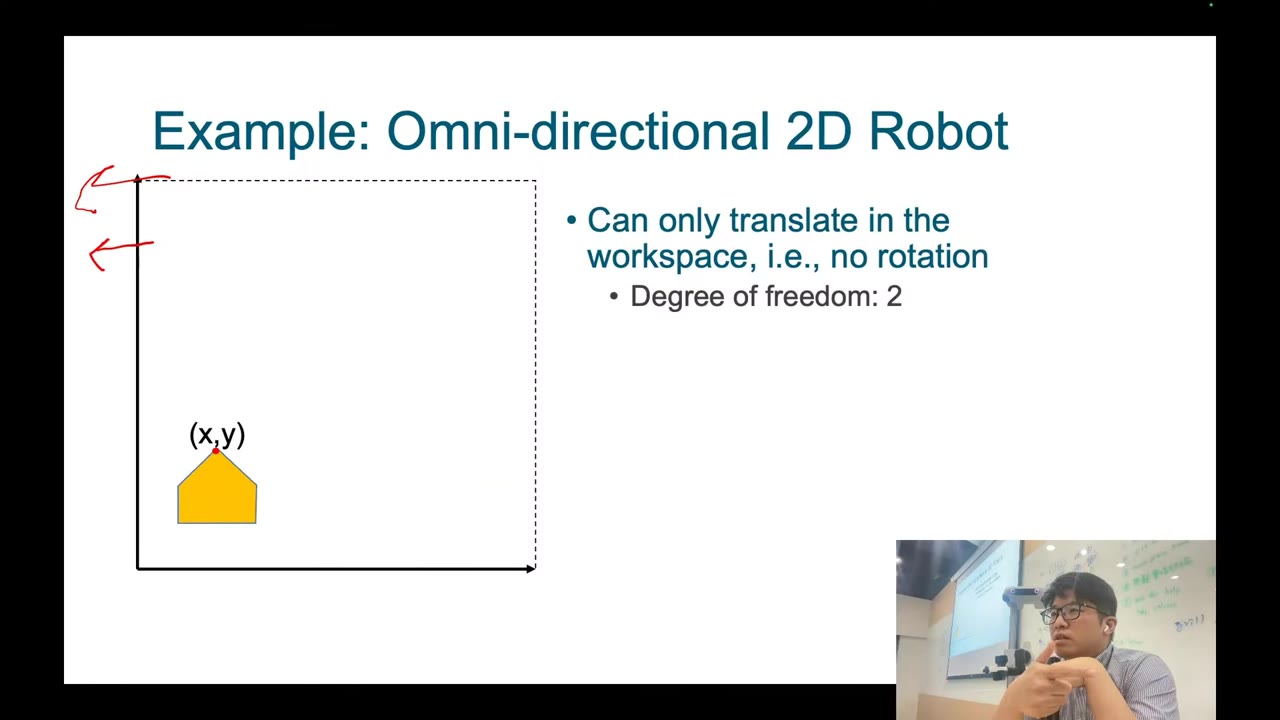
這台機器人只能平移,所以用 x、y 兩個數就能描述它。它最多只能移到矩形工作空間的邊界:再往左或往上,機器人的身體就會撞到邊界。
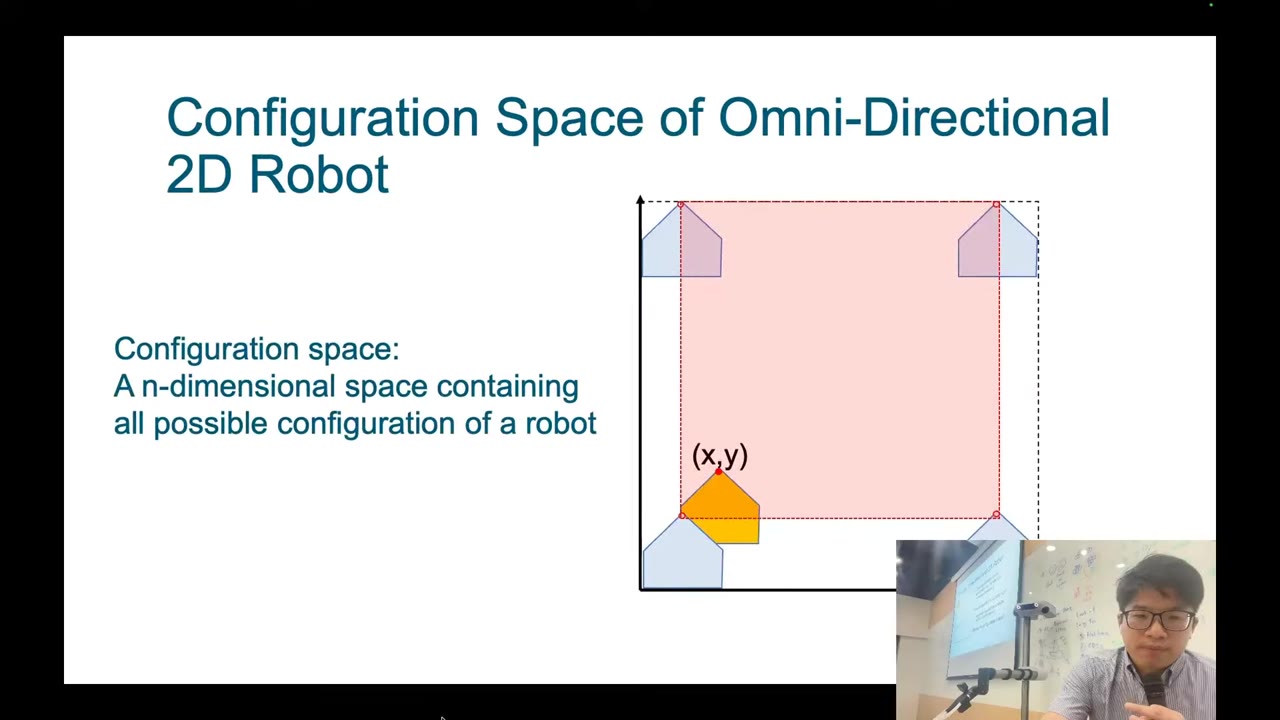
障礙物如何改變組態空間
看老師講解(Part 1 · 1:55:11)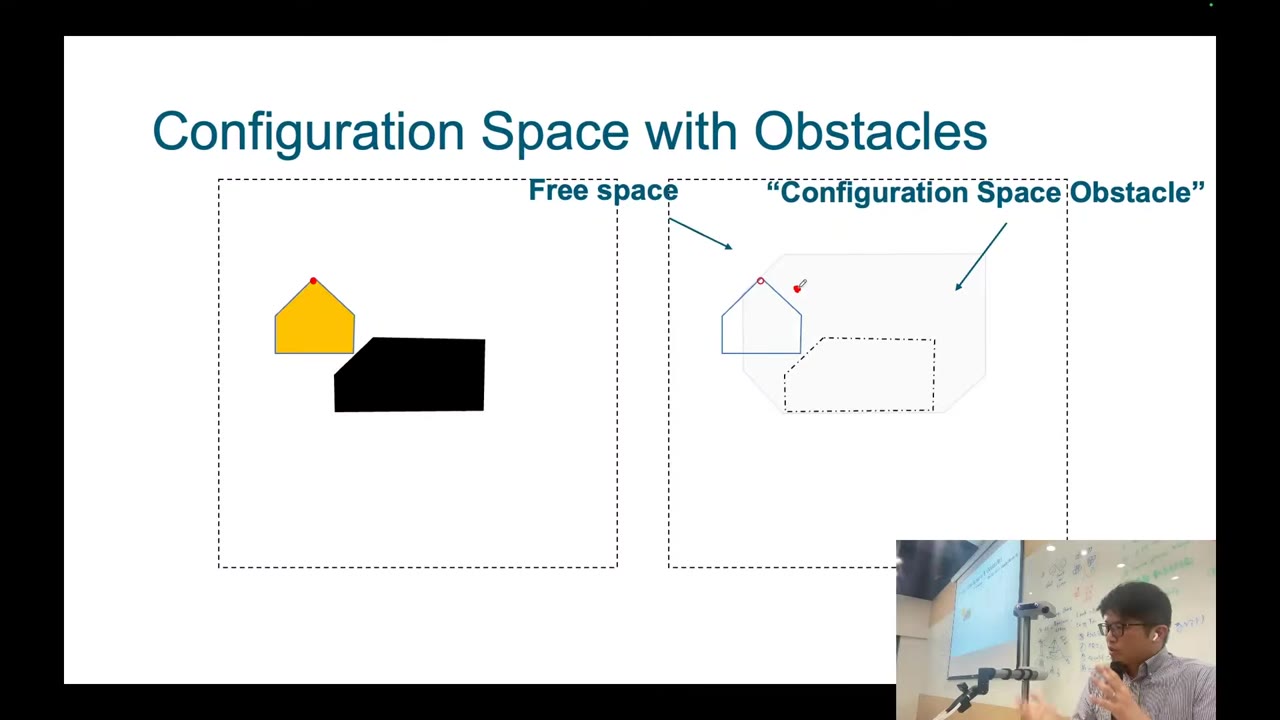
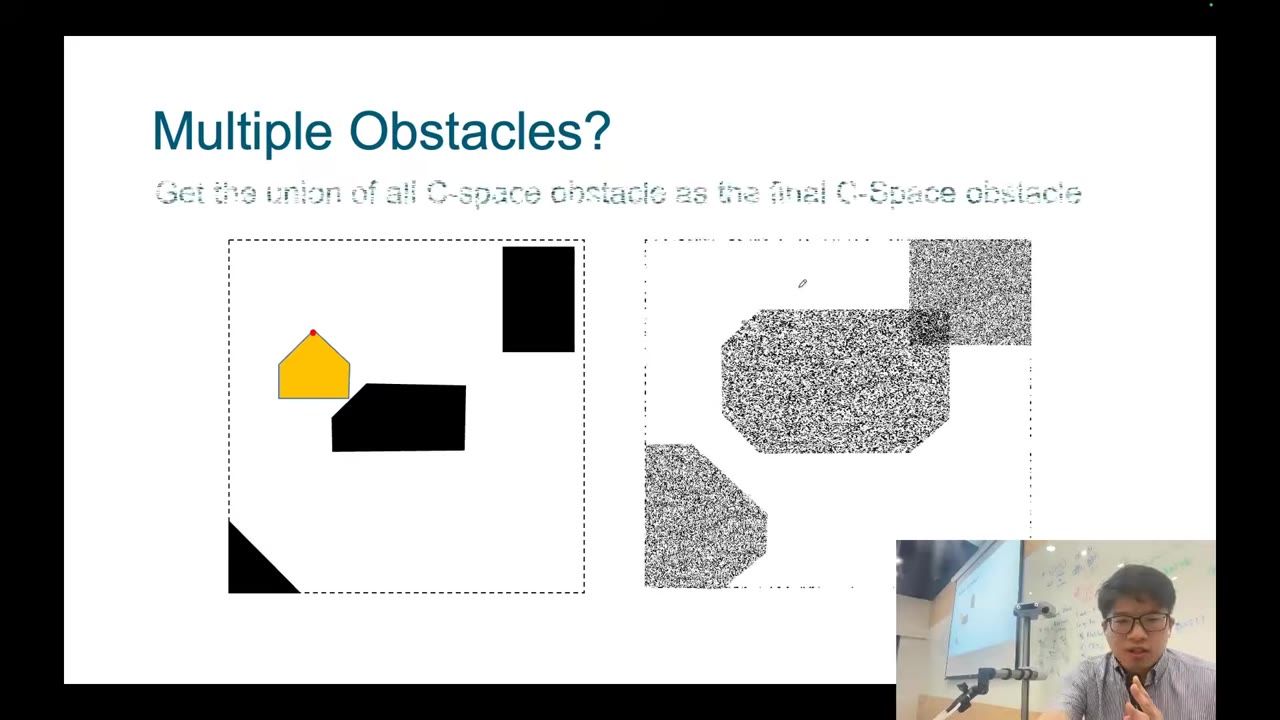
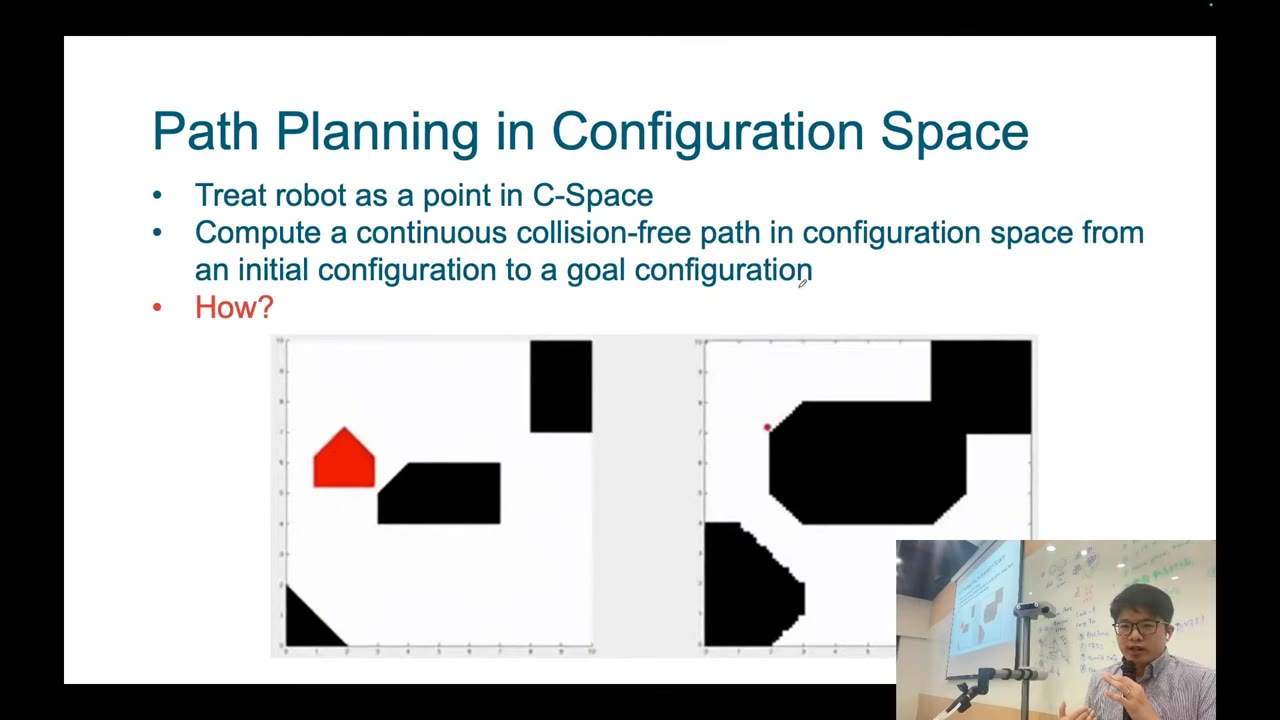
下課後講者把整套轉換再講一次:把「實體機器人+實體障礙物」轉成「點機器人+組態空間障礙」。在新的空間裡,機器人只是一個點,障礙物已經把機器人的身形算進去,剩下的區域就是這個點可以自由移動的自由空間。
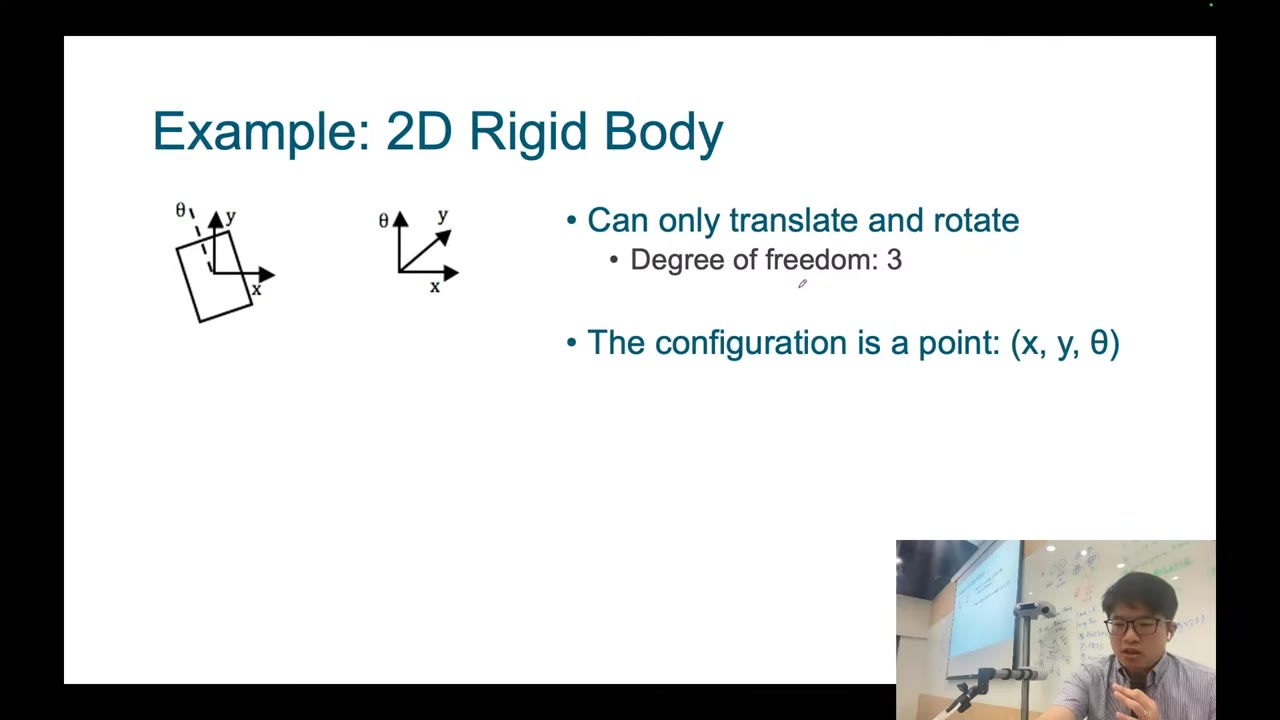
如果機器人除了平移還能旋轉,自由度就變成三,多了角度 θ。轉到不同角度,機器人的身形相對於障礙物就不同,組態空間也跟著改變。第一段錄影在這裡結束;在組態空間中具體怎麼搜尋路徑,接續在下面第二段錄影的各節。
第二段:從視覺觀測到可導航的地圖
看老師講解(Part 2 · 1:52)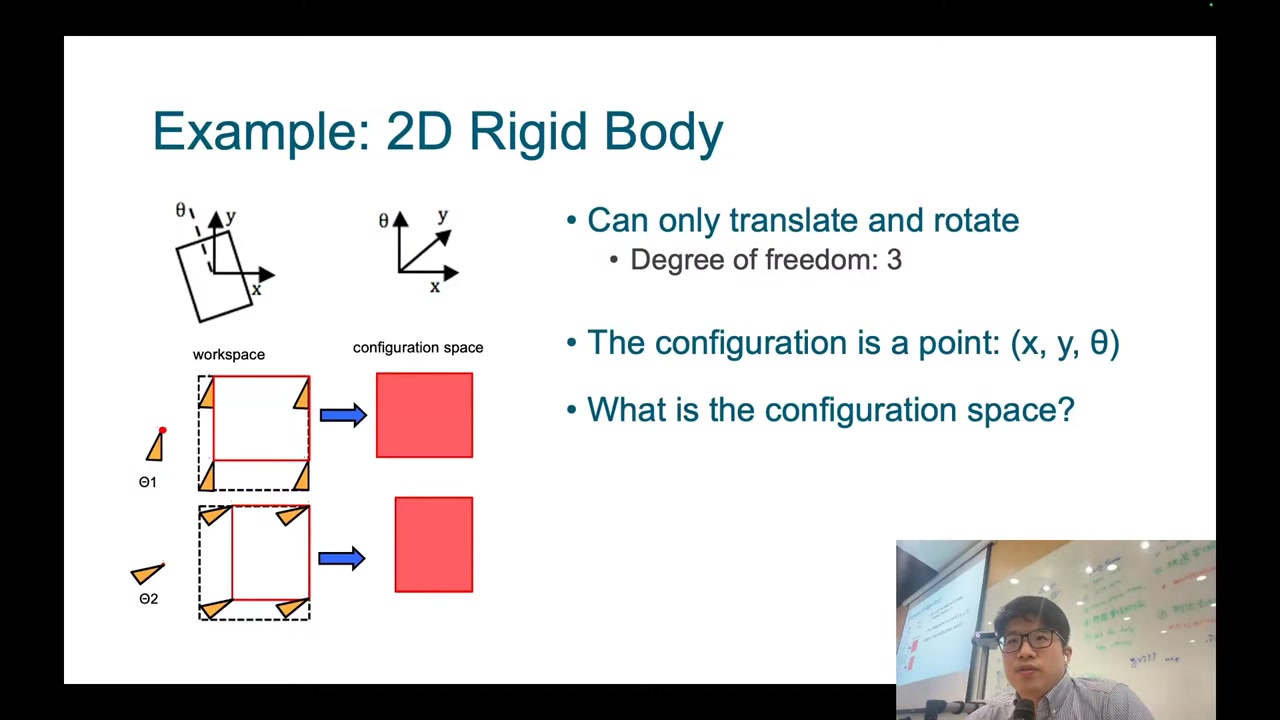
第二段錄影從下課後接續(講者先為前一段線上收音中斷致歉)。他把上一段的重點再講一次:全向機器人只有 x、y 兩個自由度;能旋轉之後,每個角度都有自己的組態空間,轉動的過程中組態空間一直在變。只往前走時,組態空間只取決於機器人本身與周遭物體;一旦開始轉,就得把角度一起算進去。
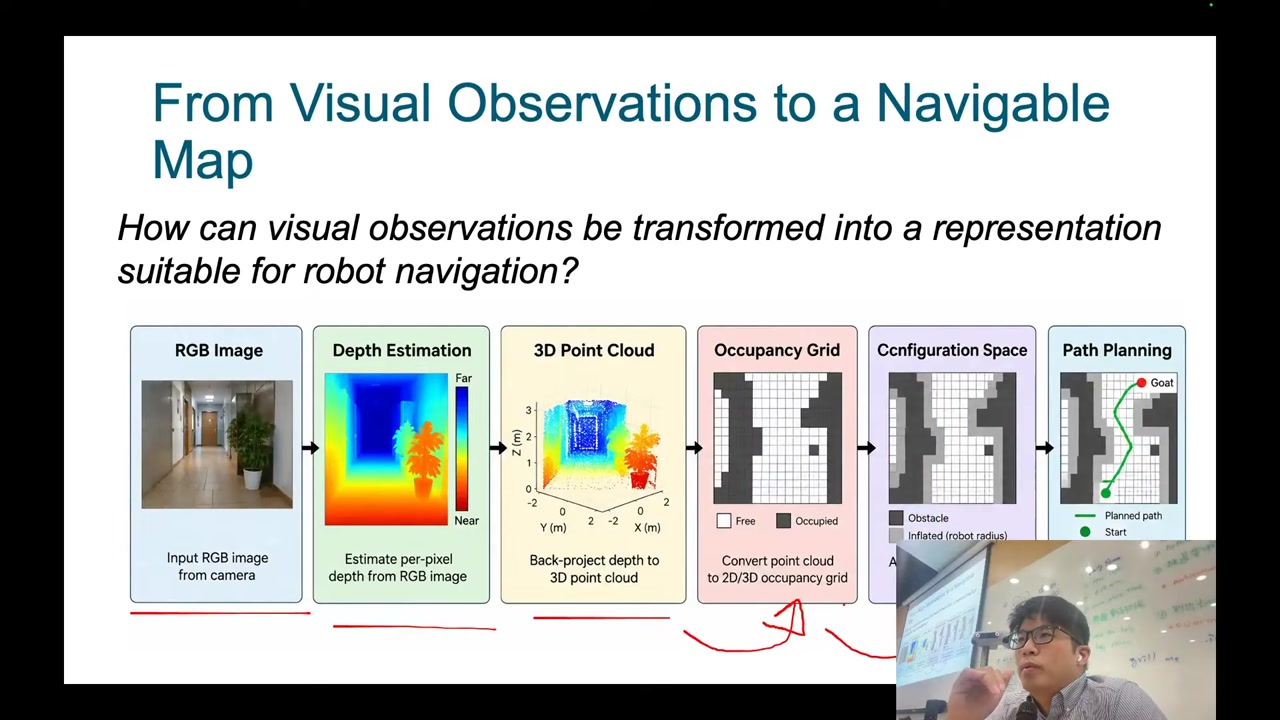
在講怎麼規劃之前,講者先把前兩講接起來:視覺觀測要怎麼變成適合機器人導航的表示?有了多張觀測,就能估計深度、轉成點雲;從上往下看點雲,就得到鳥瞰視角的佔用網格,告訴我們每一格有沒有被佔用;再把機器人的實體性質納入,就是組態空間,最後才在上面規劃路徑。
網格與佔用網格
看老師講解(Part 2 · 4:48)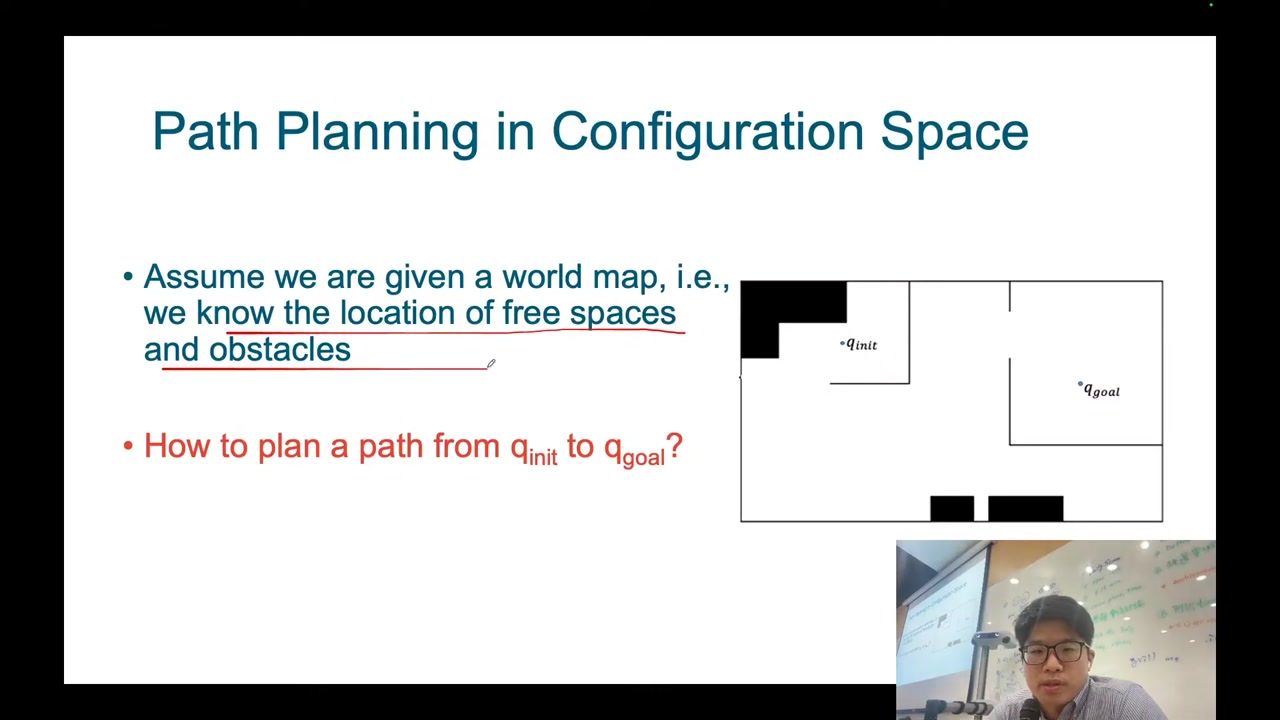
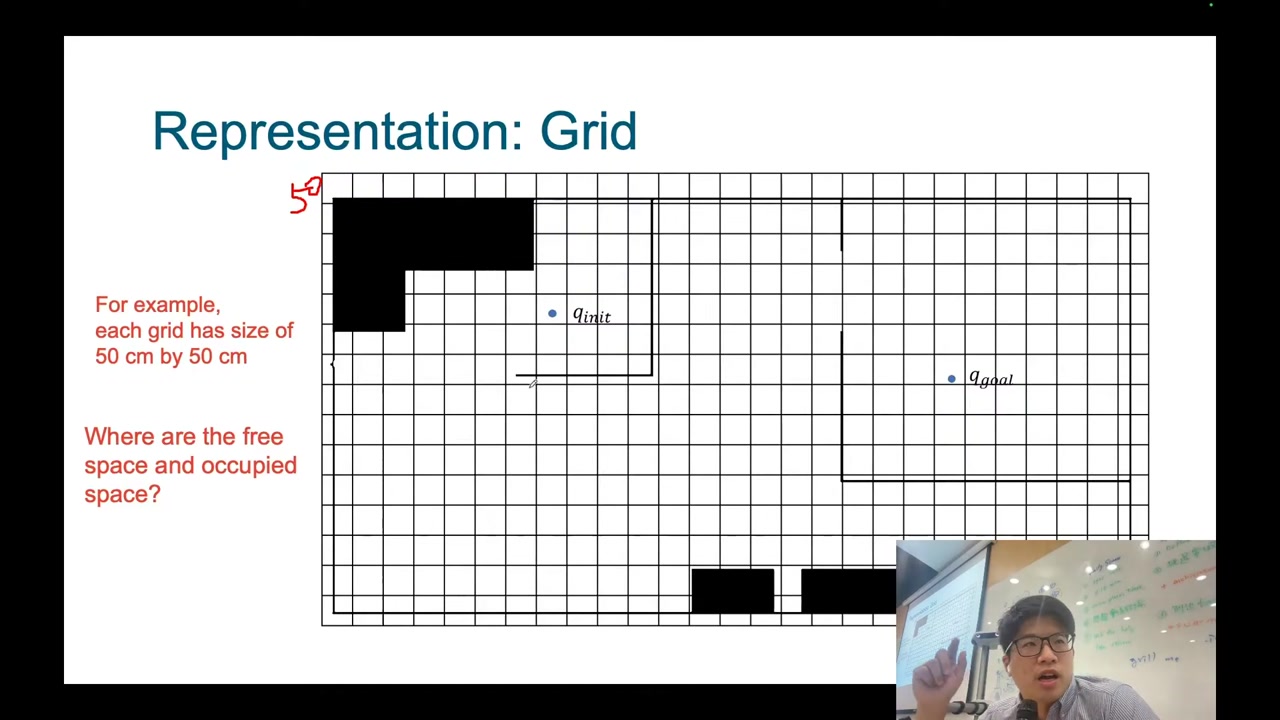
判斷方式很直接:格子裡有東西,就是被佔用。投影片左上的黑色區塊是櫃子,外框是牆,凡是與它們重疊的格子都標成被佔用(黃色),其餘是自由空間。前後對照兩張投影片,就能看出每一格為什麼被標成佔用。
加入機器人尺寸:從佔用網格到組態空間
看老師講解(Part 2 · 9:08)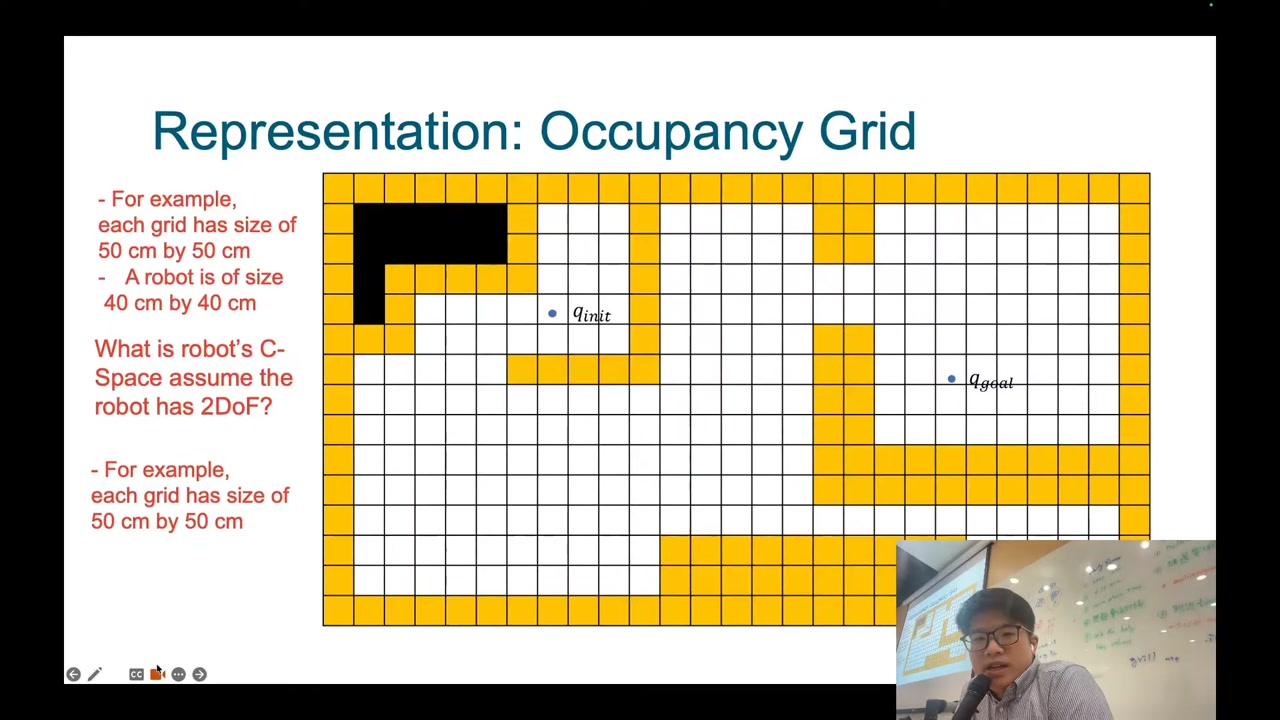
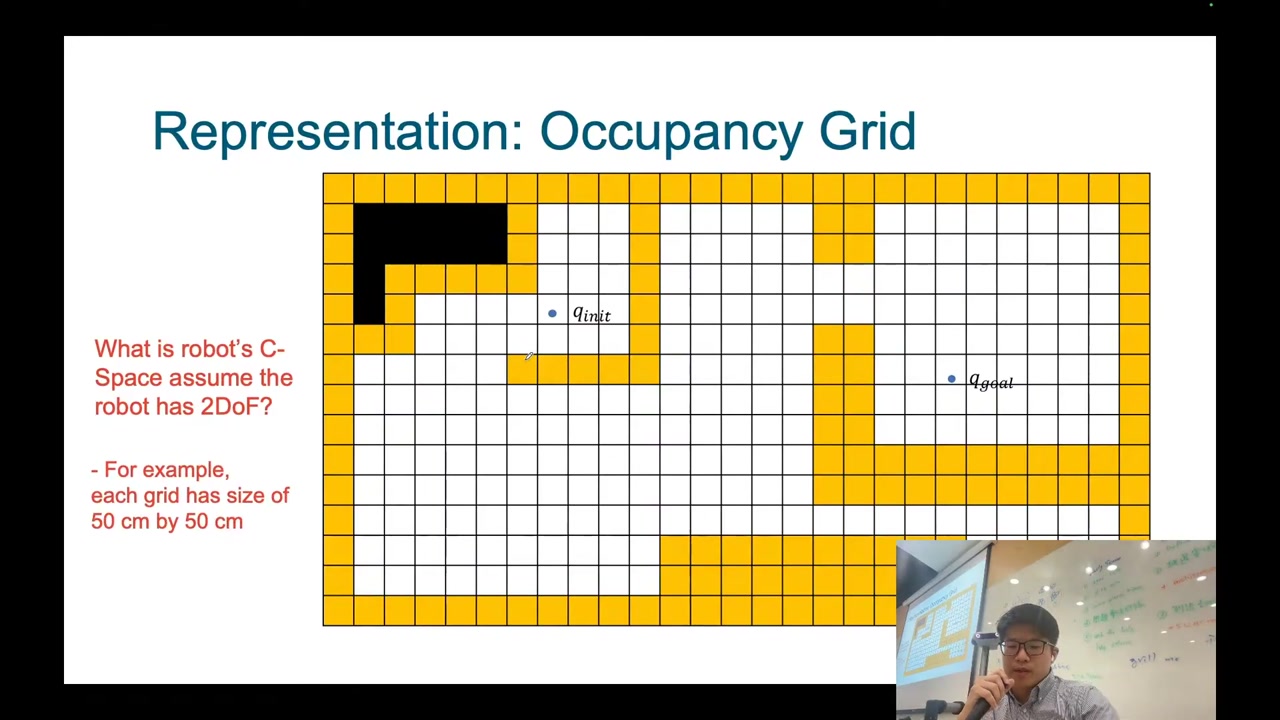
佔用網格還不是組態空間。要到組態空間,還得把機器人的實體算進去:40 公分的機器人幾乎佔滿一整格,只要靠近被佔用的格子就會撞上,所以障礙物旁邊的格子也不能進去。
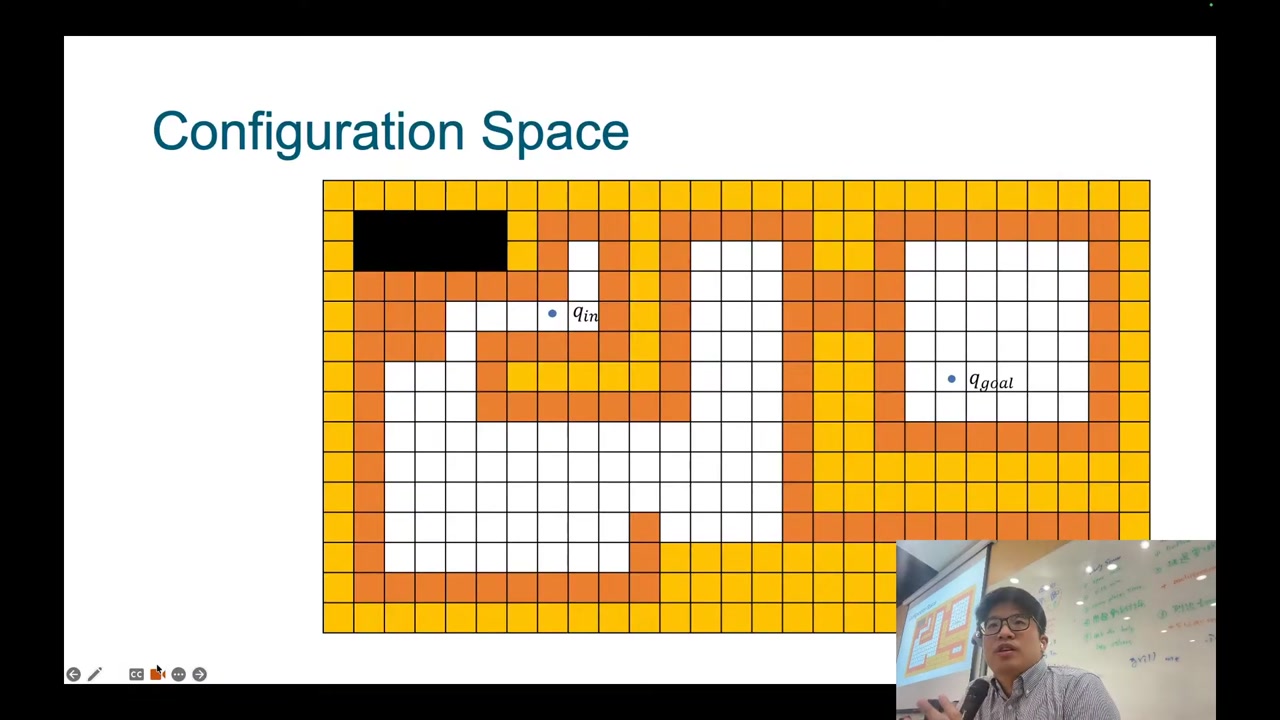
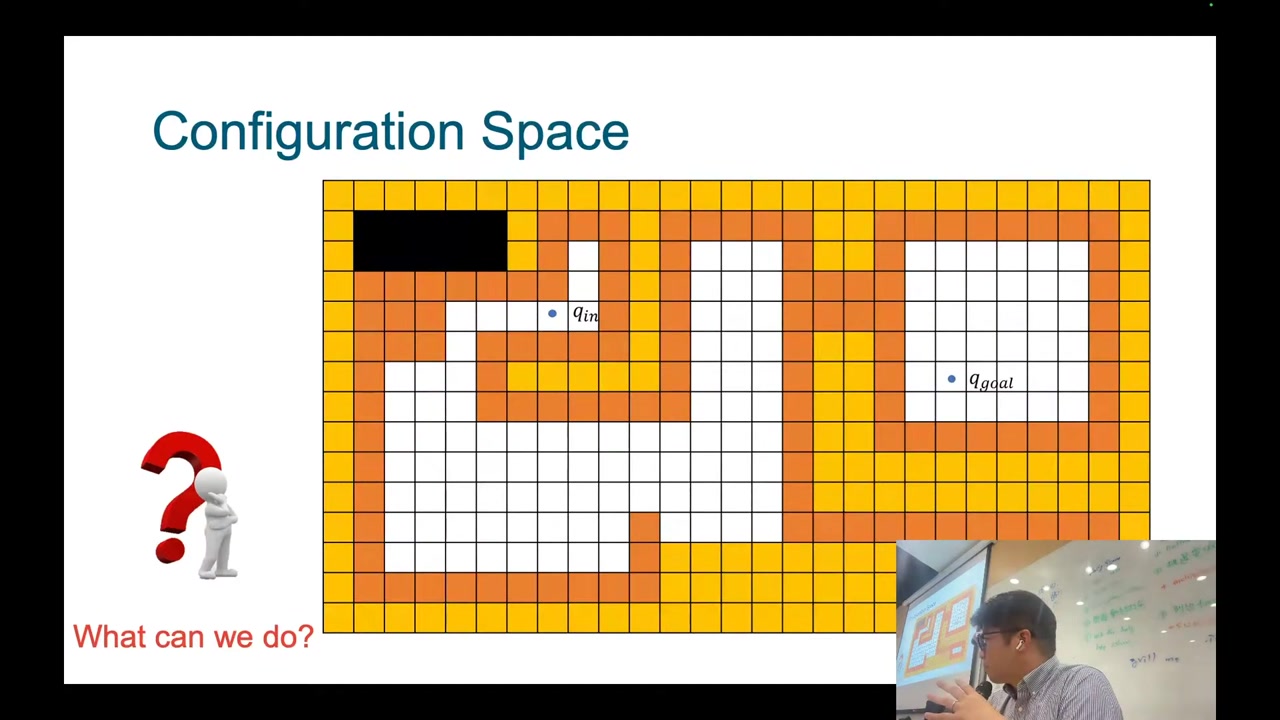
講者請大家回頭看整個流程是怎麼設計的:先選了 50 公分的網格解析度,再決定哪些格子被佔用,最後依機器人大小生成組態空間。有同學答:把網格改小。解析度變細,就有機會從原本被整格封死的縫隙中走過去。代價是什麼?同學答:計算量——格子數量增加,計算就變大。
把規劃當成搜尋:BFS 與 A*
看老師講解(Part 2 · 14:49)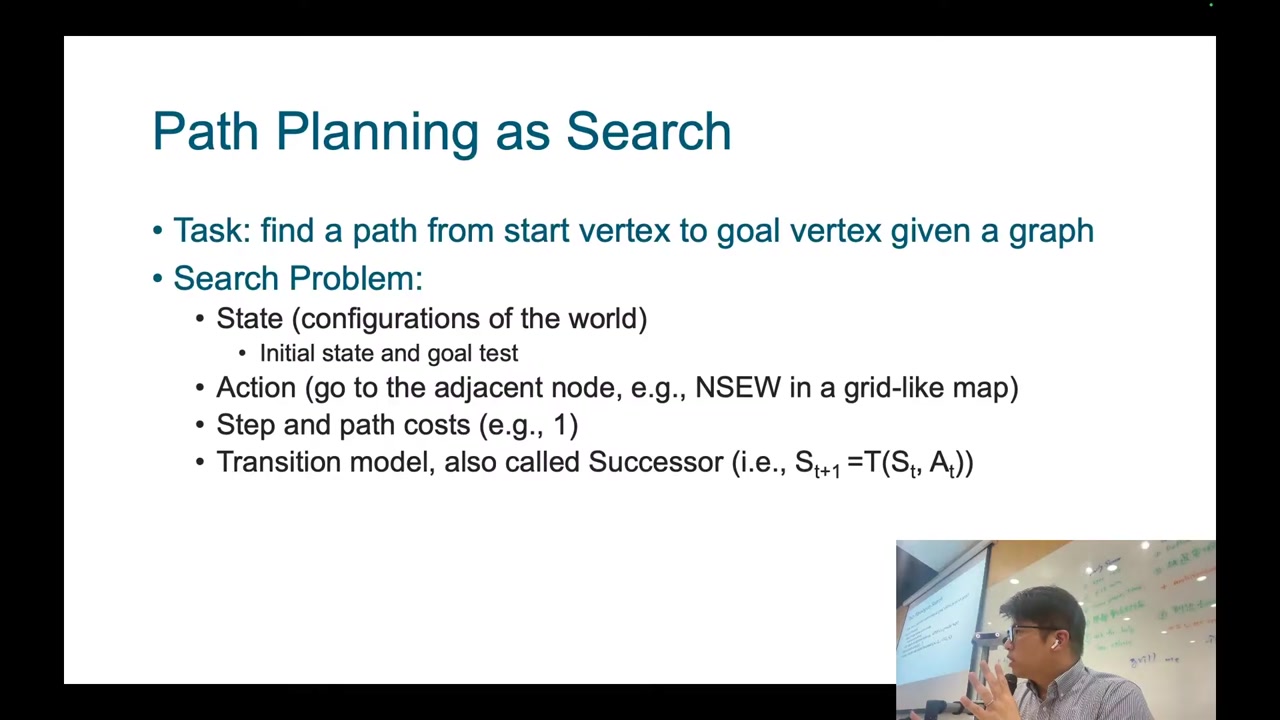
講者問大家有沒有修過人工智慧概論、學過 A* 或其他圖搜尋。因為細講要花不少時間,他決定跳過這部分投影片,請同學自行閱讀教科書與投影片上的連結,只用一個互動 demo 讓大家有概念。
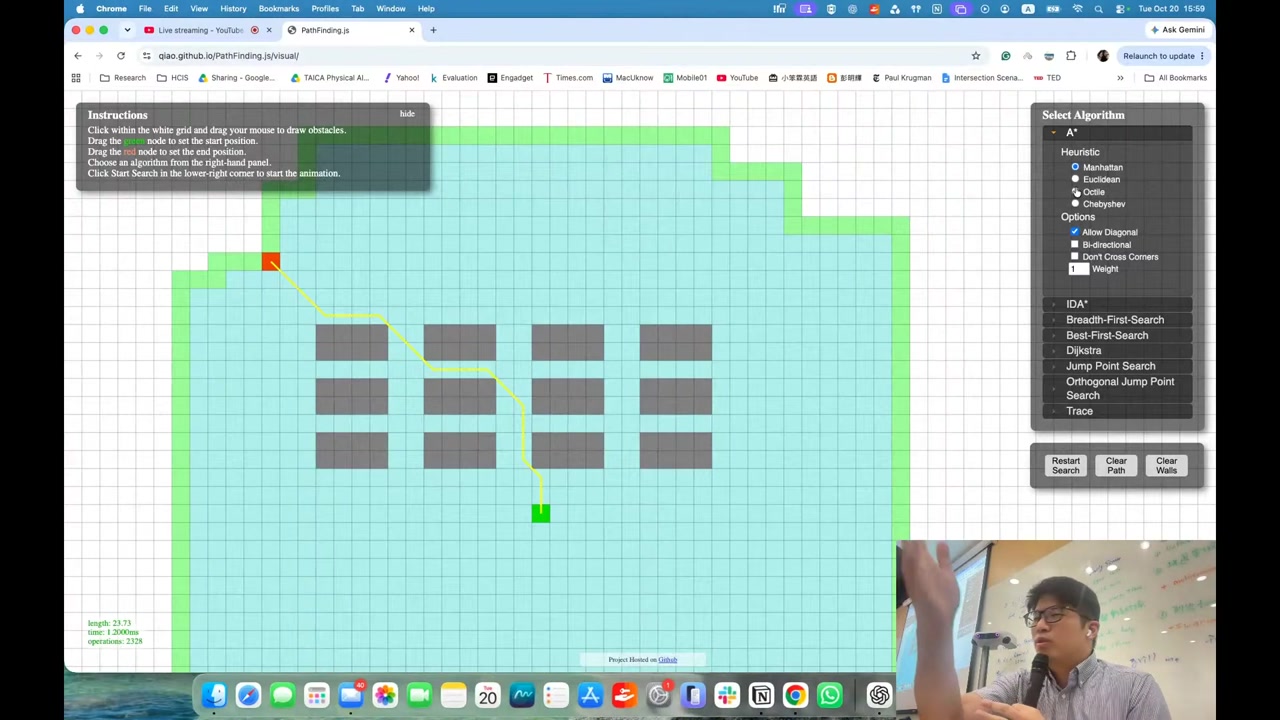
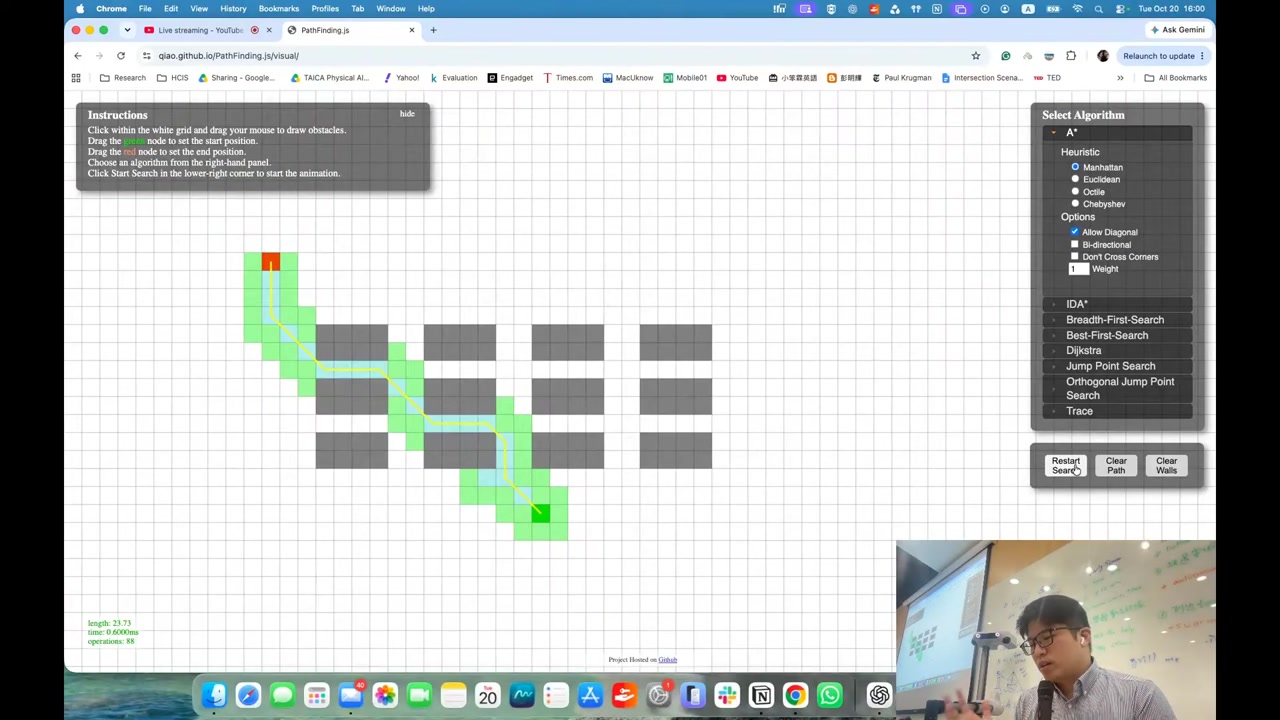
BFS 與 A* 的差別在於有沒有把目標資訊納入:A* 每一步都會問「我離目標更近了嗎?」,用的就是啟發函式(heuristic function)。演算法的細節,講者建議沒學過的同學回頭看 A* 的介紹;demo 用的網頁也很適合用來比較不同搜尋演算法。
能不能搜遍所有組態?自由度與維度爆炸
看老師講解(Part 2 · 19:52)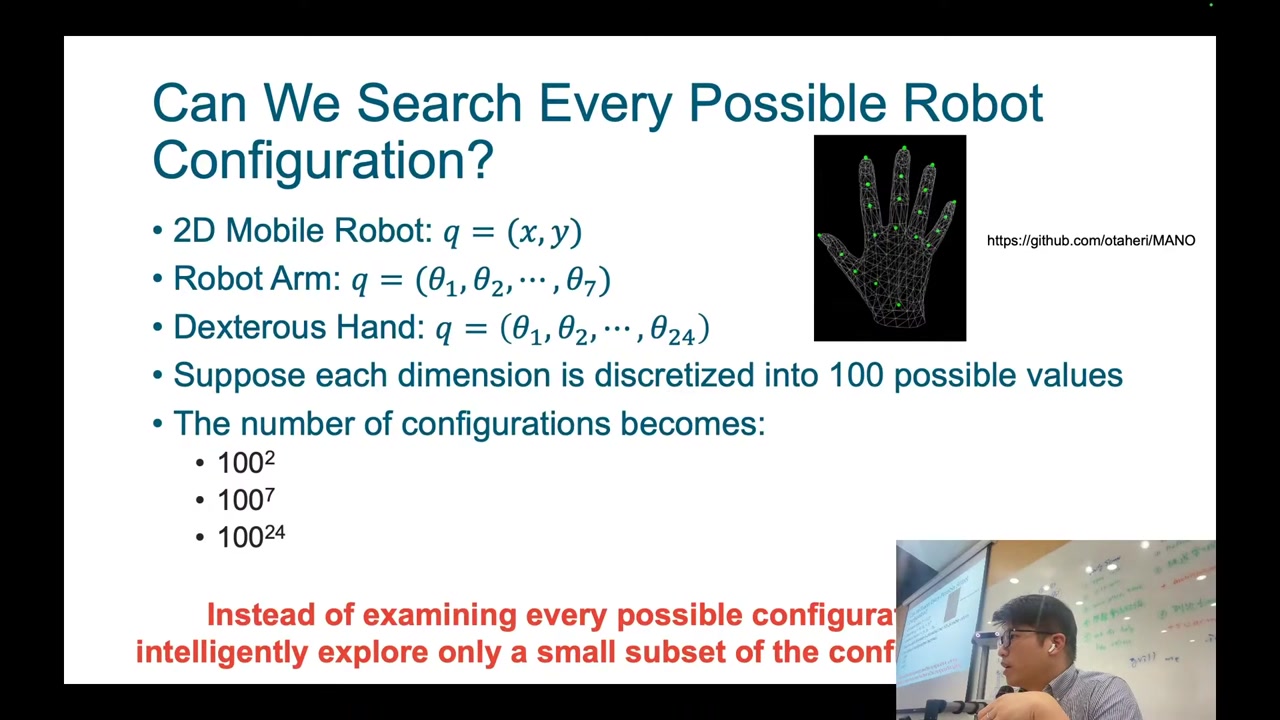
網格法在 2 個自由度時沒問題,解析度調細一點也還算得動。可是機械手臂有 7 個自由度,靈巧手有 24 個;每個維度都離散化,組態數量就隨自由度指數成長,計算上根本不可行。自由度越高,越不可能一一檢查每個組態。
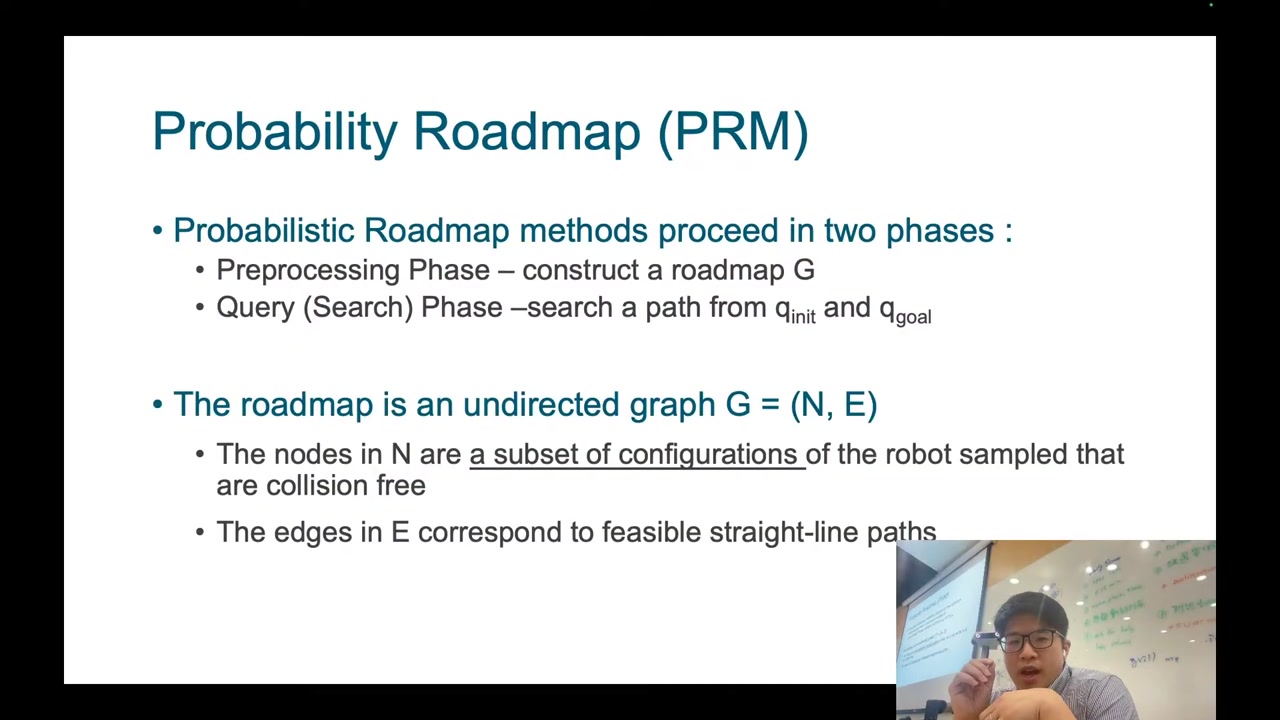
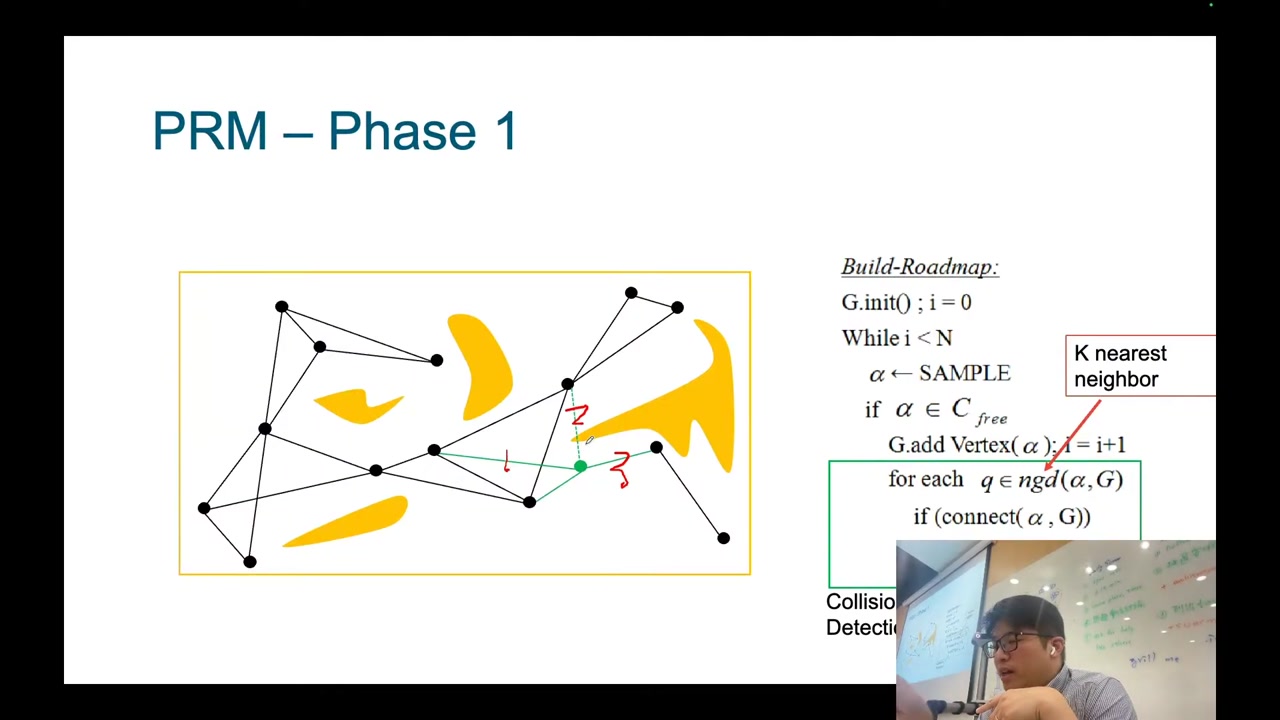
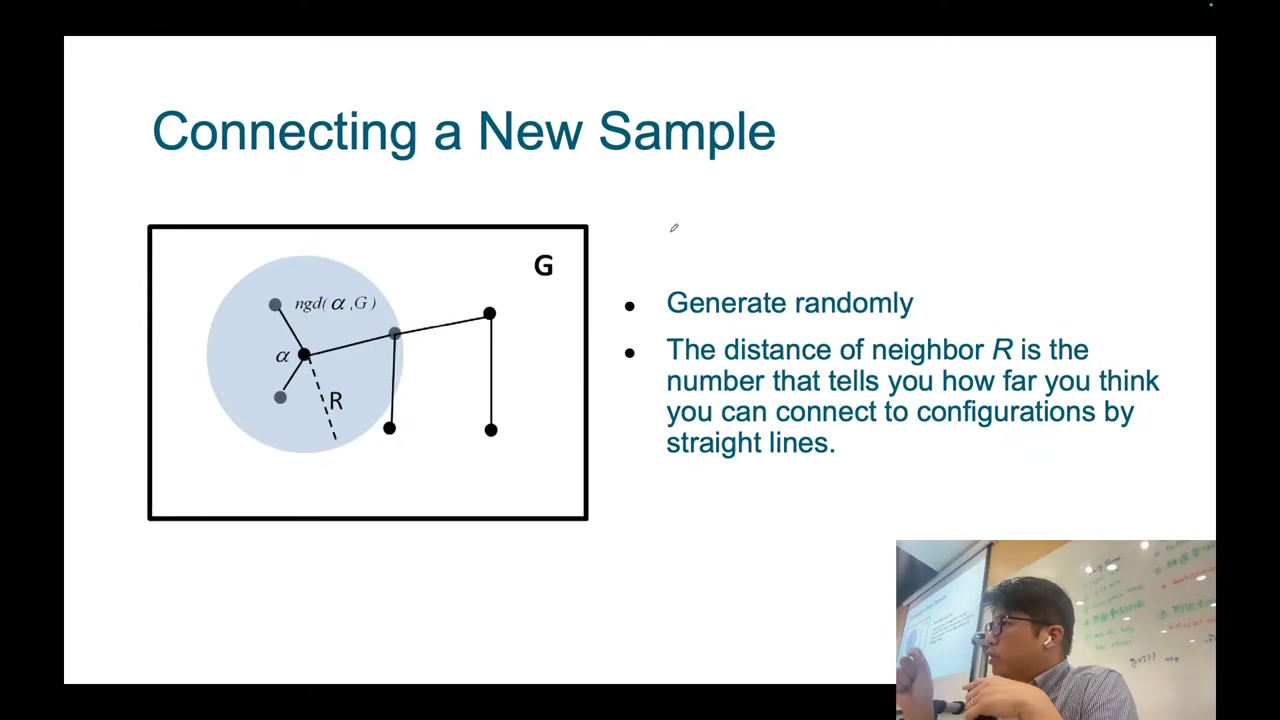
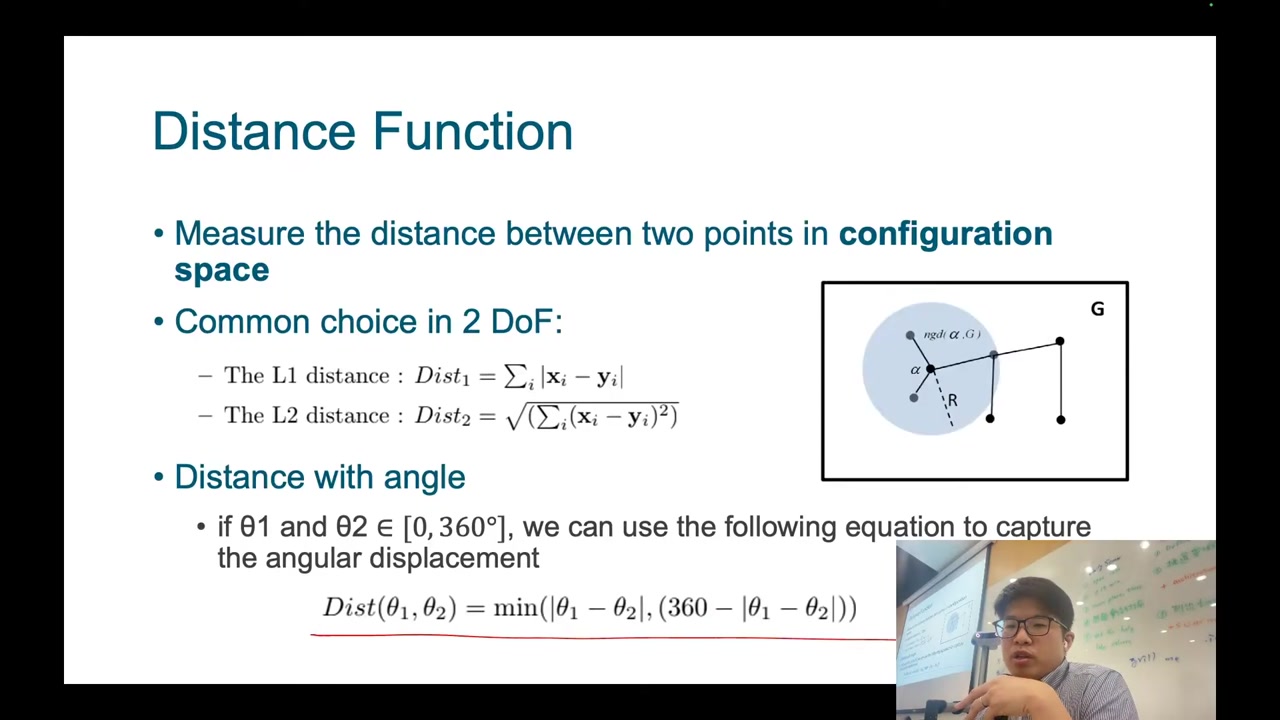
取樣式規劃:PRM 的建圖階段
看老師講解(Part 2 · 22:19)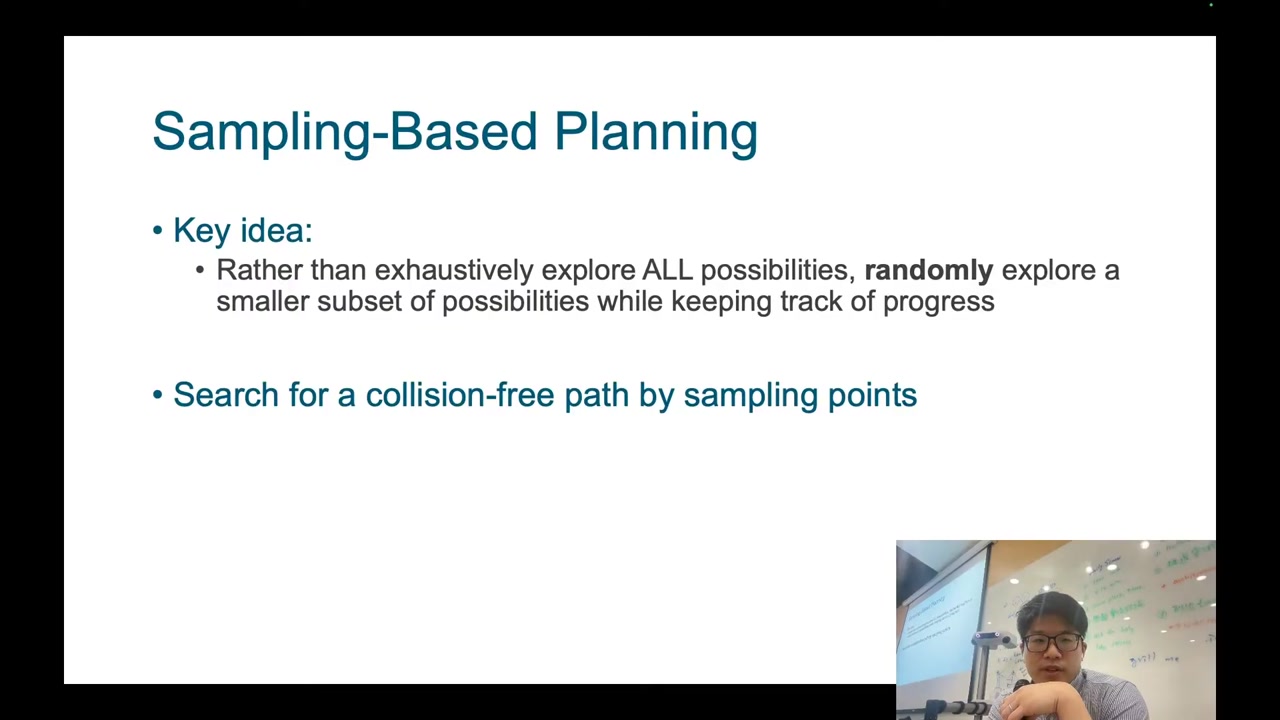
講者說今天大概講不完取樣式方法,先講 PRM;另一個演算法 RRT 留到下週,而 RRT 就是作業二要實作的演算法。和網格法要維護整個離散化的表示不同,取樣式方法只探索、記錄一部分組態,在這些取樣點之間找無碰撞路徑。
PRM 的查詢階段,與狹窄通道的難題
看老師講解(Part 2 · 27:23)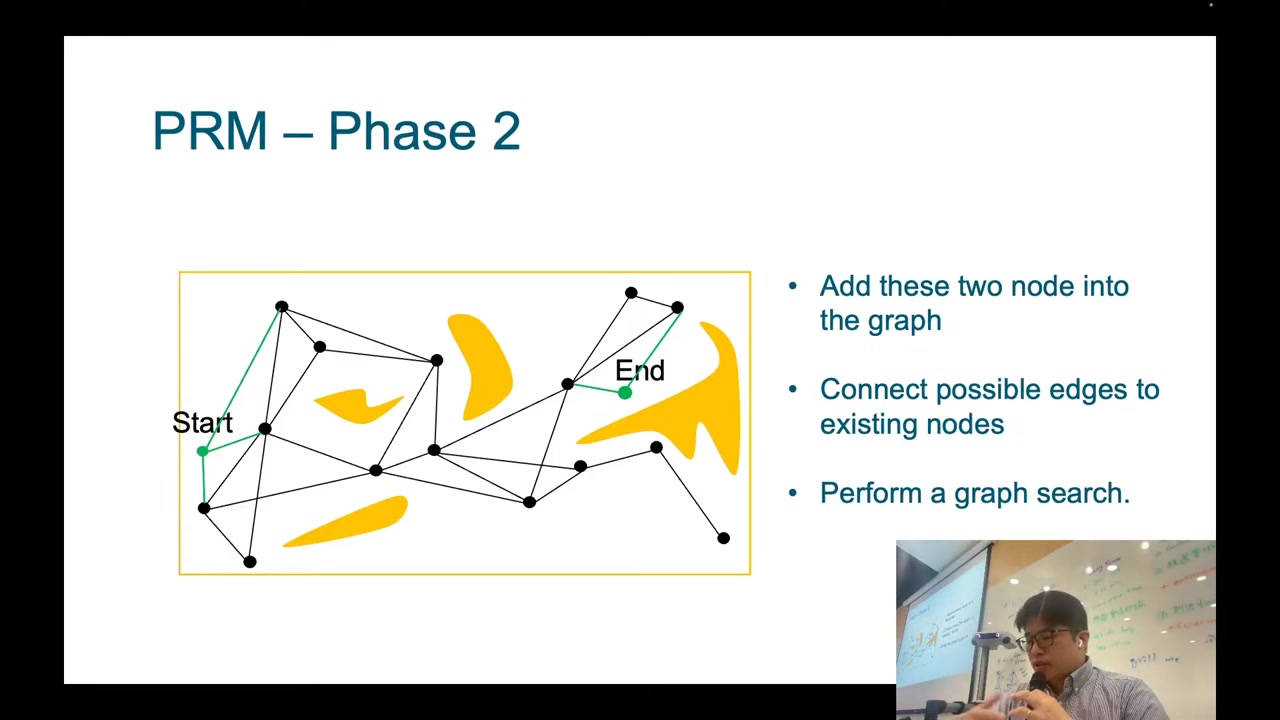
講者再強調一次為什麼要講 PRM:不想把整個空間離散化,只想考慮一部分組態。PRM 先建一張只含部分組態的圖,再把起點與終點接上去,用圖搜尋找無碰撞路徑——和前面把整個空間切成網格的作法很不一樣。
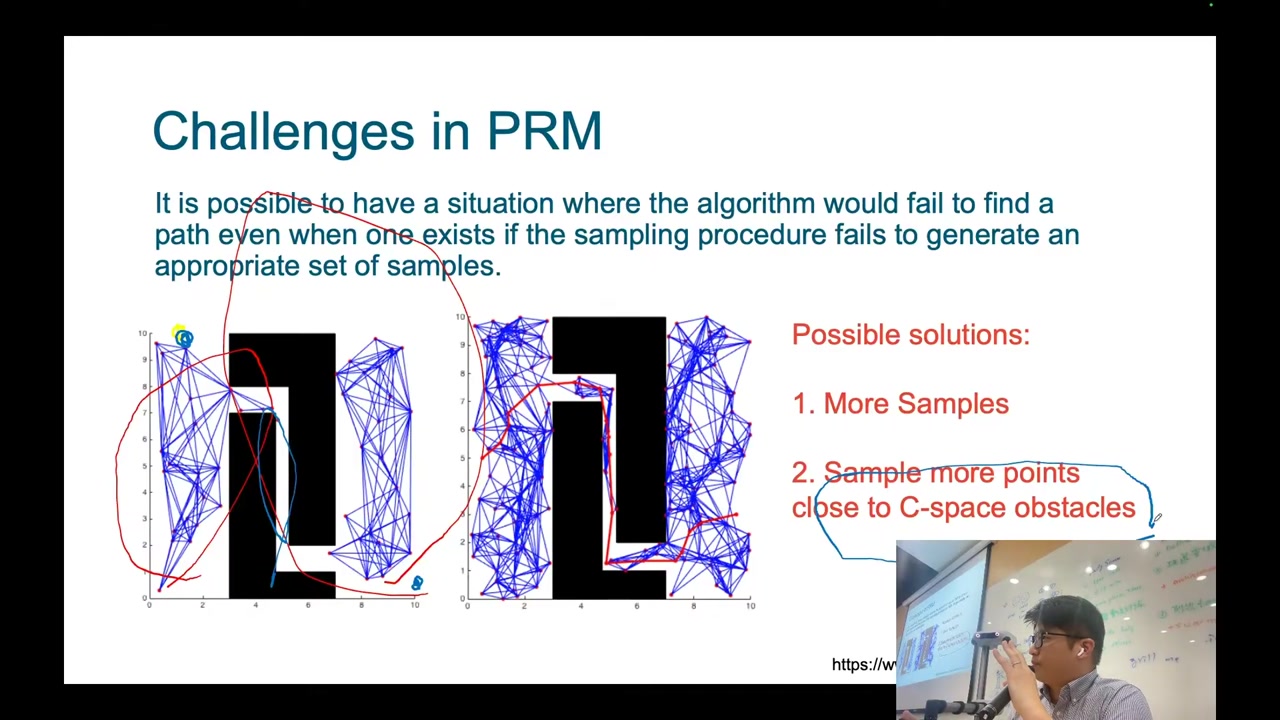
因為是隨機取樣,取到的點可能連不成一張能接通起點與終點的圖。投影片左右兩邊各自建好了圖,但中間有一條狹窄通道,附近沒有取到點,兩邊就接不起來。解法是取更多點,或者既然知道 C-space 障礙在哪,就刻意在障礙物附近多取樣,提高通道裡出現取樣點的機會。
機率完備性,與 RRT 預告
看老師講解(Part 2 · 30:55)
只要能一直增加樣本,PRM 終究能找到路;可是實際上有時間限制,不能無止境地取樣,所以在有限時間內無法保證找到解。這引出另一個演算法。
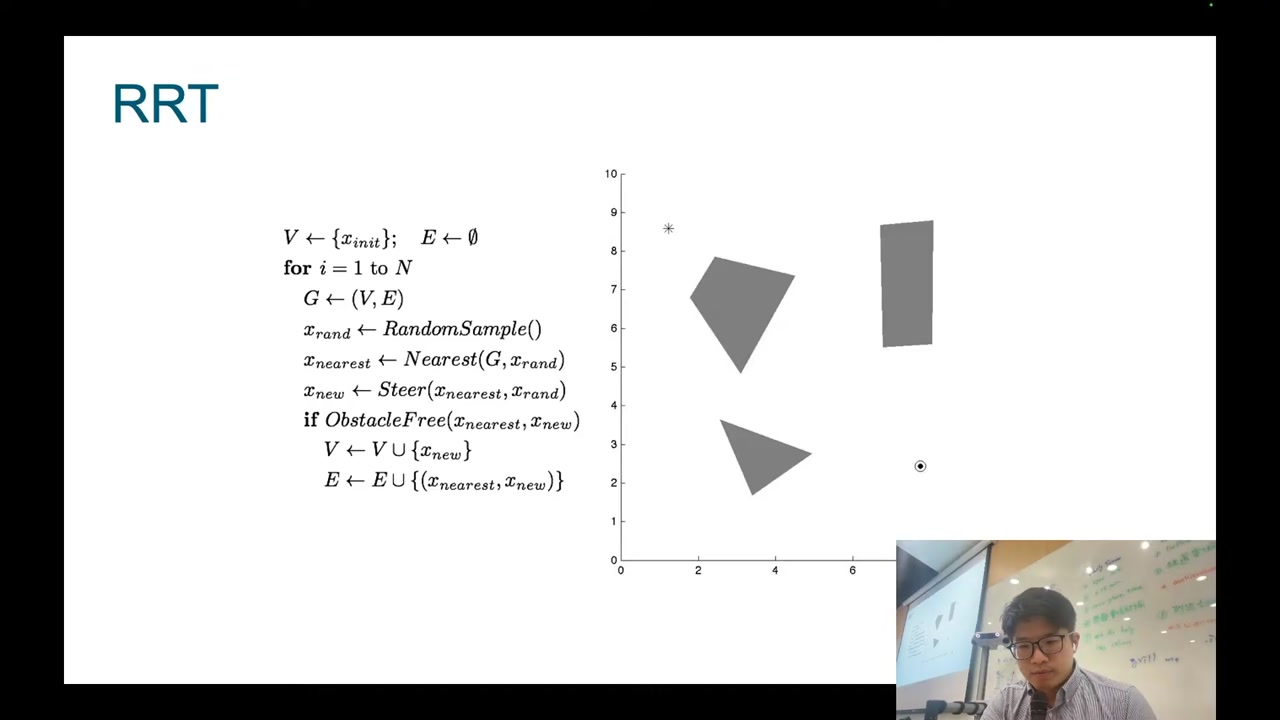
PRM 即使只用一部分組態,還是得先把圖建好;RRT 則是一邊長一邊找。講者因時間關係沒有展開,請有興趣的同學先看投影片上的動畫,下週再詳細說明。
幾何上無碰撞,為什麼仍可能不安全?
看老師講解(Part 2 · 33:25)
今天一路講的,都是怎麼把觀測轉成組態空間、找出無碰撞路徑。但即使考慮了機器人的身形與環境,機器人照著算出來的路徑走,也不一定到得了:前面假設的是一個完美的世界——確切知道障礙物在哪、自己在哪。
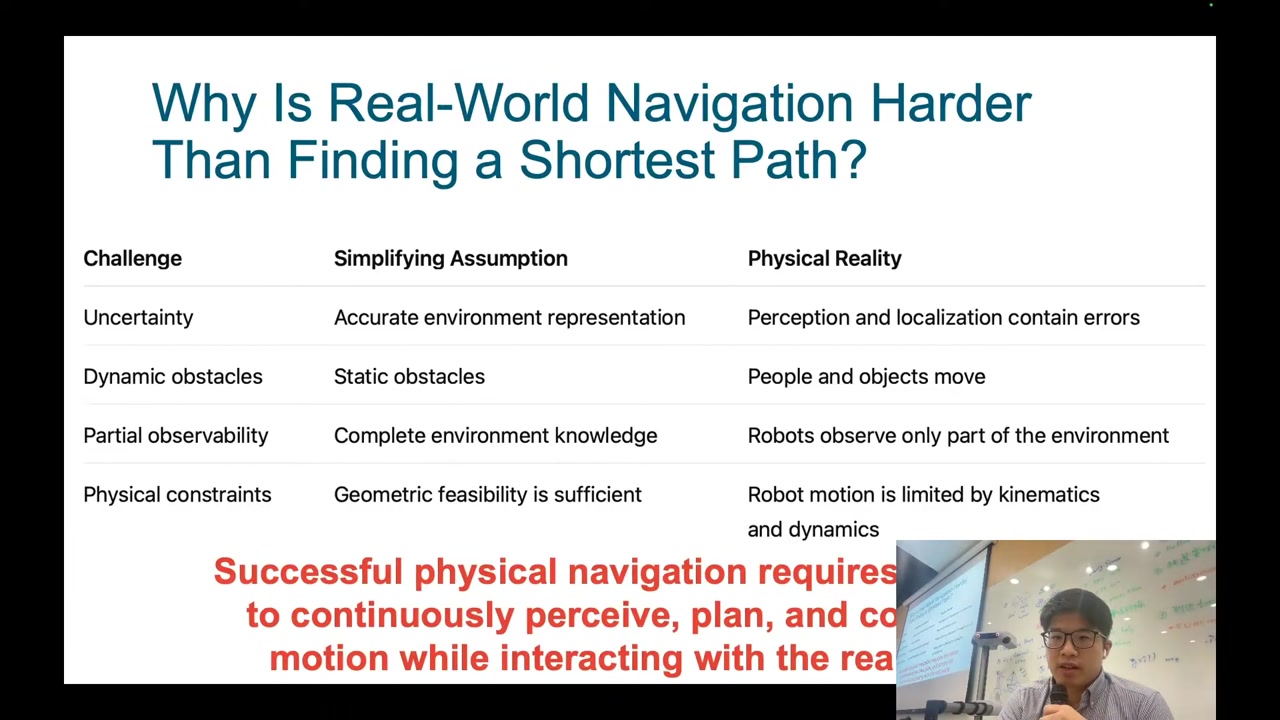
講者舉餐廳的送餐機器人為例:有人站到它面前,它會停下來;如果沒有偵測行人的機制、只是照著路徑往前走,就會撞上去。看不到的地方可能有危險,也不知道能不能進去;有些機器人本身就沒辦法往某些方向移動(Sid 的移動與控制方式算是比較靈活的)。所以就算是自由空間、就算規劃出無碰撞路徑,也不能照單全收。
本講總結與下一講
看老師講解(Part 2 · 37:00)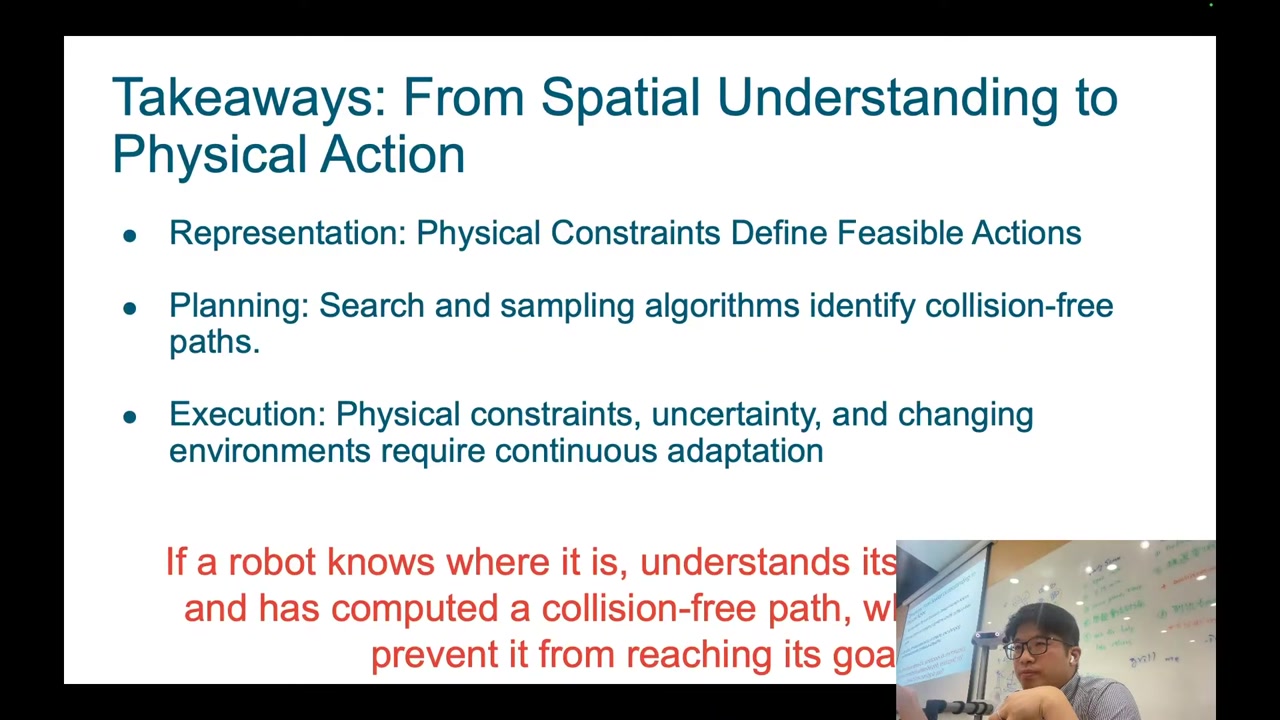
講者總結:這一講從空間理解走向物理行動,談了怎麼用組態空間表示環境,以及一個取樣式方法;搜尋式方法他沒有細講。執行面的物理限制、不確定性與變動環境,則需要持續調適。
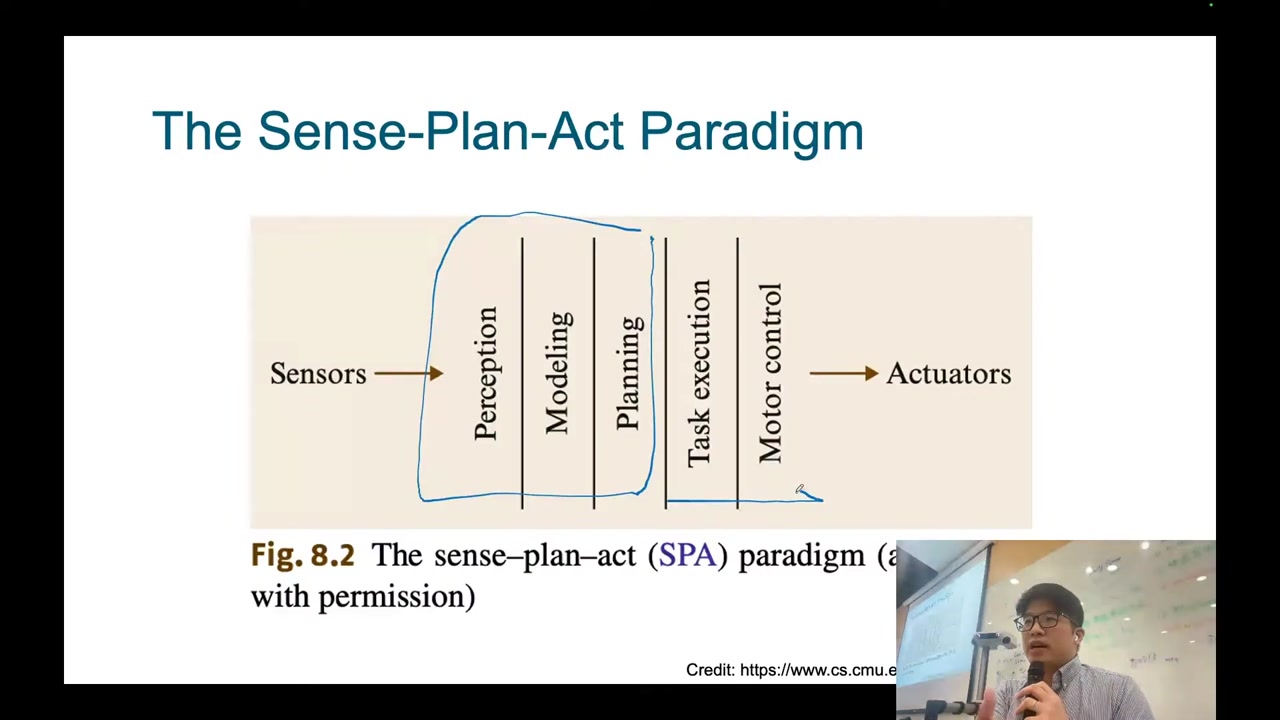
下一講會先把整套流程再複習一次、講完 RRT,接著進入任務執行與控制,並以智慧駕駛系統為例,說明實際的物理系統怎麼做控制與反應。講者也承認最後一小時講得比較趕。
複習與理解檢核
這一講橫跨「學深度」與「用深度規劃」。回答時請刻意指出:監督訊號從哪裡來、哪個假設讓它成立;以及規劃時,哪些物理限制被納入、哪些被暫時忽略。
一、學習式單目深度與監督來源
- 單目深度既然是 ill-posed 問題,學習式方法為什麼仍然有機會從單張影像預測深度?它利用了哪些多視角幾何難以利用的線索?
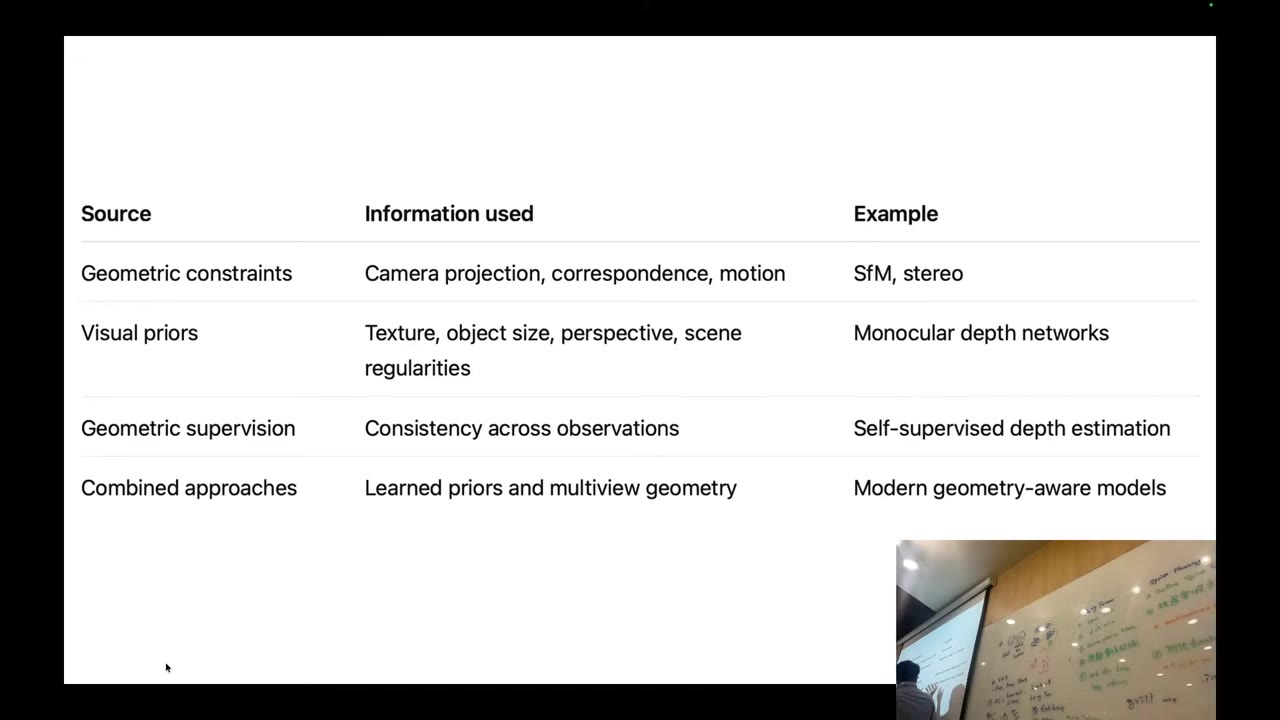
- 比較幾何約束、視覺先驗、幾何監督三類資訊來源:各自用的是什麼資訊?
- 以 RGB-D 感測器量測深度當監督,有哪些限制?為什麼遠處的深度特別難學好?
- 用模擬渲染的深度當監督,最大的優點與風險各是什麼?
- 人工標註為什麼通常只標相對深度?這樣訓練出的模型能直接用在機器人抓取嗎?
- Mannequin Challenge 影片為什麼能讓 SfM/MVS 產生可信的深度真值?若影片中的人在走動會怎樣?
- 從 SfM 點雲做出某一幀的深度影像,需要哪兩個步驟?得到的深度是公制的嗎?
- 為什麼學到的模型能補上 MVS 重建中的破洞?
作答檢核
- 它不是解出唯一幾何解,而是從大量資料學到「這種外觀通常對應這種深度」的先驗;紋理變化與梯度、遮擋、物體大小、透視與場景規律都是線索。
- 幾何約束用相機投影、對應與運動;視覺先驗用紋理、物體大小、透視等外觀規律;幾何監督用跨觀測的一致性來產生訓練訊號。
- 量測有雜訊、距離有限;視差的微小誤差在遠處會放大成很大的深度誤差,遠處真值本身就不可靠或缺值。
- 優點是深度完全已知、可大量產生並自由加入場景元素;風險是 sim-to-real 落差,模型在真實影像上可能失準。
- 人比較容易判斷誰近誰遠,難以標出精確距離;只學到順序,缺少公制尺度,無法決定手臂要伸多遠。
- 人都靜止,滿足 SfM/SLAM 的靜態世界假設,相機移動造成的視差全來自相機運動;人若走動,會產生錯誤對應,重建與真值都不可信。
- 把點雲轉到該幀的相機座標系,再用針孔相機模型投影並保留 Z 值;只能得到相對尺度,因為多張影像本身無法決定實際尺度。
- 網路以整張影像為輸入,從鄰近像素的模式推斷;資料集中其他影像在類似區域有真值,模型學到後能對單一場景缺值處做出預測。
二、view synthesis 作為監督
- view synthesis 的任務是什麼?為什麼影片「天生」就帶有這種監督?
- 深度網路與姿態網路的輸入、輸出各是什麼?為什麼只有深度網路不夠?
- 依序說明把第 t 幀的像素 pt warp 到相鄰影格的步驟,各需要哪些量。
- 光度一致性假設是什麼?它在哪些情況下會被破壞?
- 如果深度預測偏大一倍,訓練時的目標函式會發生什麼事?網路怎麼被修正?
- 講者說這篇論文「把幾何約束放進神經網路」。和直接回歸深度值相比,這種設計的意義是什麼?
作答檢核
- 給一個視角,合成另一個相機姿態下的影像;影片的下一幀就是現成的目標影像,不需人工標註。
- 深度網路吃目標幀、輸出逐像素深度 Dt;姿態網路吃目標幀與相鄰幀、輸出相對姿態。合成另一幀需要知道相機怎麼移動,所以兩者缺一不可。
- 用 K−1 與預測深度把 pt 反投影到 3D → 用預測的 Tt→s 轉到來源相機座標系 → 用 K 投影回 2D 得到 ps。
- 同一 3D 點在相鄰視角的像素值相近;遇到移動物體、遮擋、反光或光照改變時會失效。
- warp 後的位置會錯,pt 與 ps 的 RGB 差異大、損失上升;梯度同時調整深度與姿態估計,直到重建誤差變小。
- 監督不再來自深度真值,而是來自幾何上必須成立的關係;資料驅動提供先驗,幾何提供約束,讓沒有標註的影片也能訓練。
三、從深度評估到導航系統
- 模型 A 平均深度誤差 2 公分、模型 B 4 公分,但 B 的導航成功率較高。用像素數量解釋這個矛盾。
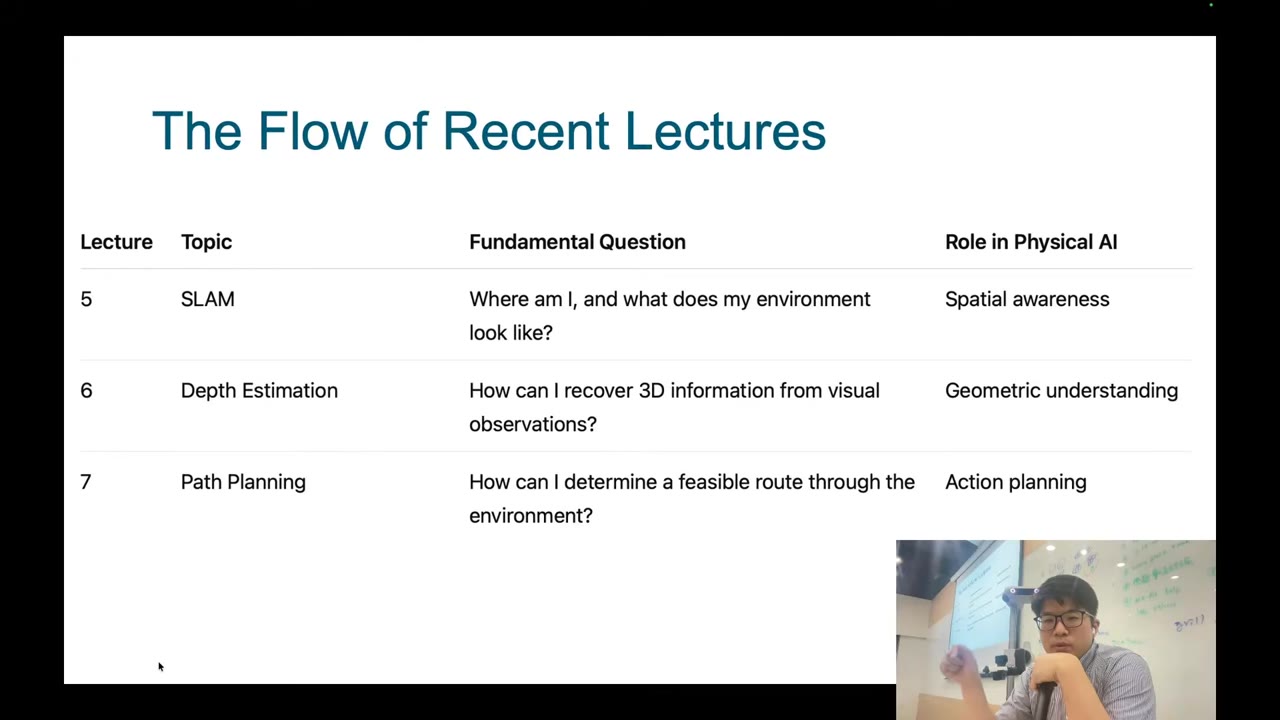
- 依第 5–7 講的脈絡,說明 SLAM、深度估計、路徑規劃分別回答什麼問題、扮演什麼角色。
- 描述導航系統的循環:定位、障礙物偵測、路徑規劃、執行之後為什麼要回到第一步?
- Sid 的頭部立體相機、手上的短基線立體相機與 LiDAR 各適合什麼任務?為什麼不全用同一種?
作答檢核
- 自由空間佔大量像素,A 在那裡準,平均誤差就低;障礙物邊緣像素少,B 在那裡準卻拉不動平均——而導航最依賴的正是障礙物附近的深度。
- SLAM:我在哪、環境長什麼樣(空間感知);深度估計:如何從視覺還原 3D(幾何理解);路徑規劃:如何決定可行路線(行動規劃)。
- 移動後觀測改變,位置、周遭障礙物都可能不同,必須重新定位、偵測並修正路徑,直到抵達目的地。
- 頭部相機基線較寬、看得較遠;手上相機基線短、只看近處要操作的物體;LiDAR 主動量距、涵蓋導航需要的較遠範圍。基線寬能估得更準但更難找對應點,各取所需。
四、路徑、軌跡、策略與規劃方法
- 路徑規劃與運動規劃的差別是什麼?哪一個考慮動力學?
- 為什麼路徑寫成 q(s) 而不是 q(t)?s 代表什麼?
- 用「穿過走廊」的例子,分別說明路徑、軌跡、策略要回答的問題。
- 行人突然走進已規劃的路徑時,是路徑、軌跡還是策略要負責反應?為什麼?
- 比較圖搜尋式與取樣式方法的基本想法,各舉一個代表演算法。
作答檢核
- 路徑規劃只找起點到終點的無碰撞點序列,通常忽略力、時間與控制限制;運動規劃要找滿足動力學與其他限制的運動。
- 路徑不管時間,只描述經過的點;s ∈ [0, 1] 是沿路徑的進度。
- 路徑:哪條路線不會撞;軌跡:10 秒內走完,每個時刻該在哪;策略:遇到行人等狀態時該採取什麼動作。
- 策略,因為它依當下狀態決定動作(例如減速);路徑與軌跡是事先規劃的,不會自己對新出現的狀況反應。
- 圖搜尋式在離散表示上搜尋(Dijkstra、A*);取樣式在組態空間中取樣探索、不做完整離散化(PRM、RRT、RRT*)。
五、組態空間
- 為什麼「自由空間」不一定可通行?用 60 公分走廊與兩台機器人說明。
- 定義組態、自由度與組態空間,並說明全向 2D 機器人的自由度為何是 2。
- 為什麼全向 2D 機器人的組態空間比工作空間小?
- C-obstacle 為什麼比障礙物本身大?多個障礙物時怎麼處理?
- 把「實體機器人+實體障礙物」轉成「點機器人+組態空間障礙」,對路徑規劃有什麼好處?
- 機器人能旋轉後,自由度與組態空間如何改變?為什麼不同角度的 C-obstacle 形狀不同?
作答檢核
- 寬 80 公分的機器人 B 無法通過 60 公分走廊,即使走廊中間全是自由空間;可行與否取決於機器人整個實體能否通過。
- 組態完整描述機器人每一點的位置;自由度是描述組態的最少實數個數;組態空間是所有組態構成的 n 維空間。全向機器人只能平移,(x, y) 就足以描述。
- 參考點靠近邊界時,機器人的身體會先撞到邊界,所以參考點能到的範圍要內縮一個機器人尺寸。
- 它是「參考點進入就會讓機器人身體撞上障礙物」的所有位置,等於把障礙物依機器人形狀擴張;多個障礙物取聯集。
- 機器人的形狀已併入障礙物,規劃只需讓一個點在自由空間中找連續路徑,問題大幅簡化,可以直接套用圖搜尋或取樣演算法。
- 自由度變成 3(x, y, θ),組態空間多一個角度維度;機器人朝向不同時,身形相對於障礙物的佔據範圍不同,不可進入的位置也不同。
六、佔用網格、組態空間與搜尋(第二段)
- 依序說明從 RGB 影像到可規劃路徑的六個步驟,並指出每一步新增了什麼資訊。
- 佔用網格和組態空間差在哪裡?為什麼不能直接在佔用網格上規劃?
- 40 × 40 公分的機器人放在 50 × 50 公分的網格上,為什麼障礙物外圍又多了一圈不能進入的格子?
- 網格解析度從 50 公分改成 10 公分,可行性與計算量各會怎麼變?什麼情況下改細網格也救不回來?
- 把路徑規劃寫成搜尋問題時,狀態、動作、成本與轉移模型各是什麼?
- 在教室 demo 中,BFS 與 A* 都找到路徑,為什麼 A* 展開的格子少得多?它多用了什麼資訊?
- 每個維度離散成 100 個值時,2D 移動機器人、7 自由度手臂、24 自由度靈巧手各有多少組態?這說明了網格法的什麼限制?
作答檢核
- RGB 影像 → 深度估計(每個像素多了距離)→ 點雲(有了 3D 位置)→ 佔用網格(鳥瞰下每格是否被佔用)→ 組態空間(再把機器人身形算進去)→ 路徑規劃(在自由組態中找路徑)。
- 佔用網格只描述環境哪裡有東西;組態空間還把機器人尺寸併入障礙物。只看佔用網格,路徑可能貼著障礙物走,機器人的身體會撞上。
- 機器人幾乎佔滿一格,參考點只要進到與被佔用格相鄰的格子,身體就會碰到障礙物,所以要依機器人尺寸把障礙物向外擴張。
- 變細後原本被整格封死的縫隙可能變得可通行,但格子數約增加 25 倍、搜尋變慢;若通道實際寬度本來就小於機器人,網格再細也不會出現可行路徑。
- 狀態是組態(含初始狀態與目標檢定);動作是走到相鄰節點(東南西北);每步成本例如 1、路徑成本是加總;轉移模型 St+1 = T(St, At)。
- BFS 不看目標、向四周均勻展開;A* 用啟發函式估計離目標還有多遠,優先展開看起來更接近目標的格子。
- 1002、1007、10024;組態數隨自由度指數成長,高自由度時無法一一檢查,必須改成只探索一部分組態。
七、取樣式規劃與真實世界的落差(第二段)
- PRM 的兩個階段各做什麼?路線圖 G = (N, E) 的節點與邊各代表什麼?
- 新取樣點要怎麼決定連到哪些節點?為什麼角度的距離要寫成 min(|θ1 − θ2|, 360 − |θ1 − θ2|)?
- 在 2D 中怎麼檢查兩節點之間的直線是否無碰撞?這種檢查可能漏掉什麼?
- 環境中有一條狹窄通道,PRM 一直找不到路。說明原因並提出兩種改善方法。
- 「機率完備」保證了什麼、沒保證什麼?對有時間限制的機器人有什麼影響?
- 比較 PRM 與 RRT 擴展搜尋結構的方式。
- 餐廳送餐機器人照著一條無碰撞路徑前進,舉出四種可能讓它失敗的真實情況,並各對應到一個被簡化的假設。
- 本講只走到 sense–plan–act 的哪一段?下一講要補上什麼?
作答檢核
- 前處理階段在自由空間取樣並連線建出路線圖;查詢階段把起點與終點接進圖中再做圖搜尋。節點是取樣到且無碰撞的組態,邊是節點之間可行的直線路徑。
- 用距離函式找鄰近範圍 R 內(或 K 個最近)的節點,連線無碰撞才加邊;角度會繞一圈,350° 與 10° 只差 20°,不能直接相減。
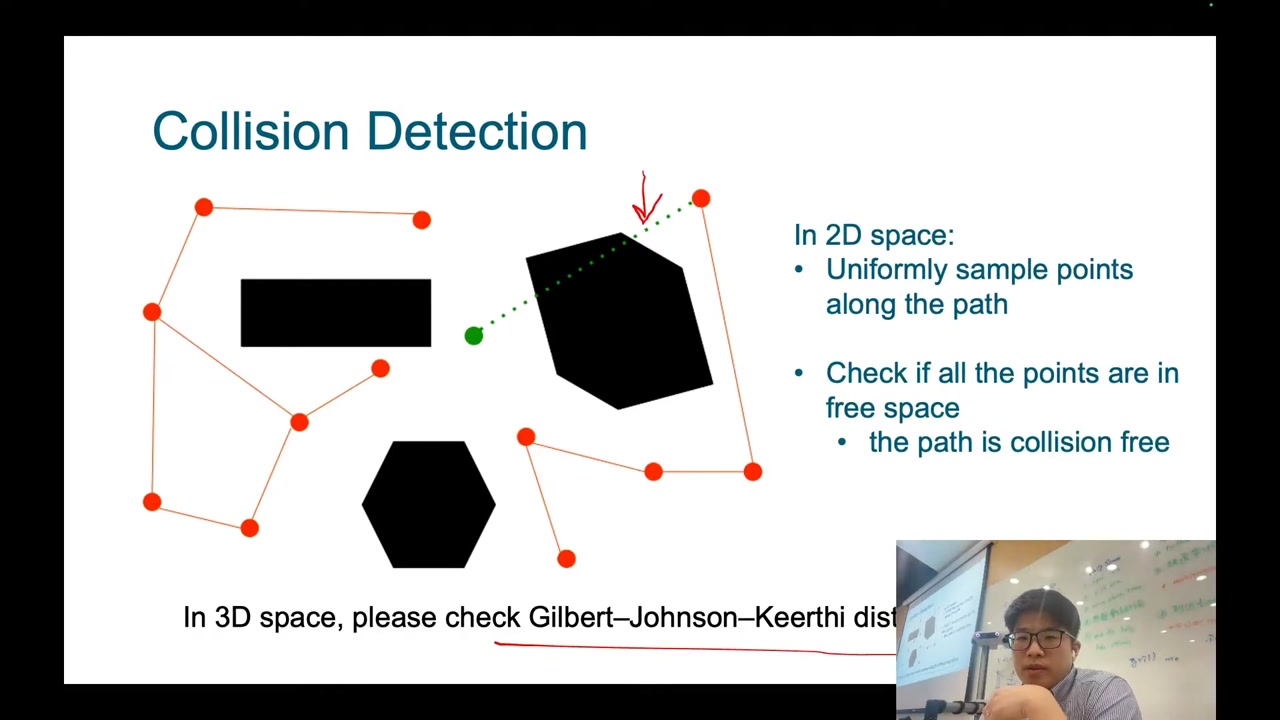
- 沿連線均勻取樣許多點,全部在自由空間內才算無碰撞;取樣太稀可能跳過很薄的障礙物,3D 時需要更嚴謹的方法(例如 GJK)。
- 通道很窄,隨機取樣很少落在裡面,兩側的圖接不起來;可以增加樣本數,或在 C-space 障礙附近刻意多取樣。
- 只要路徑存在,樣本數越多找到解的機率越接近 1;但不保證在固定時間或固定樣本數內找到,時間有限時可能回報找不到。
- PRM 先建一張涵蓋自由空間的一般圖,再查詢;RRT 從起點迭代地長出一棵搜尋樹,朝目標探索,不需先建完整張圖。
- 定位或感知誤差(假設環境表示精確);有人走到前面(假設障礙物靜止);看不到轉角後的狀況(假設完全知道環境);底盤無法照路徑轉彎或急停(假設幾何上可行就夠)。
- 講到感知與規劃;下一講講完 RRT,再談任務執行與馬達控制,並以智慧駕駛系統為例。
八、最終口述挑戰
- 用三分鐘回答:「要讓 Sid 從櫃子拿麥克風送到後排同學手上,從感測到規劃需要哪些步驟?」必須談到深度從哪裡來、深度該怎麼評估,以及為什麼要在組態空間而不是工作空間中規劃。
- 用三分鐘向沒上過課的同學解釋:「為什麼 Sid 在教室裡可以用網格加 A* 規劃,機械手臂卻需要 PRM 或 RRT?算出無碰撞路徑後,Sid 還可能在哪裡失敗?」
通過標準
第一題:能說明 Sid 用立體相機與 LiDAR 取得公制深度、必要時以學習式先驗補足;以 SLAM 定位並建圖、偵測障礙物;評估深度時看障礙物附近與導航結果而非平均誤差;再把機器人身形併入障礙物、在組態空間找無碰撞路徑,並指出路徑之後還需要軌跡與能對行人反應的策略。第二題:能說出 Sid 在地面上只有少數自由度,佔用網格加上機器人尺寸就是組態空間,網格夠細時可用 A* 搜尋;手臂有 7 個以上自由度,網格組態數指數爆炸,只能取樣部分組態;說明 PRM 的建圖/查詢與狹窄通道問題、機率完備的意義;最後舉出感知與定位誤差、走動的人、看不到的區域與底盤物理限制等失敗原因,並指出需要持續感知、規劃與控制。
內容整理自本專案 Lecture 7 - Part 1、Part 2 影片及 YouTube 自動英文字幕;投影片截圖取自同兩支課程影片(Part 1 中段約 50 分鐘直播只拍到講者鏡頭,該段未附投影片)。繁中字幕已依台灣用語翻譯並通過格式驗證,專有名詞與數學符號依投影片與上下文校正,正式公開前仍建議人工複核問答與收音不清的片段。本講兩段錄影皆由每週排程自動整理上線。