快速掌握
本講核心:上一講假設每個像素的深度都已知,這一講把這個假設拿掉——只有 2D 影像時,要怎麼推回 3D?單張影像先天就有模糊性:同一條射線上的點都投影到同一個像素。解法是加入更多資訊:多張影像(structure from motion)能還原結構,卻不知道實際尺度;立體相機用已知的基線把尺度補回來,深度 Z = bf/d,前提是找到正確的對應點,而且誤差會隨距離平方放大。講者最後強調,深度估計不能只看平均誤差,要看它能不能支撐機器人的物理行動。
- 前 40 分鐘補完第 5 講:已知對應關係時,點雲配準有直接的最佳解;不知道時用 ICP,以「最近點」當對應點反覆修正。
- 單目深度估計是 ill-posed 問題:從 3D 投影到 2D 時丟掉了深度,只看一張影像分不出遠近。
- SfM:特徵偵測與匹配 → 用極線幾何估計相機姿態 → 三角測量 → bundle adjustment;結構還原得出來,但只到一個未知的全域尺度。
- 立體相機:兩台平行相機、已知基線 b,由相似三角形得到 Z = bf/d;電腦視覺最重要的三個問題是「對應、對應、對應」。
- 深度誤差 |ΔZ| ≈ Z²|Δd|/(fB);平均誤差較低的模型,不一定是導航時撞得比較少的那個。
補完上一講:從觀測到持久地圖
看老師講解(5:50)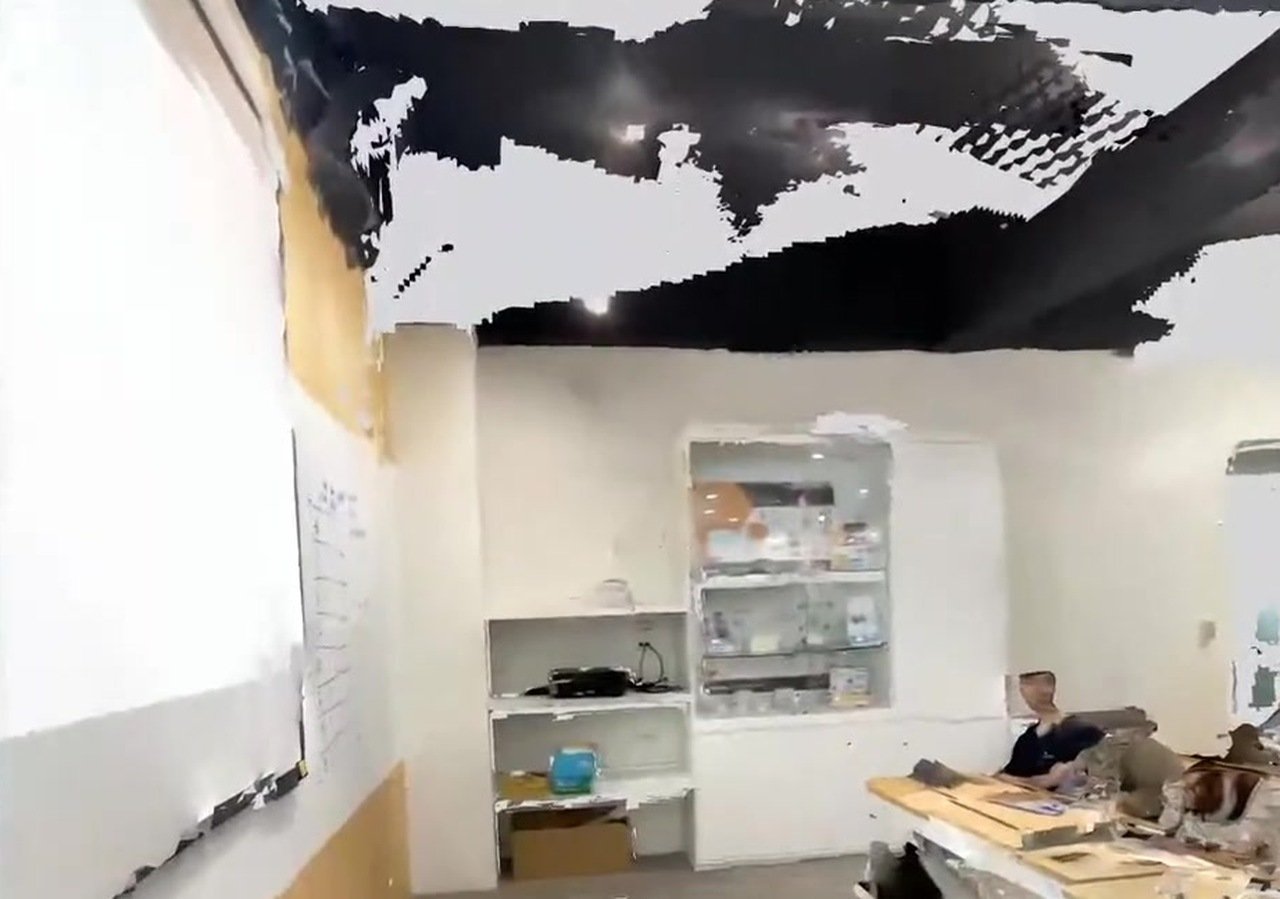
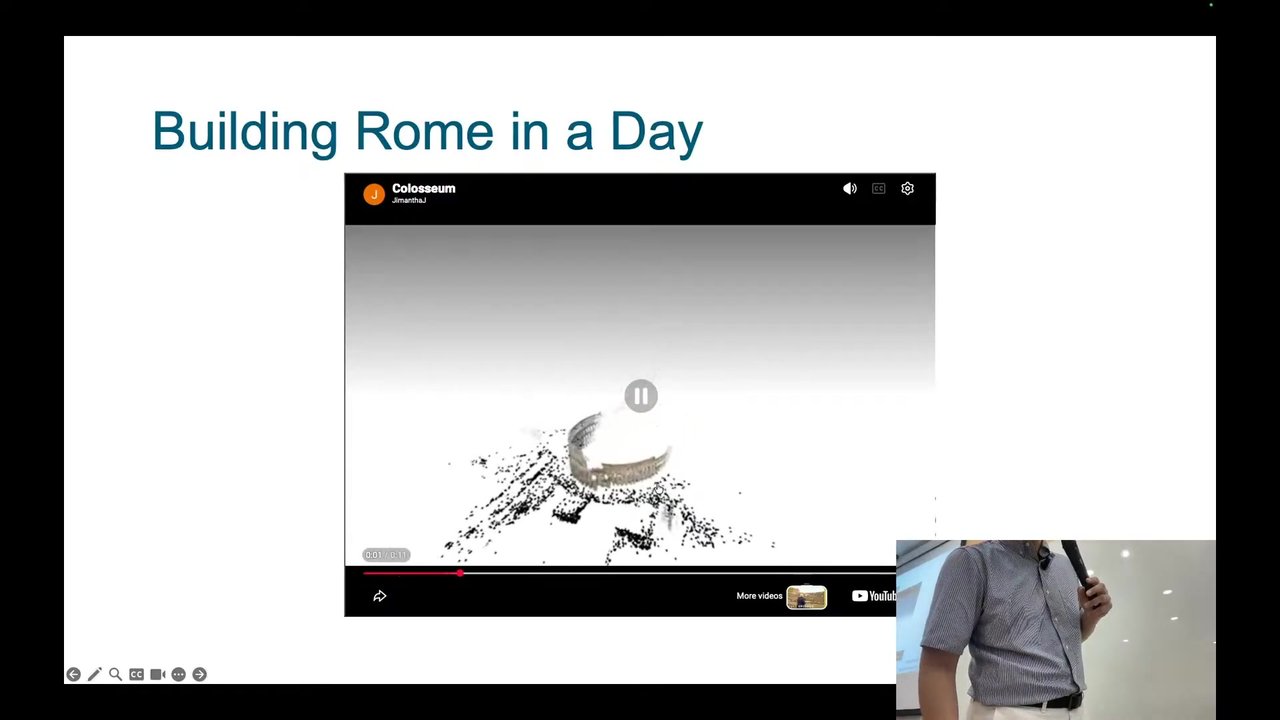
講者先回顧上週的三件事:表示運動、還原幾何、建立持久地圖,核心問題是怎麼把感測器觀測變成有空間依據的軌跡與物理世界的持久表示。入口是 UMI 手持夾爪:人拿著裝有腕部相機與 IMU 的裝置示範,從感測器資料擷取軌跡,累積成資料集,以行為複製訓練模型,再部署到機器人上。上週談的是中間「從感測器到軌跡」這一段,也就是 SLAM。上週用 iPad 現場重建教室的錄影也放上課程平台了;可以看到重建並不完美,有些區域因為缺少觀測而補不起來,原因稍後會談到。
他接著把流程再走一遍:相機每拍一張就放一個 3D 座標系,相鄰兩幀之間的運動用轉換矩陣(旋轉加平移)描述,C3TC1 = C3TC2 C2TC1 把多段串起來。同一個 3D 點在不同相機座標系裡有不同座標,轉到同一個座標系才會一致。完整的重建流程是:深度影像經針孔相機模型反投影成 3D 表面,找對應關係、估計相機姿態,再把各幀的點轉到共同座標系,合併成持久地圖。上週漏講的,正是中間「怎麼估計兩幀之間的轉換」。
已知對應關係:點雲配準有直接解
看老師講解(16:10)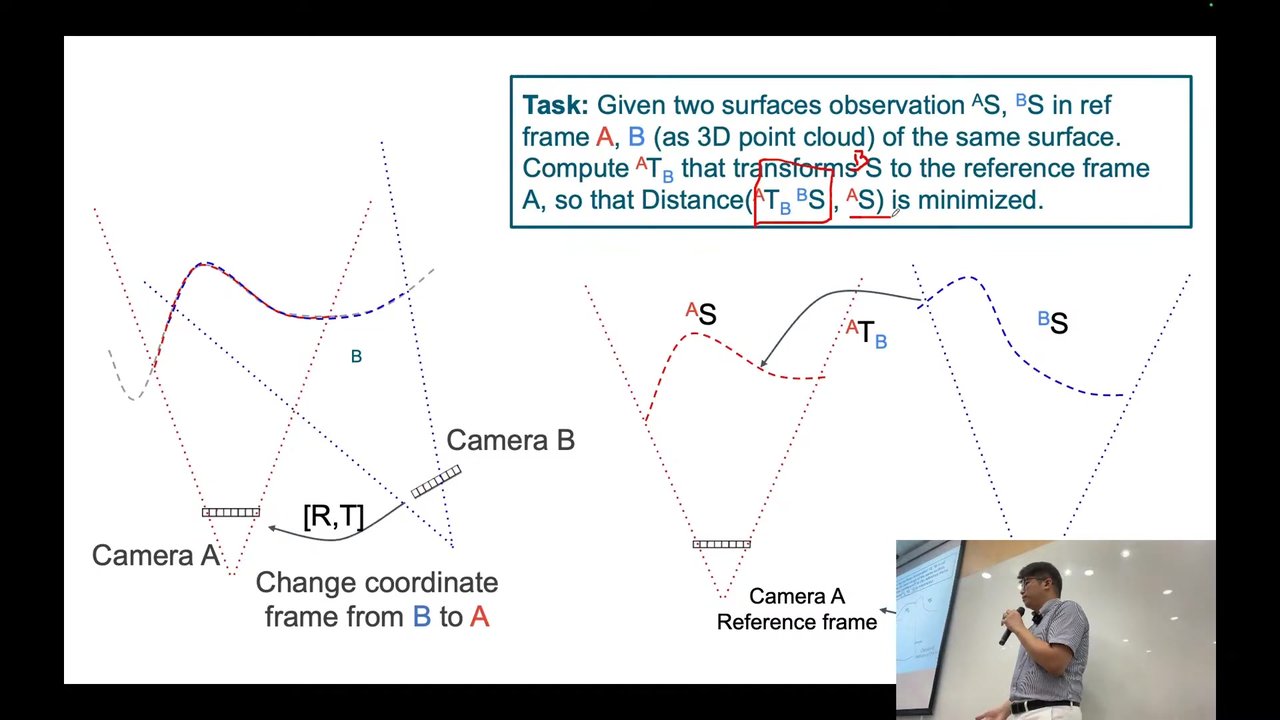
相機 A 看到表面的一部分,相機 B 往右移一點、轉個角度,看到另一部分。兩組點有一段是同一塊表面,只是位在不同座標系,所以座標不同。要找的是兩個相機座標系之間的旋轉與平移:用這個轉換把 B 的點搬到 A 的座標系,重疊的點應該疊在一起,所以要最小化兩者的距離。
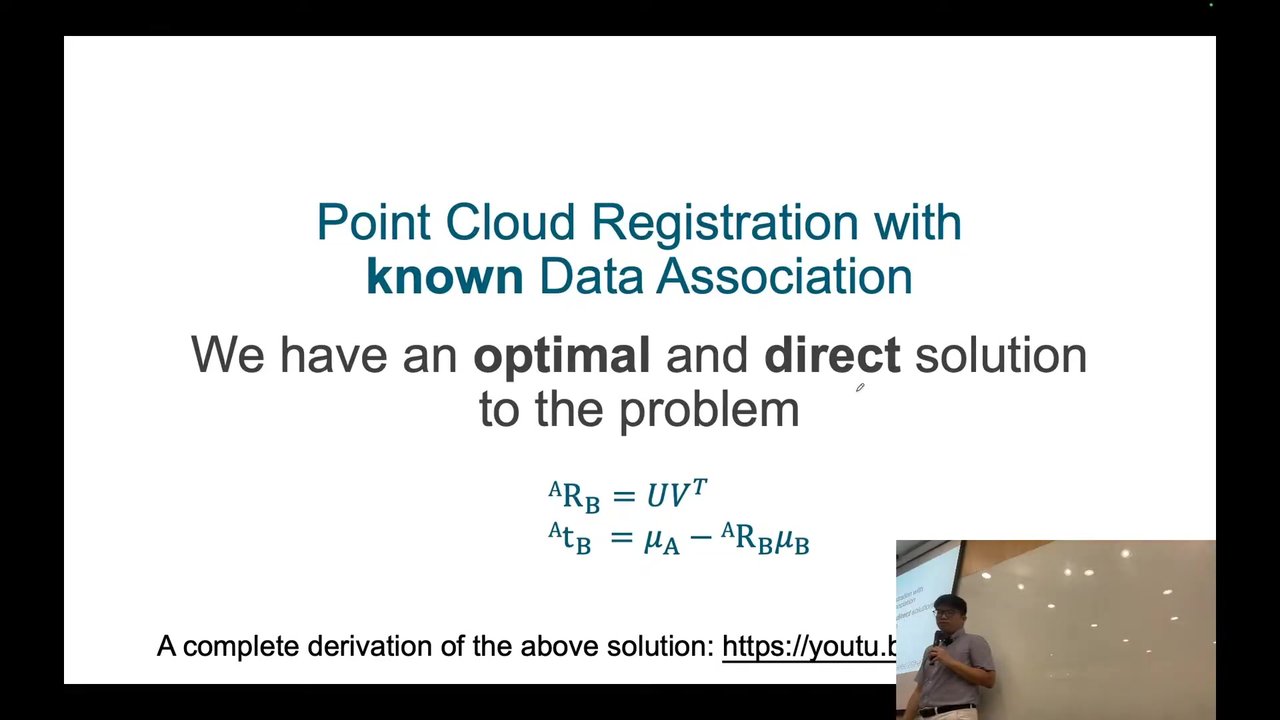
如果已知資料關聯(data association)——也就是知道哪一個點對應到哪一個點,它們在 3D 中是同一點、只是座標系不同——就把所有對應點的距離加總,找出讓總和最小的轉換矩陣。轉換估得完全正確時總和是 0,實際上做不到,所以是取最小值。
不知道對應關係:ICP 迭代最近點
看老師講解(22:34)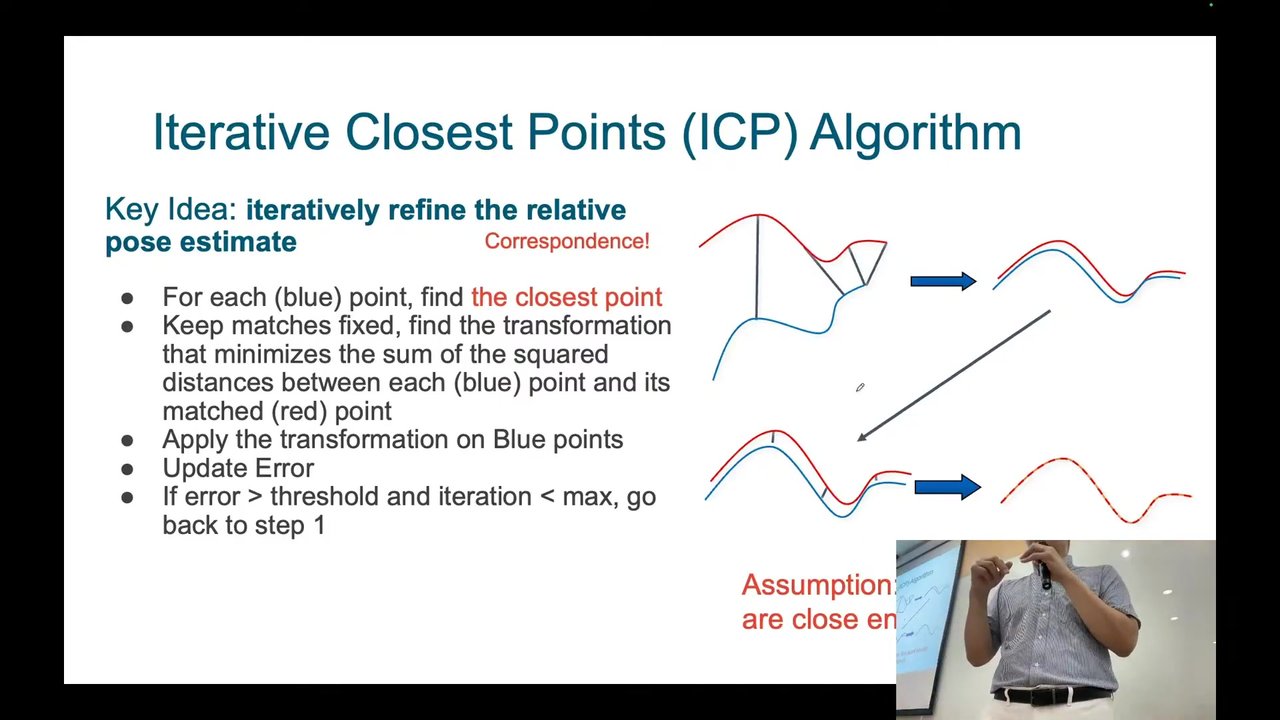
現實中拿不到對應關係,就不能直接套用上面的解。ICP(iterative closest point)的想法是:既然沒辦法一步得到最佳解,就迭代逼近。它做了一個假設——如果是同一個點,兩者應該離得很近,所以把最近點當成對應點。有了對應點,就能用前面的直接解算出旋轉與平移,把藍色點轉過去。但「最近」不等於「對應」,第一次轉完通常還不夠貼近,於是計算兩組點之間的距離總和當作誤差:小於預先定好的門檻就停,否則回到第一步重新找最近點,直到誤差夠小,或迭代次數多到太花時間為止。
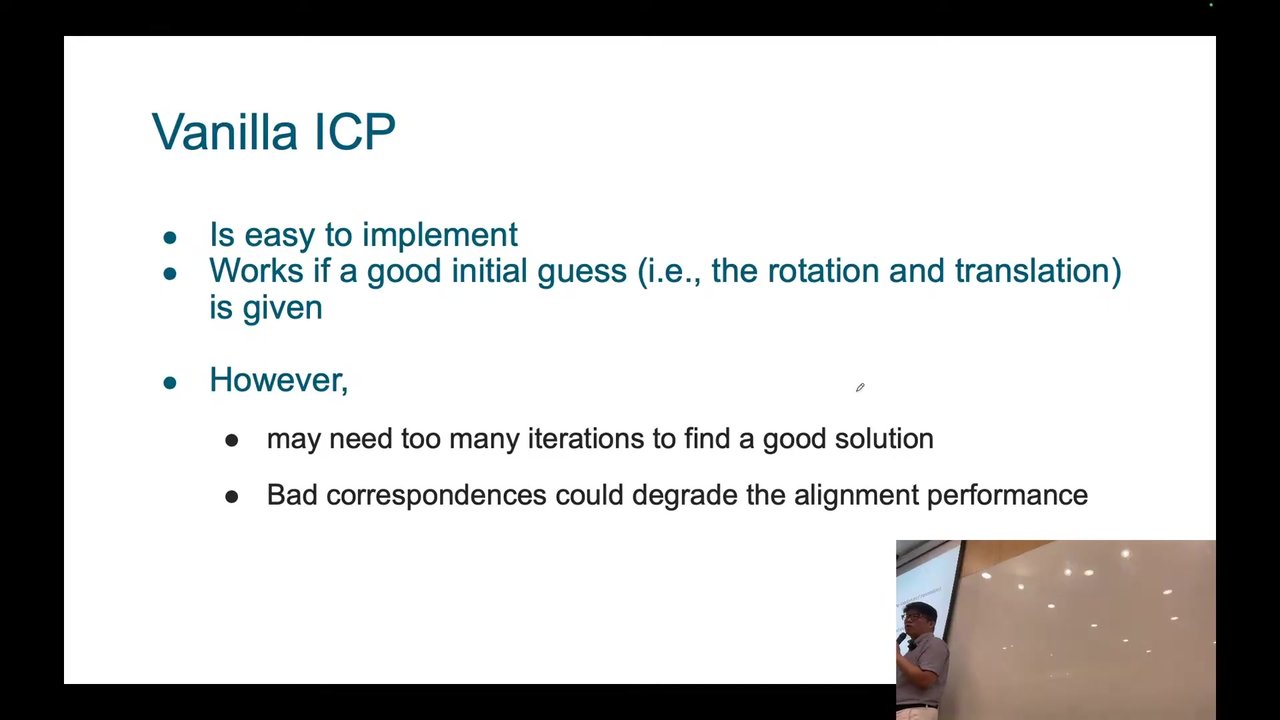
講者特別點出這個演算法有很多沒定義清楚的地方:「最近點」要取幾個?門檻值怎麼定?迭代幾次?「兩組點雲夠接近」又是多近?這些都是實作時一定會遇到的超參數問題。作業一會讓大家自己定義、嘗試不同設定,觀察它們如何影響重建結果並分析原因。
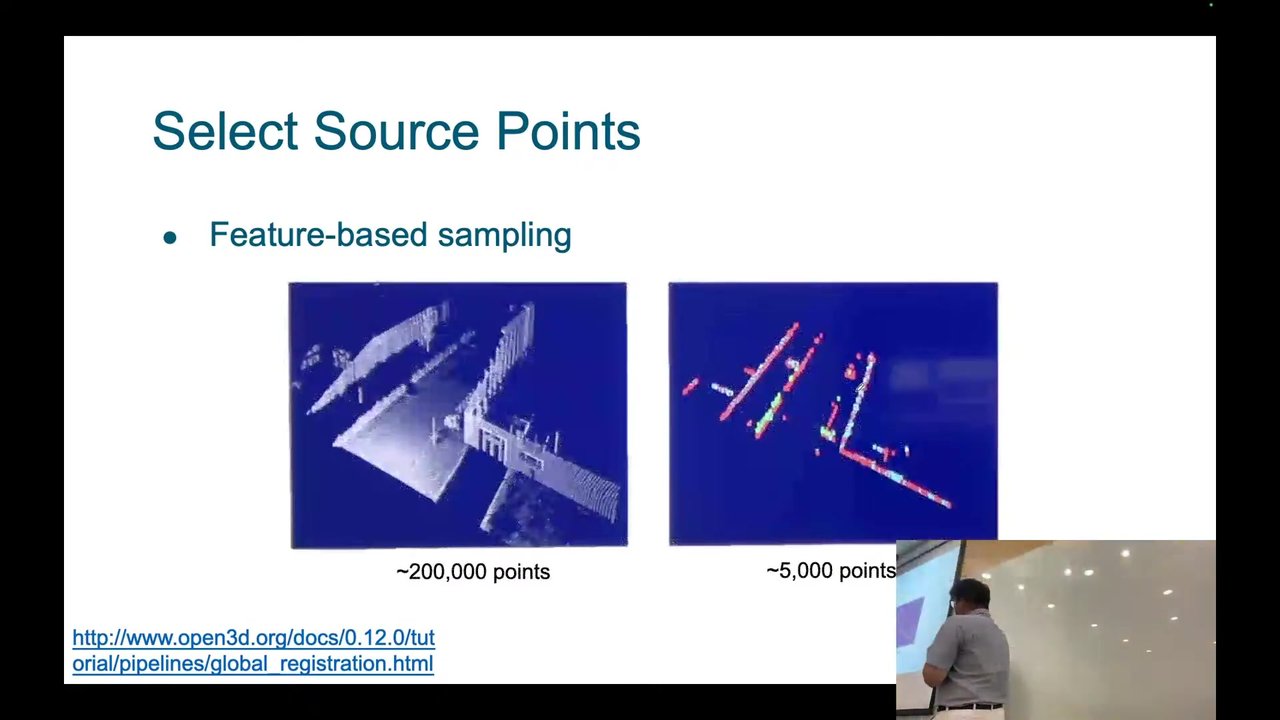
另一個改進方向是不要用全部的點。直接拿原始點雲算最近點,等於 20 萬個點對 20 萬個點,計算量很大;而且很多點長得都一樣。講者舉教室的白板為例:從兩個角度拍同一塊白板,很難知道某一點在另一張影像的哪裡,邊緣卻提供了清楚的參考。挑出有辨識度的點,除了把計算量從 20 萬個點降到 5,000 個,更重要的是讓對應點找得更準。
講者也說明作業一本週釋出。這學期的作業重新設計過,會明確定義上面這些模糊的地方;重建難免會失敗,作業也會提供辨識失敗情況、移除有問題資料的機制。作業二、作業三與期末專題也會比照辦理。
兩個現實問題:漂移與會動的世界
看老師講解(40:06)理想情況下重建完美、轉換也估得準,現實中至少有兩個問題。第一是上一講提過的漂移:1 到 2、2 到 3 的轉換各帶一點小誤差,連乘起來就累積成大誤差。完整的 SLAM 不能只做兩兩配準,還要做迴路閉合——回到同一個地方時認出這是同一點,再用這個資訊重新校正整個重建。
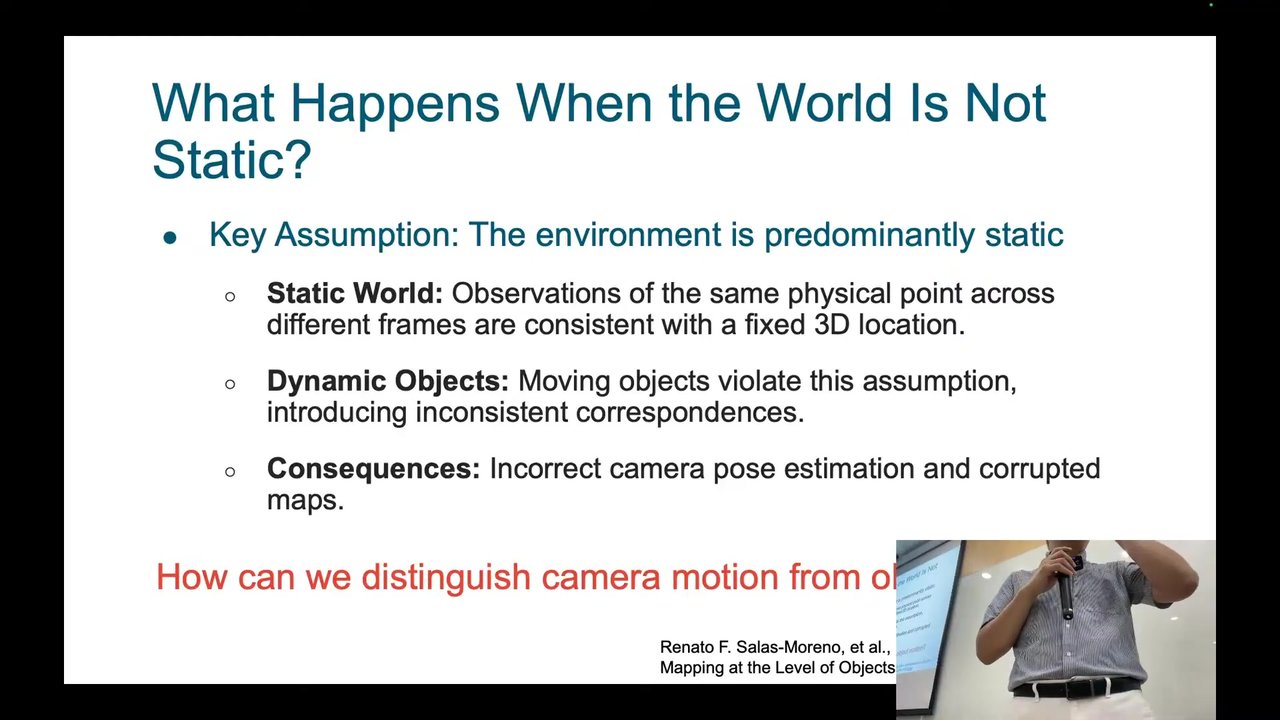
第二是靜態世界假設。估計兩組點之間的轉換時,預設世界不動、只有相機在動,才找得到一致的對應點。上週示範時,有些同學的臉或物品沒重建好,原因之一就是人在動。動態物體會產生不一致的對應關係,破壞前面的最佳化,導致相機姿態估錯、地圖毀損。相機與物體同時在動時,問題更難,這超出本講範圍,有興趣可以看在物體層級做 SLAM 的這篇論文。
進入深度估計:從視覺觀測推出 3D
看老師講解(43:13)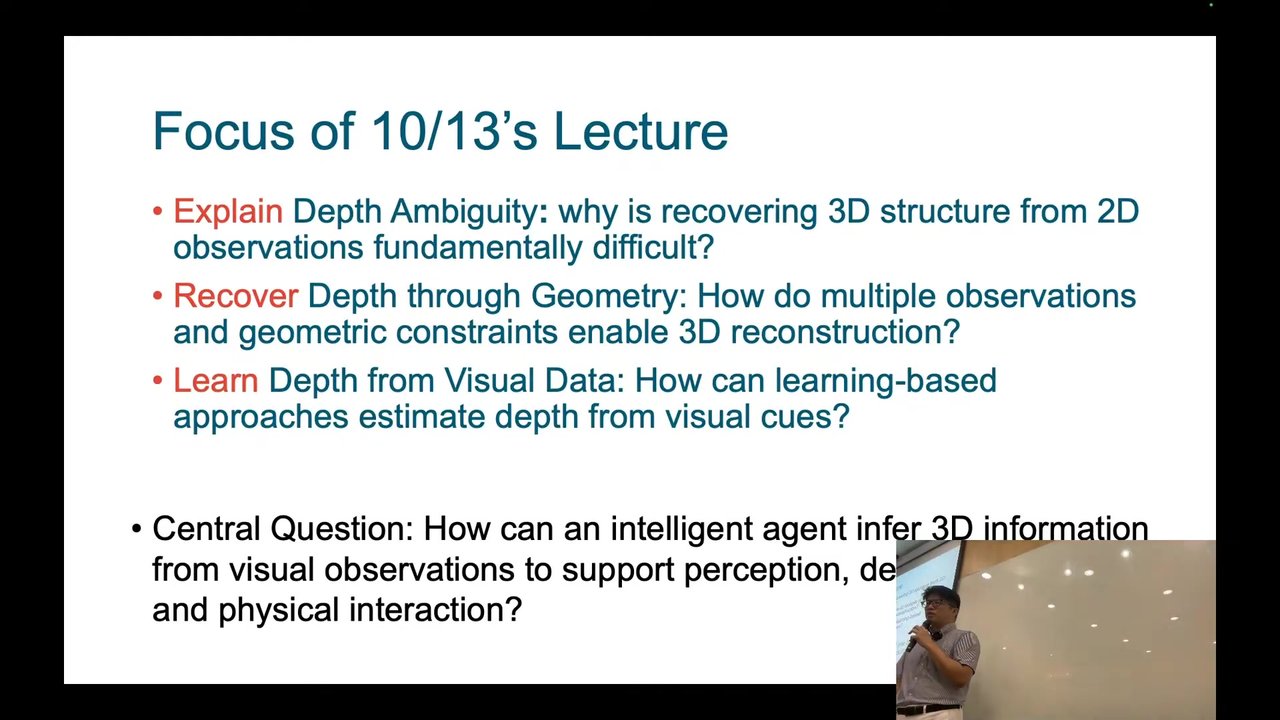
補完第 5 講後,正式進入本講主題:深度估計。講者強調核心問題的後半句:談深度估計時,很容易以為目標就是把深度估準;但 agent 用視覺觀測理解世界,最終是為了與物理世界互動。這一講要一直把深度估計連回感知、決策與物理互動。
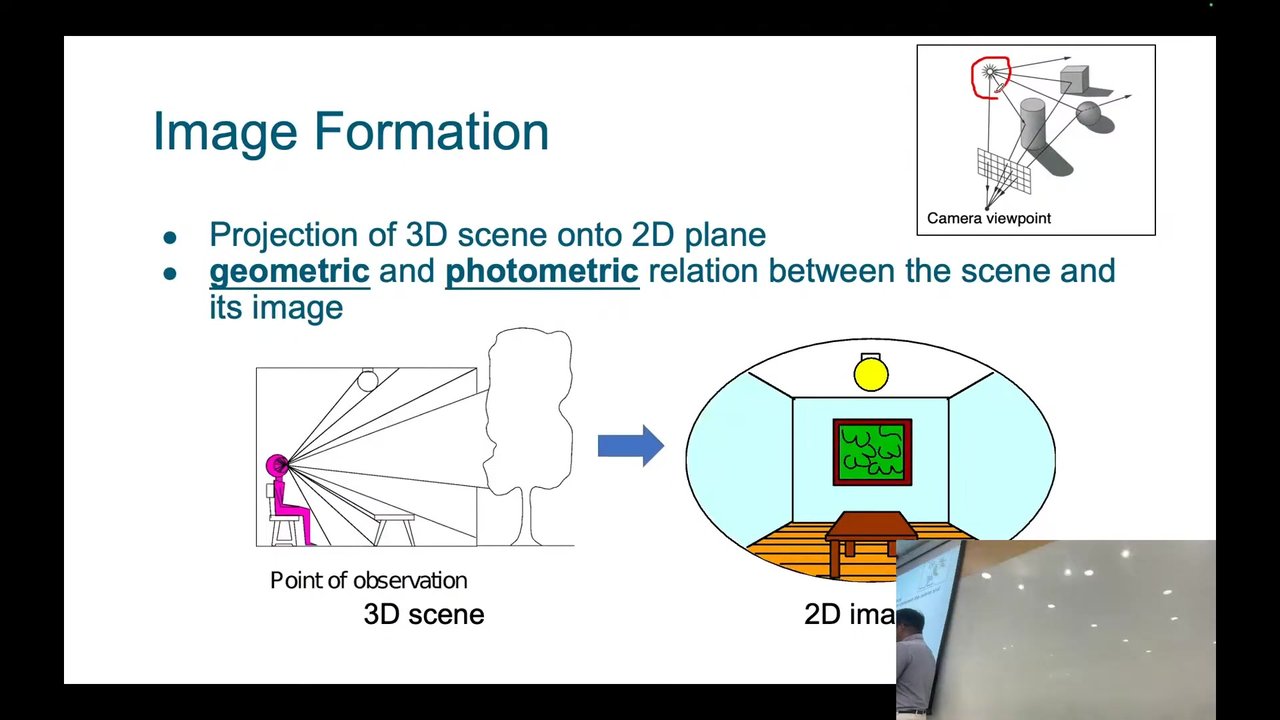
成像(image formation)本身就是一門課的份量,講者只點出兩面。幾何的部分上週用針孔相機模型談過;光度的部分是:光從光源射出,可能在不同表面反射、甚至反射好幾次,最後才進入鏡頭打到成像平面,我們看到的是各種光線混合的結果。這和主動式感測器(自己打光、接收回波)很不一樣,相機是被動接收自然光。
針孔成像的概念可以追溯到西元前 500 年,由中國與希臘的先驅發現:暗室牆上開個小洞,外面的景物就會倒著映在白牆上,這就是暗箱。投影方式分兩種:正交投影把物體直接映到成像平面,大小不變,常見於焦距很長的鏡頭;一般相機是透視投影,遠的物體變小、近的變大。透視投影的代價是丟掉 3D 資訊——只有像素位置、沒有 Z,就無法反投影回 XYZ。
為什麼單張影像推不出深度
看老師講解(50:22)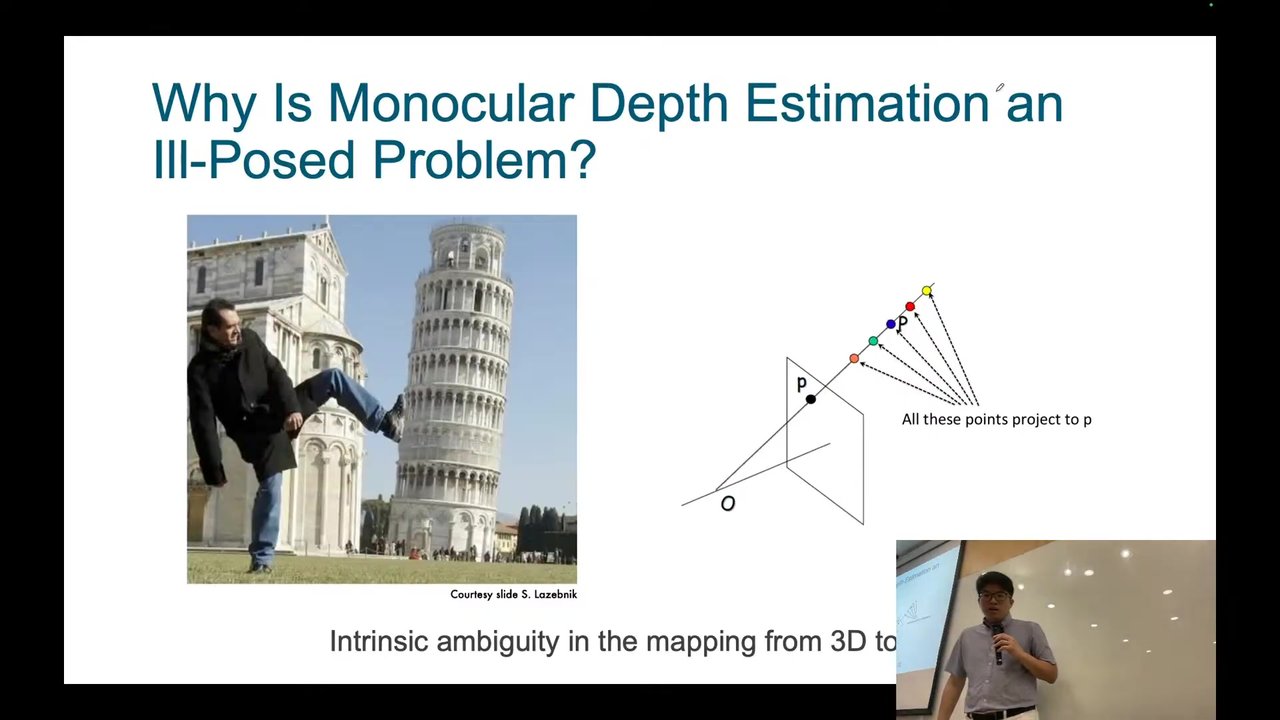
大家都拍過這種錯位照:人離相機可能只有 2 公尺,塔可能在 20 公尺外,影像上卻像緊挨在一起。如果只有這張影像,要推出背後的深度非常困難。原因上週就說過:從相機原點畫一條射線,射線上每個點都會落在同一個像素上,只要點在那條射線上,就分不出遠近。這就是單目深度估計被稱為 ill-posed(不適定)問題的原因。
Structure from Motion:從多張影像還原結構
看老師講解(1:05:59)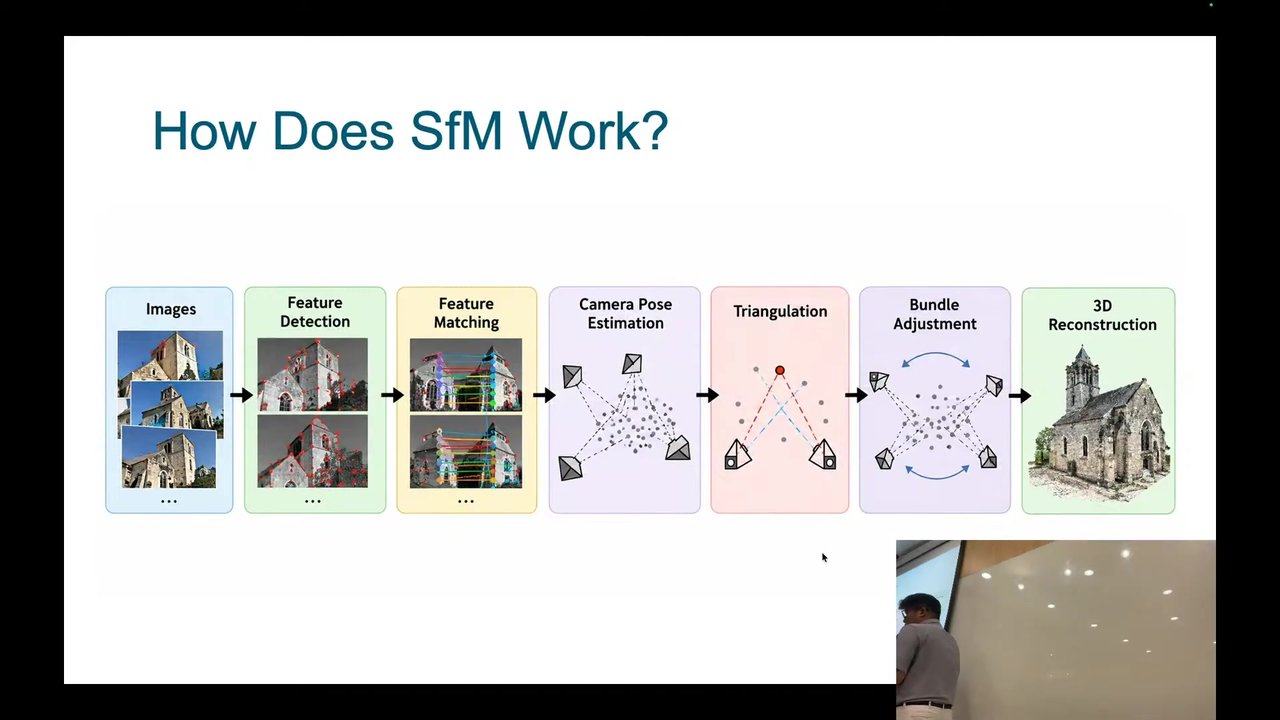
第一個方向是用多張影像。structure from motion(SfM)能從兩張以上的影像自動還原相機運動與場景結構。講者只講每一步的高階概念,細節留給電腦視覺課;他說這些概念之後會以不同形式出現在第二、第三種方法裡,所以值得先建立起來。
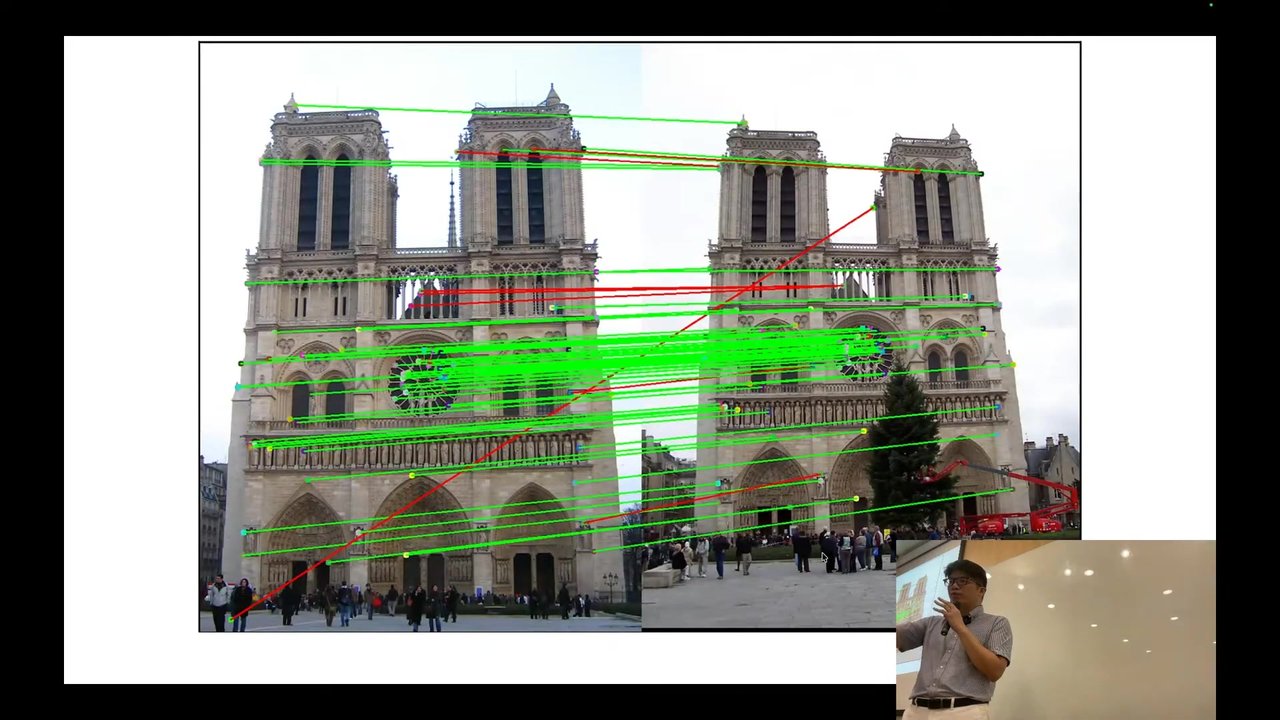
第一步是特徵偵測與匹配。經典演算法是 David Lowe 在 1999 年提出的 SIFT(尺度不變特徵轉換),它找出的特徵點對影像縮放、平移、旋轉不變,對光照與視角變化也有部分不變性。人一眼就知道兩張照片裡是同一個點,但電腦得處理一張近、一張遠的尺度差異,角度也略有不同;如果一張在陰影下、一張被陽光直射,匹配又更難。
要注意的是,這裡找到的是 2D 的對應點,和 ICP 在 3D 找對應點不同。只知道 2D 對應,還不知道 3D 結構,需要再多一步。
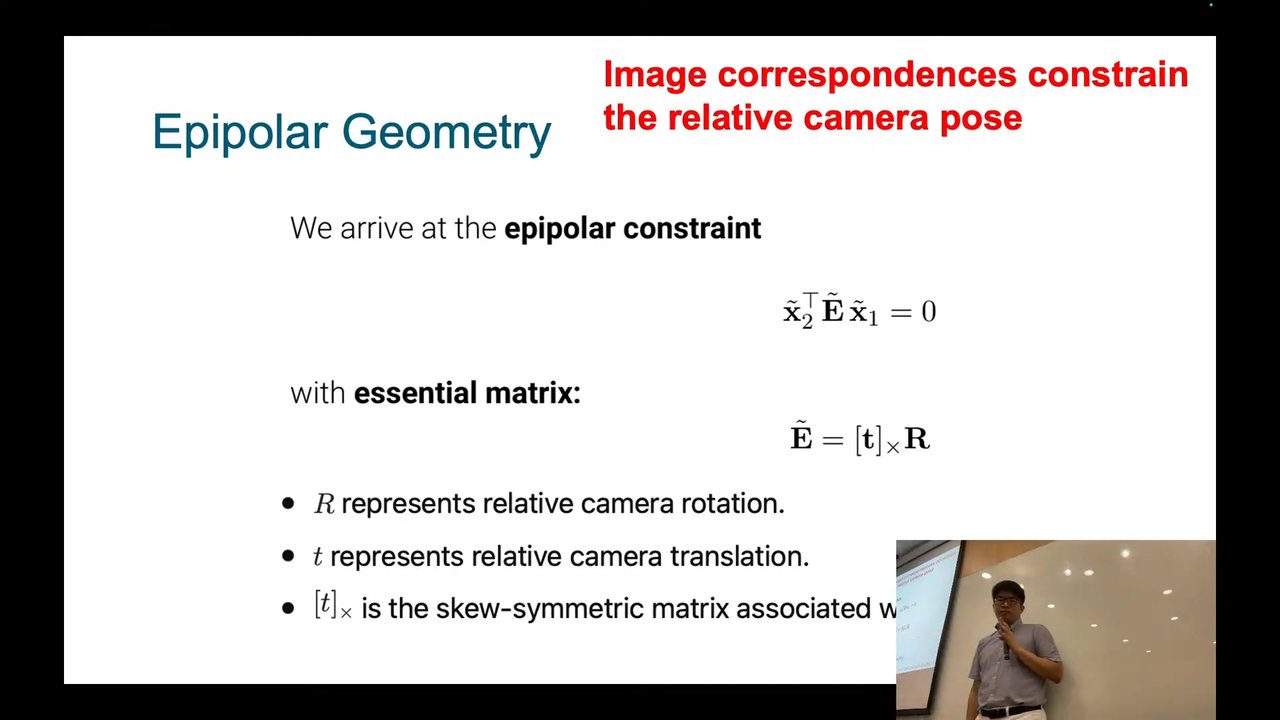
下一步是相機姿態估計,用的是極線幾何:一個 3D 點 X 與兩個相機中心張出一個極平面;X 在第一張影像的投影,其對應點在第二張影像中必定落在一條極線上。由此推出極線約束,把多組對應點代進方程式,就能解出兩台相機之間的旋轉與平移。
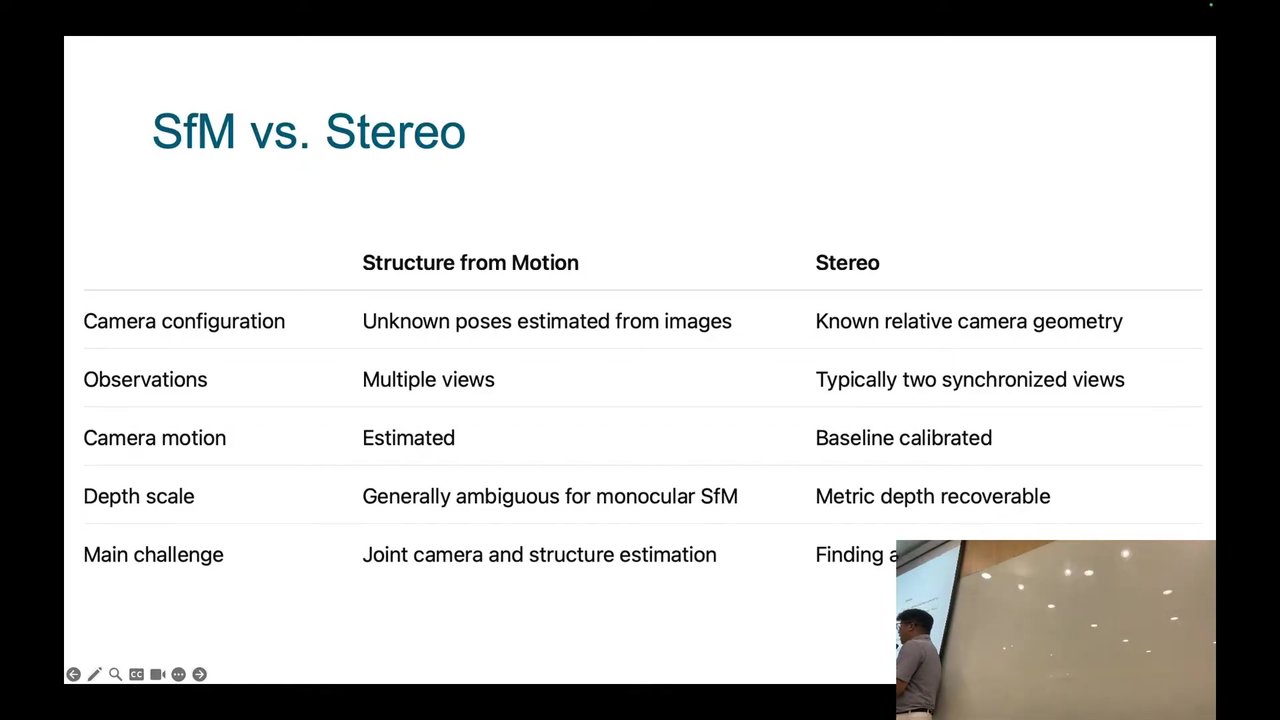
這裡有一個要小心的現象:尺度不定。從兩張單目影像還原出來的平移沒有實際的公制大小——算出一個數字,不代表相機真的移動了 10 公分,也可能是 1 公尺。這是 SfM 的根本限制。
三角測量、bundle adjustment 與 COLMAP
看老師講解(1:18:32)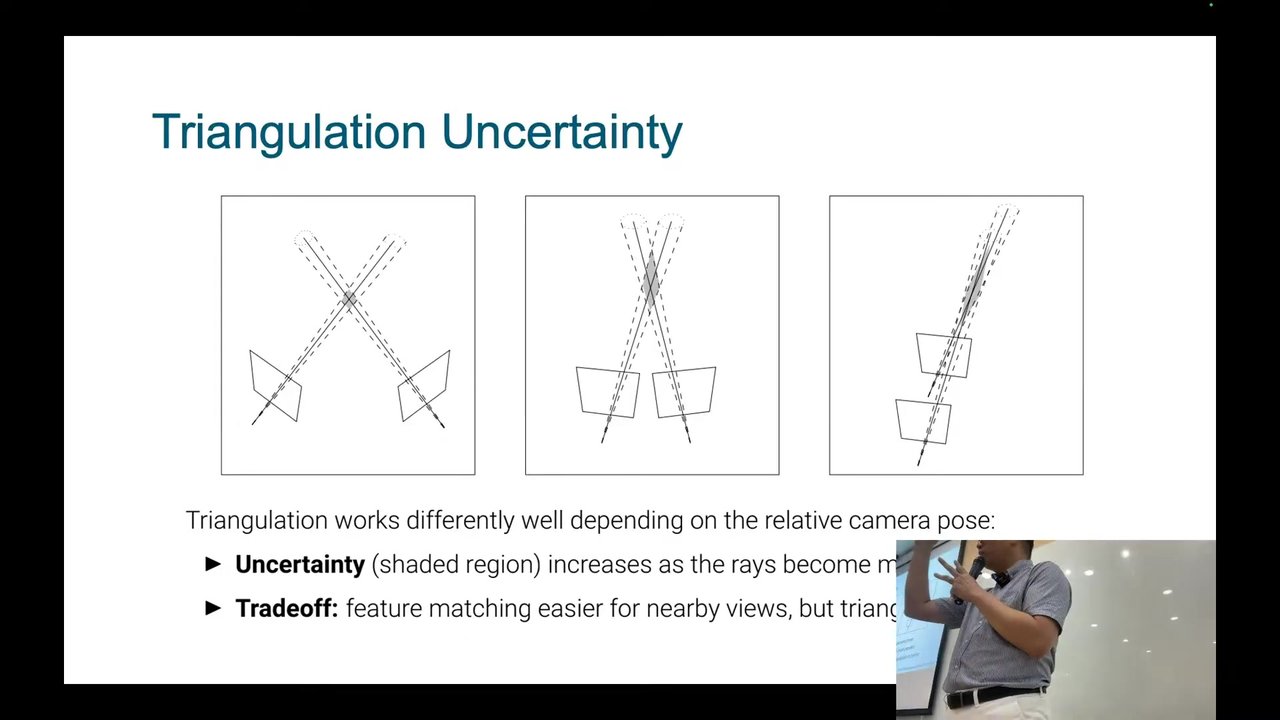
知道相機內參(焦距、主點 u₀、v₀)以及兩台相機之間的外參(旋轉與平移)後,用三角測量找出 3D 點:把未知的 3D 點投影到各個相機的成像平面,計算它與實際觀測到的 2D 點的差距,對所有點對最小化這個差距。兩台相機的射線夾角大,對應點比較難找,但 3D 位置比較確定;靠得近時對應點好找,不確定性卻會增加;完全平行時,就和單張影像一樣分不出點在射線上的哪裡。
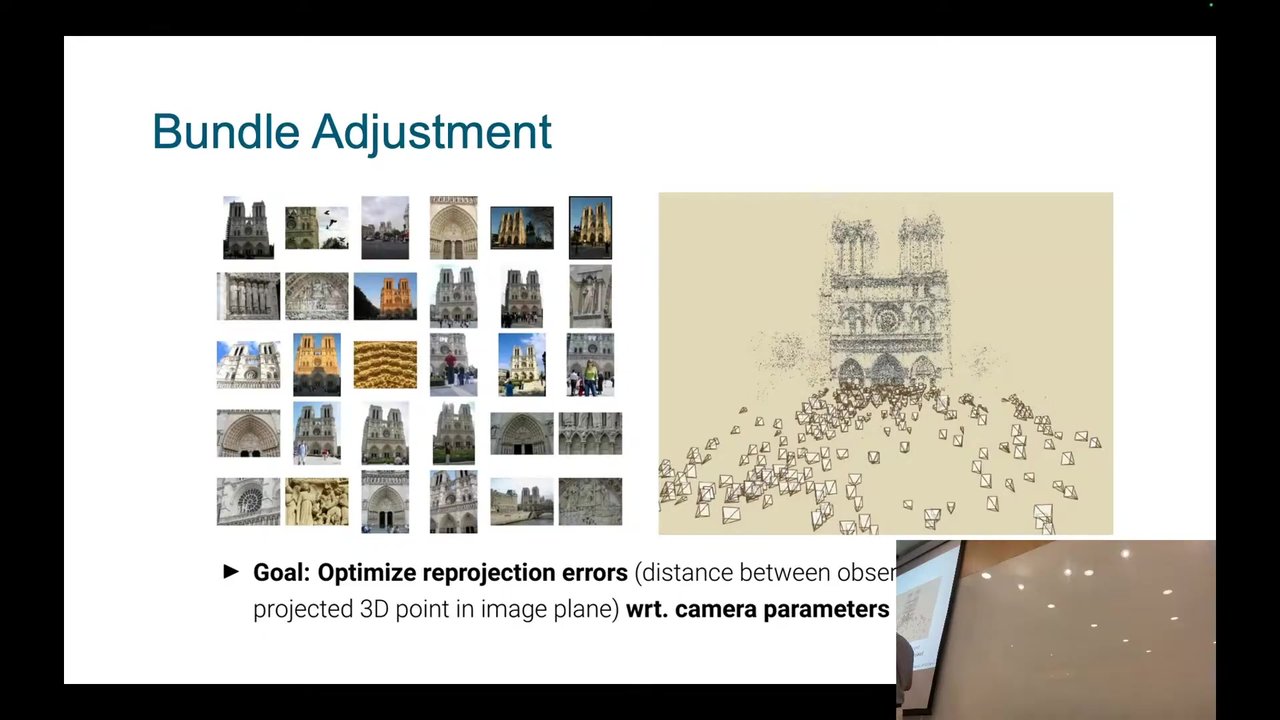
三角測量只用兩張影像、並假設相機姿態已知,提供初步的幾何重建。bundle adjustment(光束法平差)則用多張影像,同時修正相機姿態與 3D 點,最小化所有觀測的重投影誤差,提升整體與局部的一致性。
現代的 SfM 代表是開源的 COLMAP,誰都可以試。它的一個重要改變是增量式重建:一次把所有觀測丟進聯合最佳化太難,所以從兩個視角開始,逐步加入更多相機;找對應點時也不只比對相鄰的幀,而是跨越所有影像找最好的匹配。
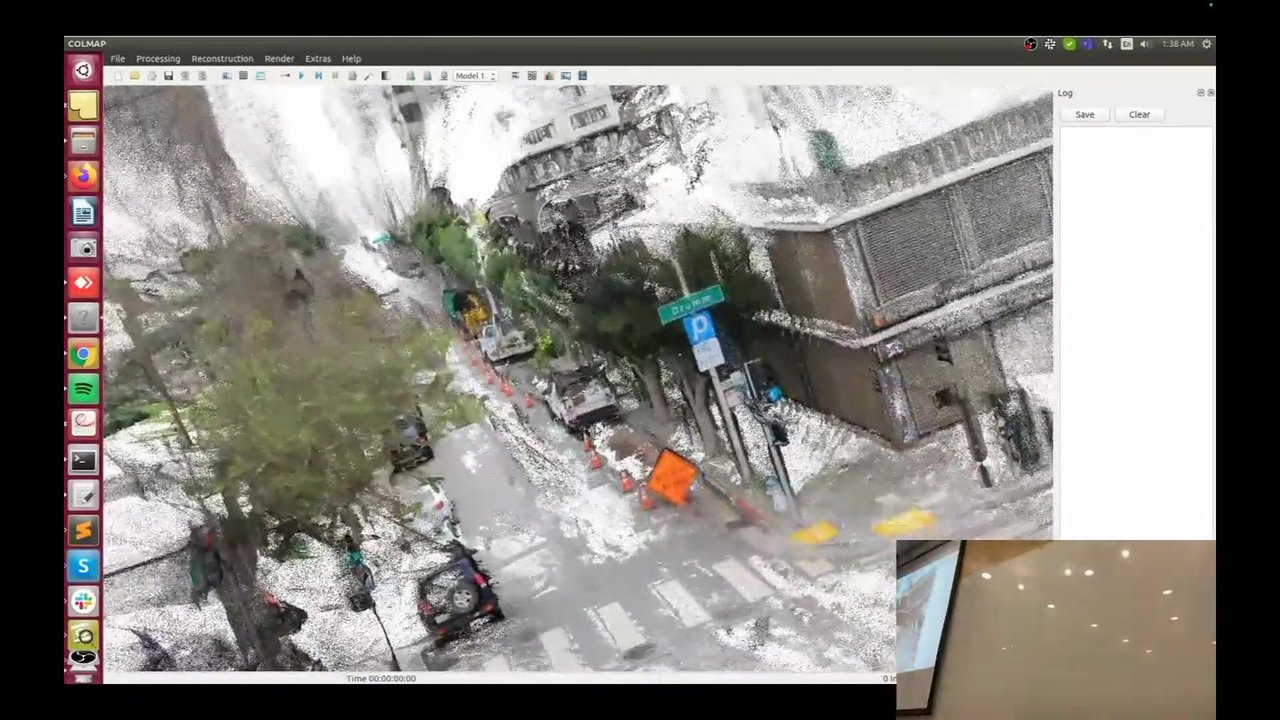
但他提醒,這不是真實尺度:看得出哪個比較近、哪個比較遠,卻沒辦法知道某輛車離相機是不是 5 公尺。
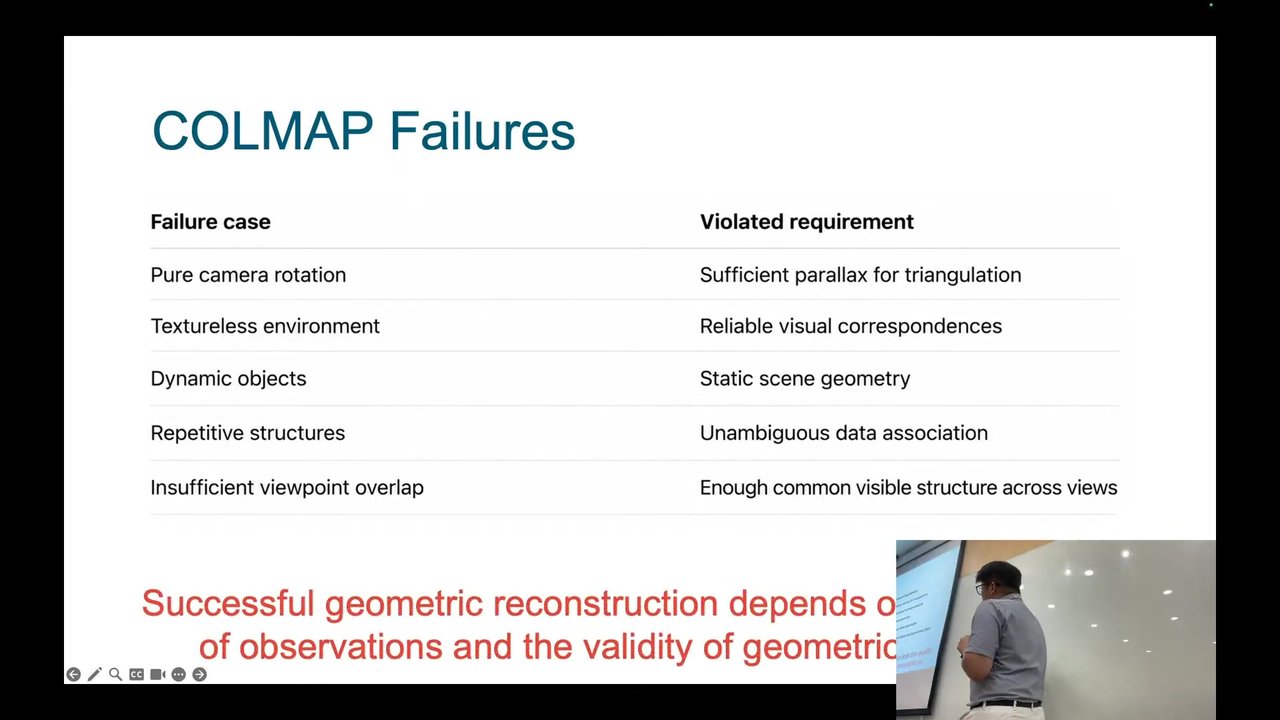
這張表和作業一直接相關:講者說會刻意把這些失敗情況放進資料,同學要能辨識哪裡違反了條件,把那些資料移除或重新收集。如果把每一筆資料都丟進演算法,重建結果可能很差——花了很多時間寫程式、收資料,卻拿不回想要的重建。作業會提供系統化的方式,幫大家找出失敗發生在哪裡。
尺度不定與立體相機
看老師講解(1:28:11)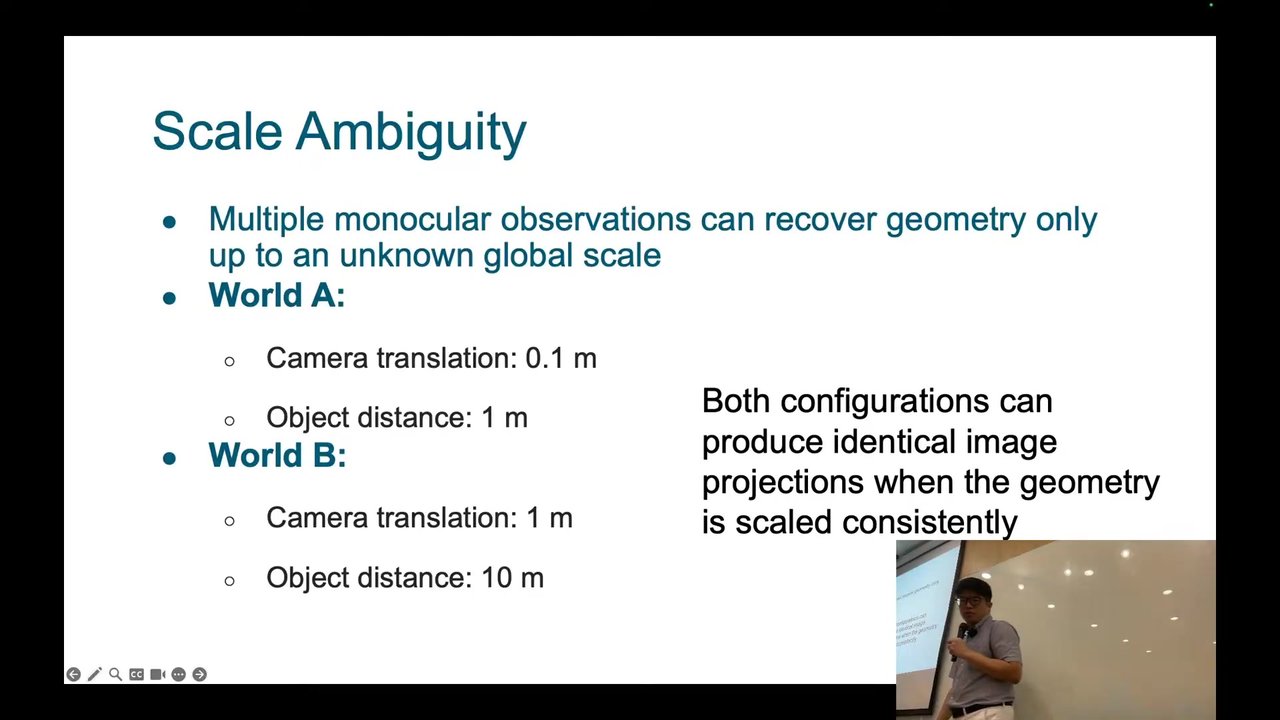
回到尺度不定。SfM 能還原結構,但不知道東西離我 1 公尺還是 10 公尺:相機移動 0.1 公尺去看 1 公尺外的物體,和移動 1 公尺去看 10 公尺外的物體,拍出來的影像一模一樣。
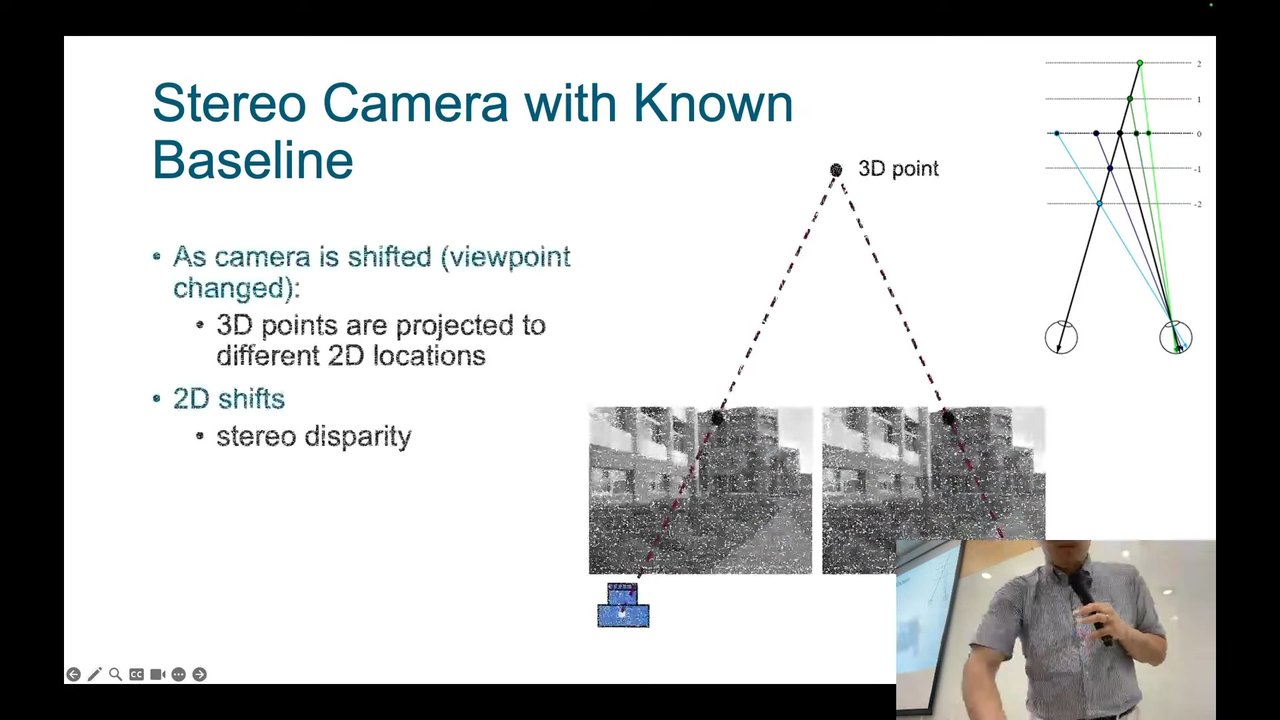
解法的靈感來自人的視覺:兩眼之間的距離是固定的,利用這個已知的距離,就能找出兩條射線的交點。立體相機模仿這個設定:一台相機在左、另一台往右移一段已知的距離。講者在課堂上請大家做個小實驗:閉上一隻眼,用大拇指遮住前方的東西,再換另一隻眼——大拇指看起來移動了,這就是雙眼視差。人眼能判斷誰近誰遠,卻說不出確切距離;立體相機則能把距離算出來。
換個角度看兩者的差別:SfM 要估計旋轉與平移;立體相機若兩台相機剛好平行,就沒有旋轉,只有沿 x 軸固定移動 b 的平移,轉換估計的不確定性就消失了。實際上很難把兩台相機裝得完全平行,所以會先用影像校正(rectification)把兩張影像轉成平行的狀態。
從視差算出深度:Z = bf/d
看老師講解(1:38:17)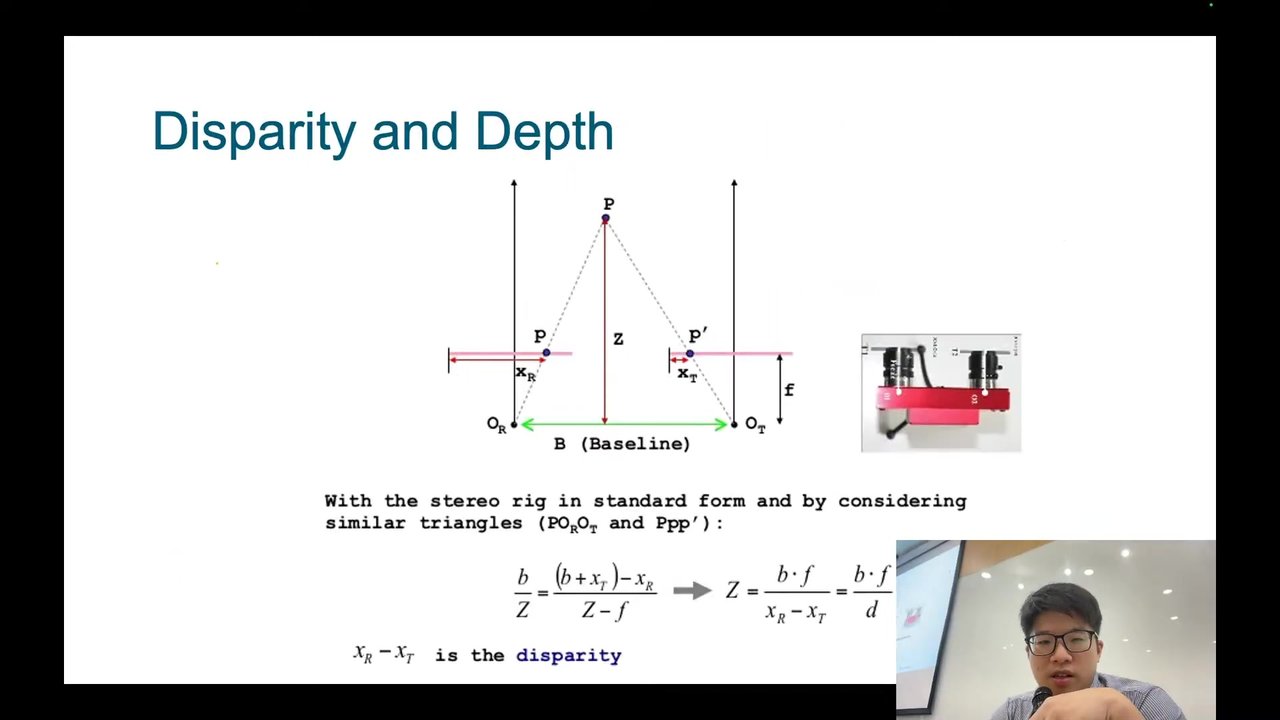
推導用兩個相似三角形。大三角形是 P 與兩個相機原點,底邊是基線 b、高是深度 Z;小三角形是 P 與兩個投影點 p、p′,高是 Z − f。p 與 p′ 的距離可以借一個平行四邊形算出:從影像邊界到 p′ 是 b + xT,再減掉邊界到 p 的 xR。兩個三角形的比例相等,整理後得到 Z = bf/d:深度由基線、焦距與視差三個量決定。
基線通常可以從相機規格表查到,講者展示的 Intel RealSense 規格表上就寫著 55 mm;焦距同樣可以查規格,或用相機校正取得。所以真正要算的只剩視差。講者問同學:要算 xR 與 xT,前提是什麼?答案是先知道 p 與 p′ 是同一個 3D 點的投影,也就是它們是對應點。
講者引用電腦視覺界一位知名學者的話:「電腦視覺最重要的三個問題是什麼?第一是對應,第二是對應,第三還是對應。」這一講已經出現三次:SLAM 要在 3D 找對應點,SfM 要在 2D 找對應點,立體相機算深度也要找對應點。這是電腦視覺最具挑戰的問題之一,也是推斷 3D 場景結構不可或缺的前提。
找對應點:沿著掃描線比對視窗
看老師講解(2:11:37)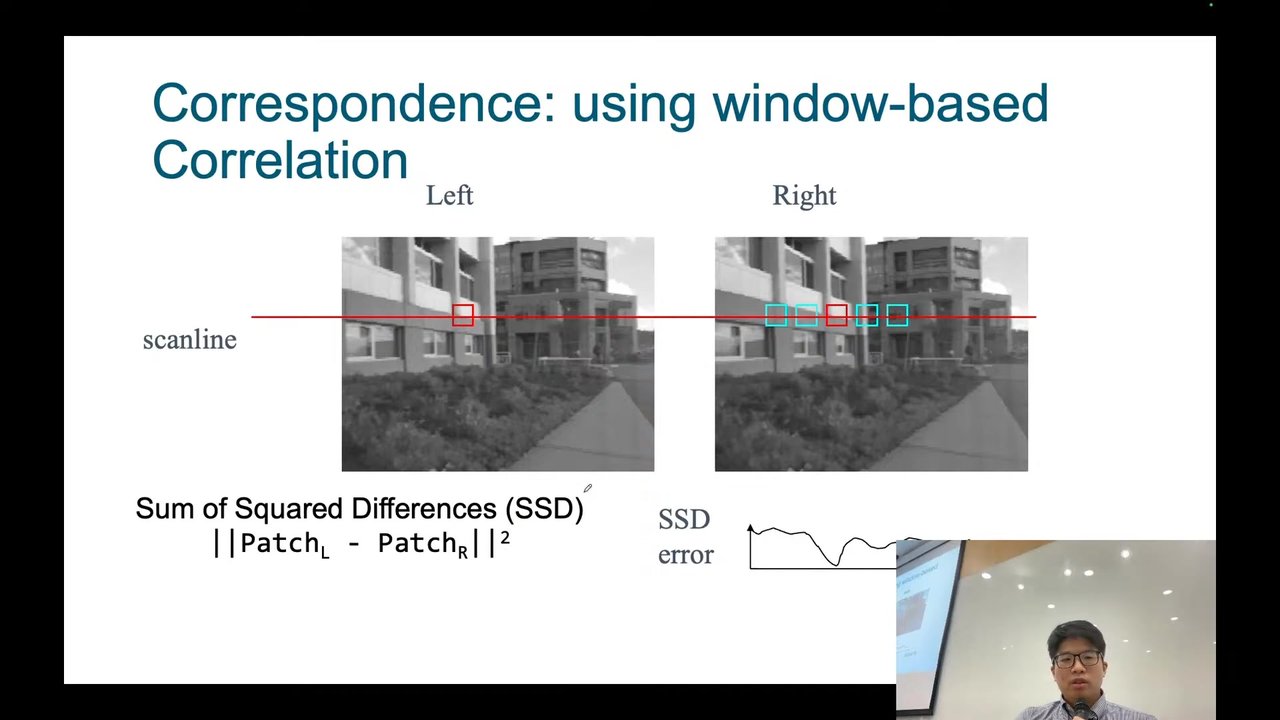
立體相機有一個很方便的性質:兩台相機平行時,對應點一定在同一條水平線上,只要沿著那條線搜尋。做法是在左影像的像素周圍取一個 5×5 的視窗,在右影像那條掃描線上從最左邊一路比到最右邊,計算兩個視窗各像素灰階值之差的平方和,取最小者當對應點,再數出 xR 與 xT 差了幾個像素。要注意單位:基線與焦距是公釐,視差卻是像素數,必須換算成同樣的單位。
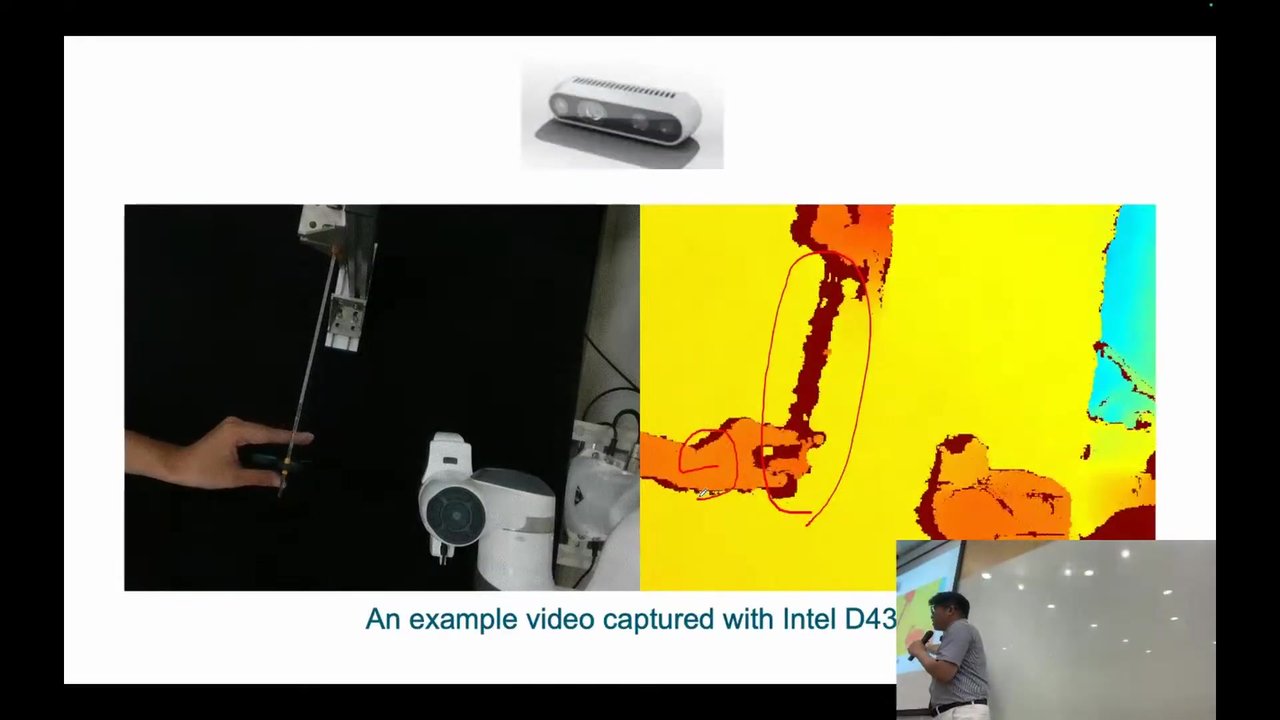
講者請大家猜原因。同學回答:視差計算要先找到對應點。換句話說,對應點找錯,視差就不準,深度估計就充滿雜訊。桿子變寬,可能是桿子周圍的點錯配到桿子上,看起來就比較靠近相機;畫面不穩定,則是因為對應點每次都有一點差異,視差也許只差 0.1,但深度和視差成反比,換算成深度就差很多。邊緣附近的誤差特別大,正是對應點容易找錯的地方。
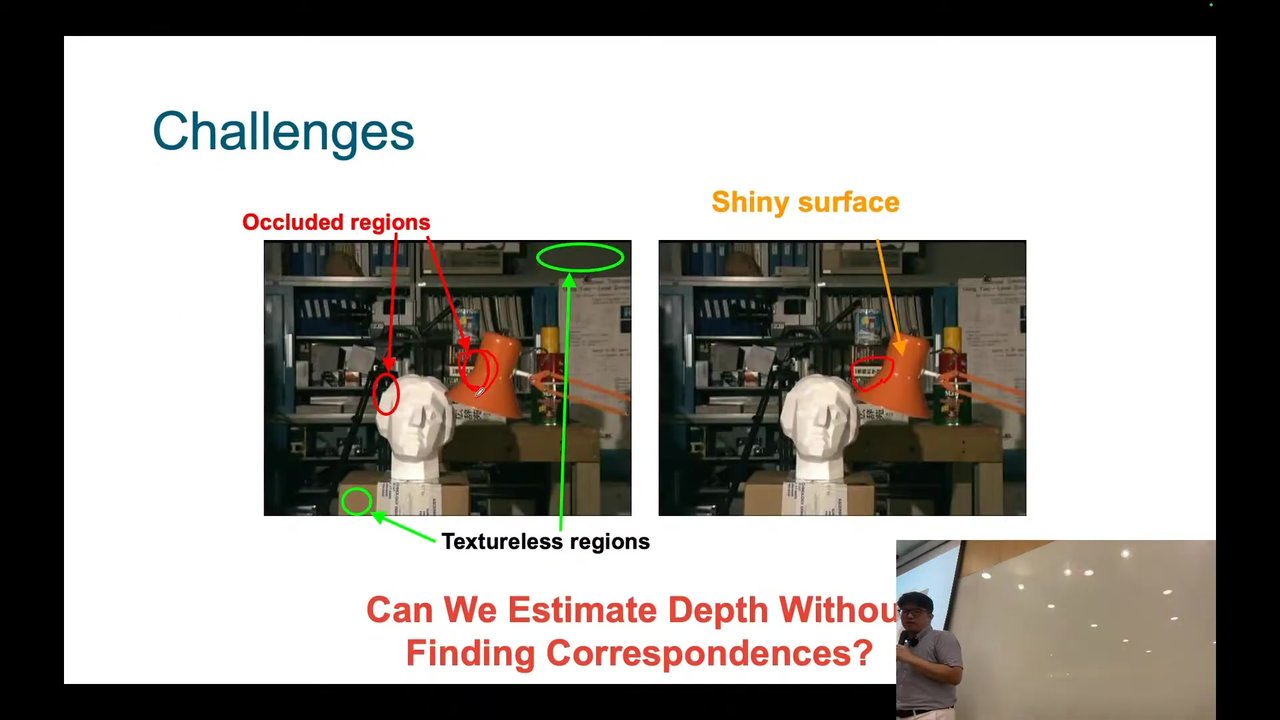
能不能不找對應點就估計深度?可以,那是本講原訂的第三部分「從視覺資料學習深度」。這次沒有時間講到,留到下週。
視差誤差會隨距離平方放大
看老師講解(2:22:27)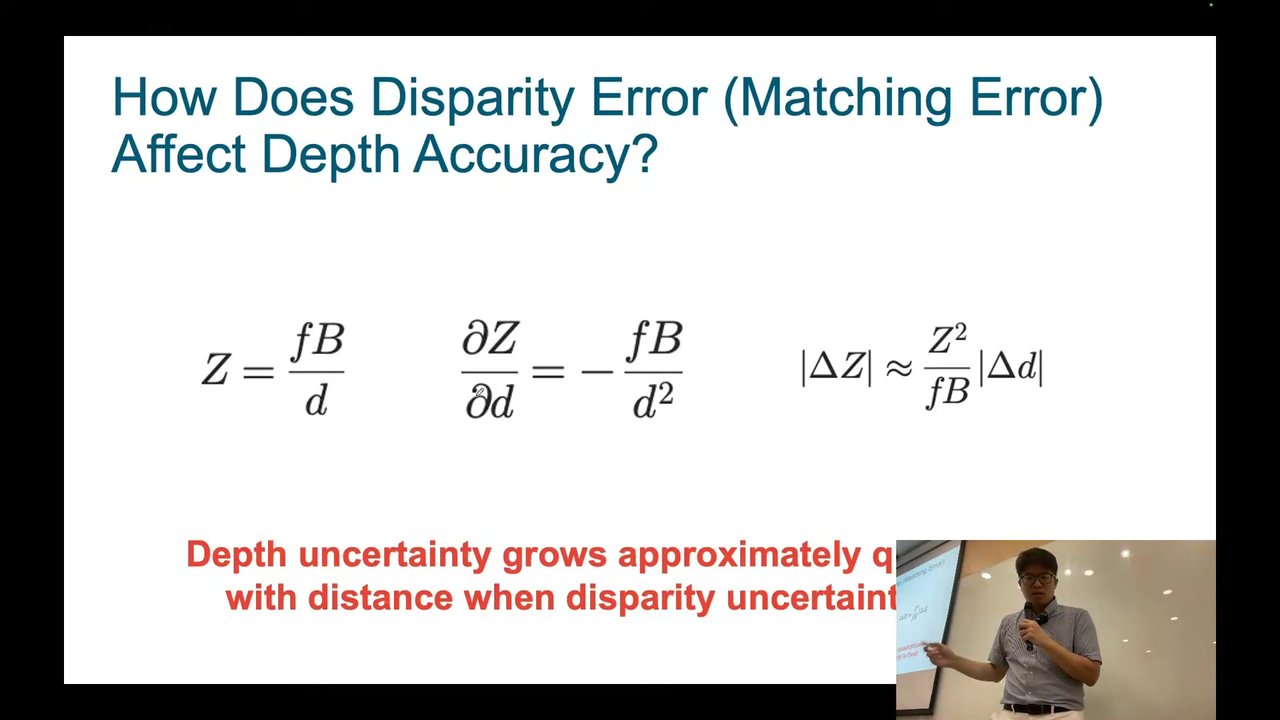
對 d 取偏微分、再把 d 用 Z 代回去,可以得到一個粗略的關係:視差上的小誤差,會乘上物體距離的平方變成深度誤差。物體越遠,同樣的匹配誤差就造成越大的深度誤差。
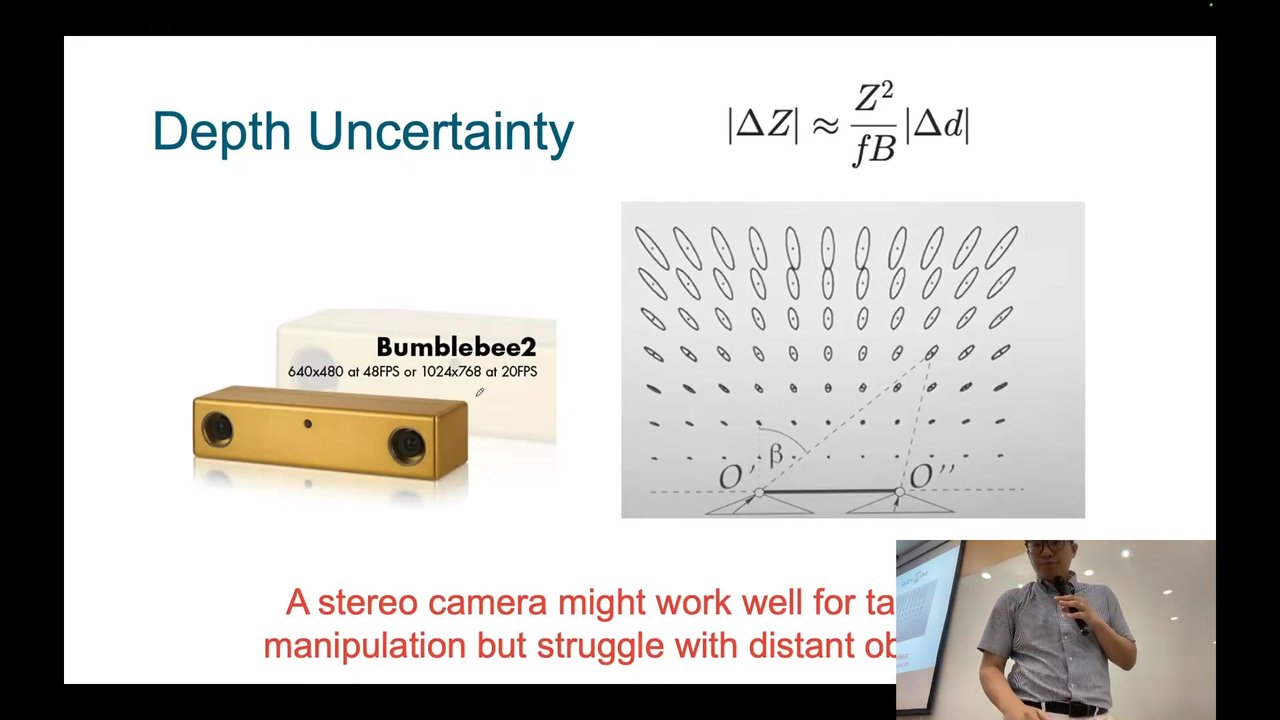
這也呼應講者上週說過的:立體相機在一定距離內(例如桌面操作)還可以,要用在戶外、物體在 10 公尺、20 公尺、50 公尺外的場景就不適合,誤差會隨距離平方成長。
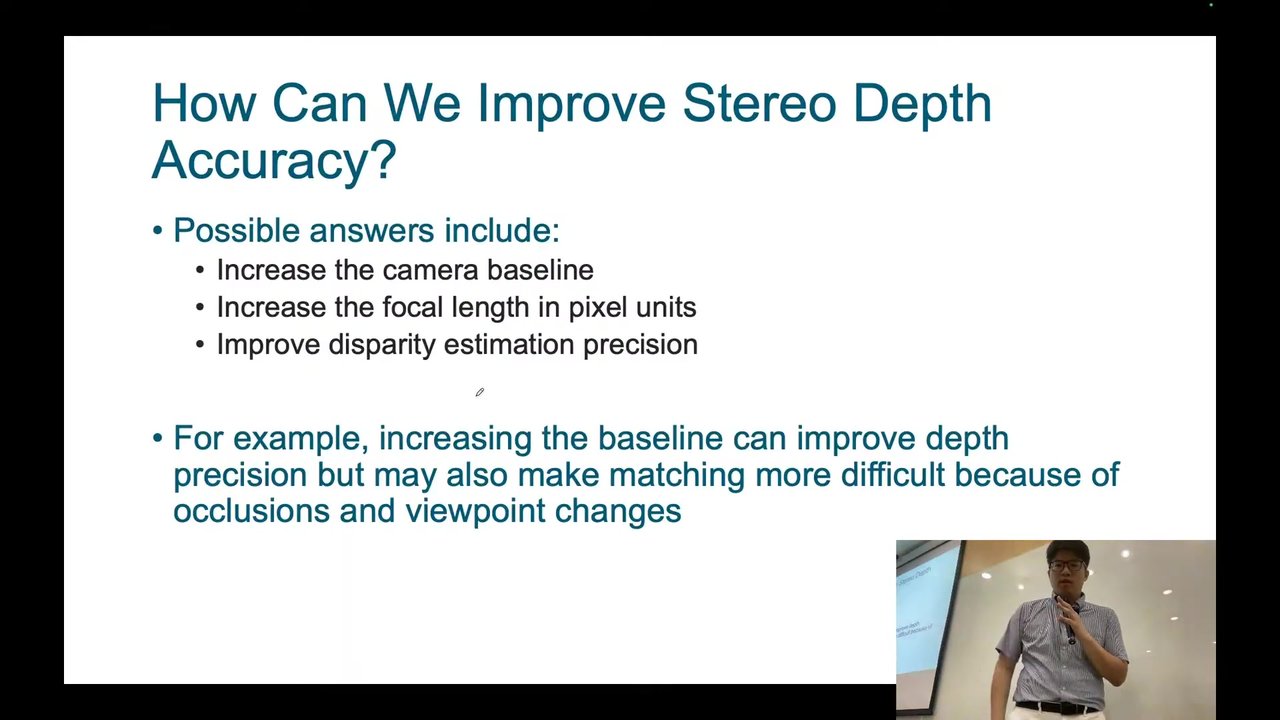
每個參數都有利弊:為了降低深度誤差而改變這些因素,同時也會影響其他方面的表現。
機器人需要哪一種深度
看老師講解(2:25:57)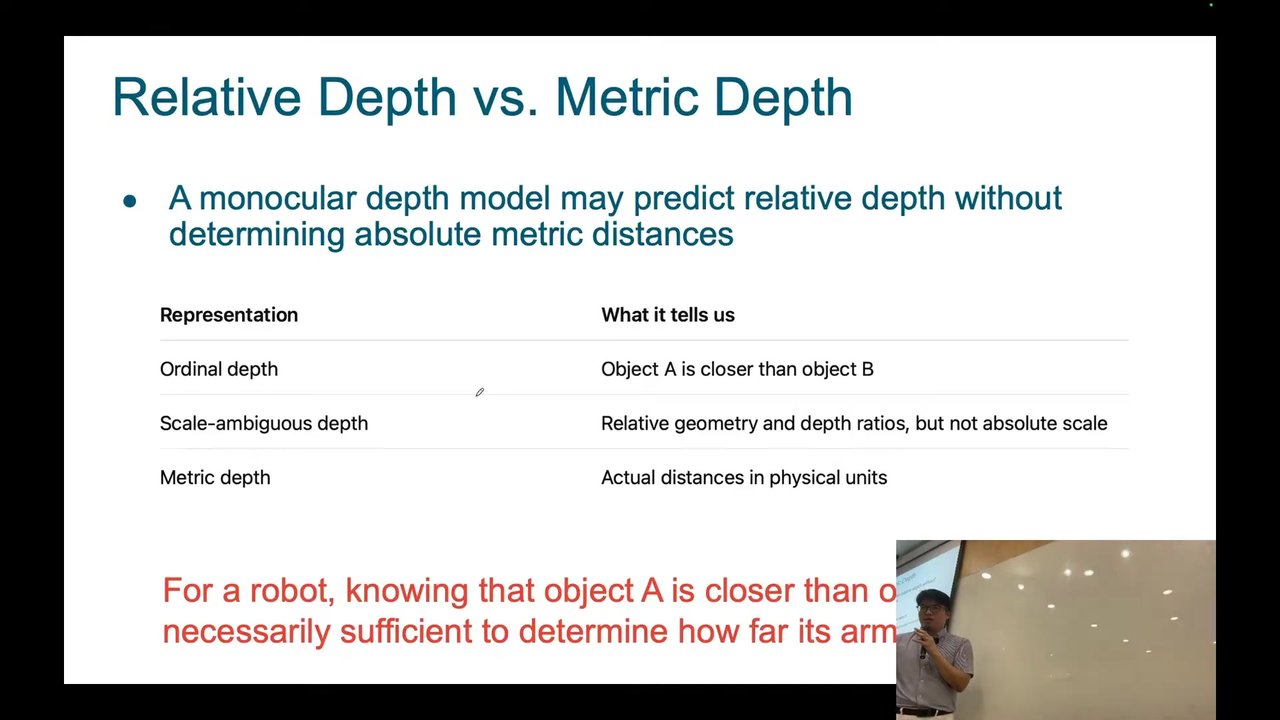
SfM 給的是尺度不定的深度,立體相機給的是公制深度。講者回到一開始的問題:對機器人而言,知道哪個物體比較近,對理解場景有幫助;但要導航或抓取,就得知道物體確切在哪裡。順序深度不夠,尺度不定的深度也不能讓機器人真的抓到東西,需要的是公制深度。原本接下來要講學習式的單目深度估計,講者因為時間關係先跳過,直接進入結論。
評估深度估計:準確度不等於能支撐行動
看老師講解(2:28:11)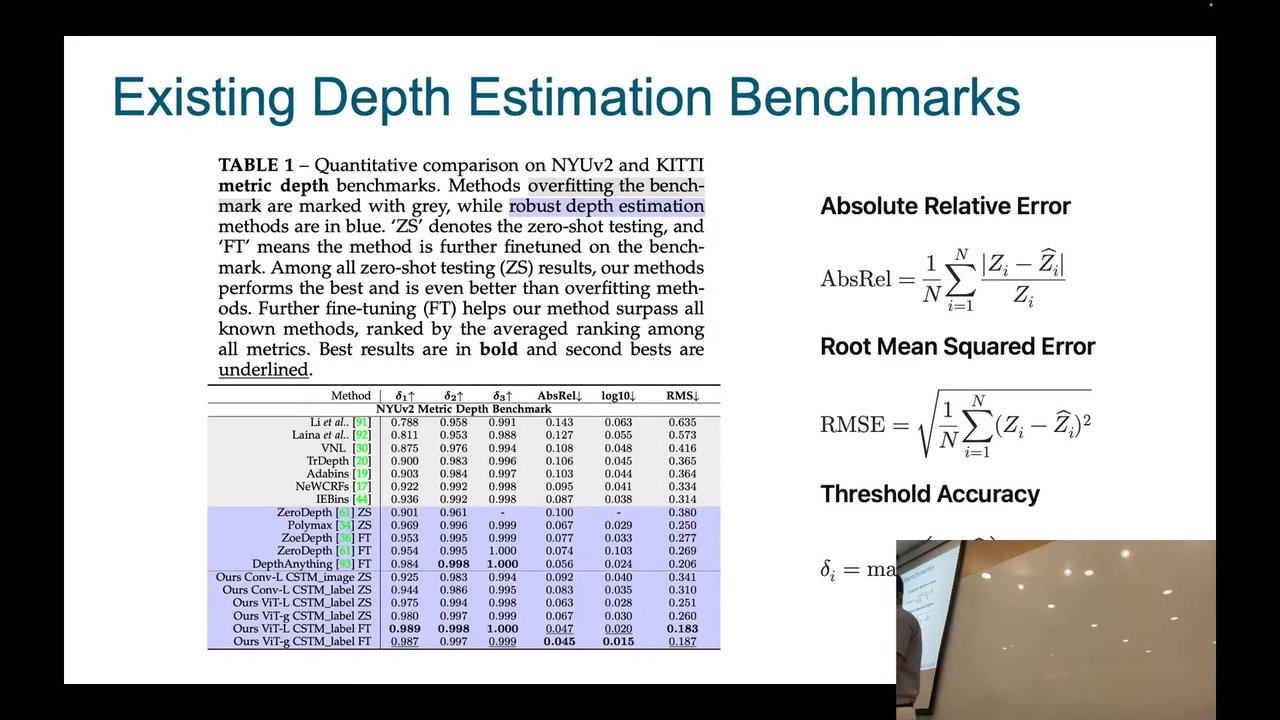
學界有大量研究在持續提升深度估計的準確度。講者隨手拿一篇論文的比較表:表上列了許多方法,用幾種指標衡量估計值與真實值的差距,再互相比較。
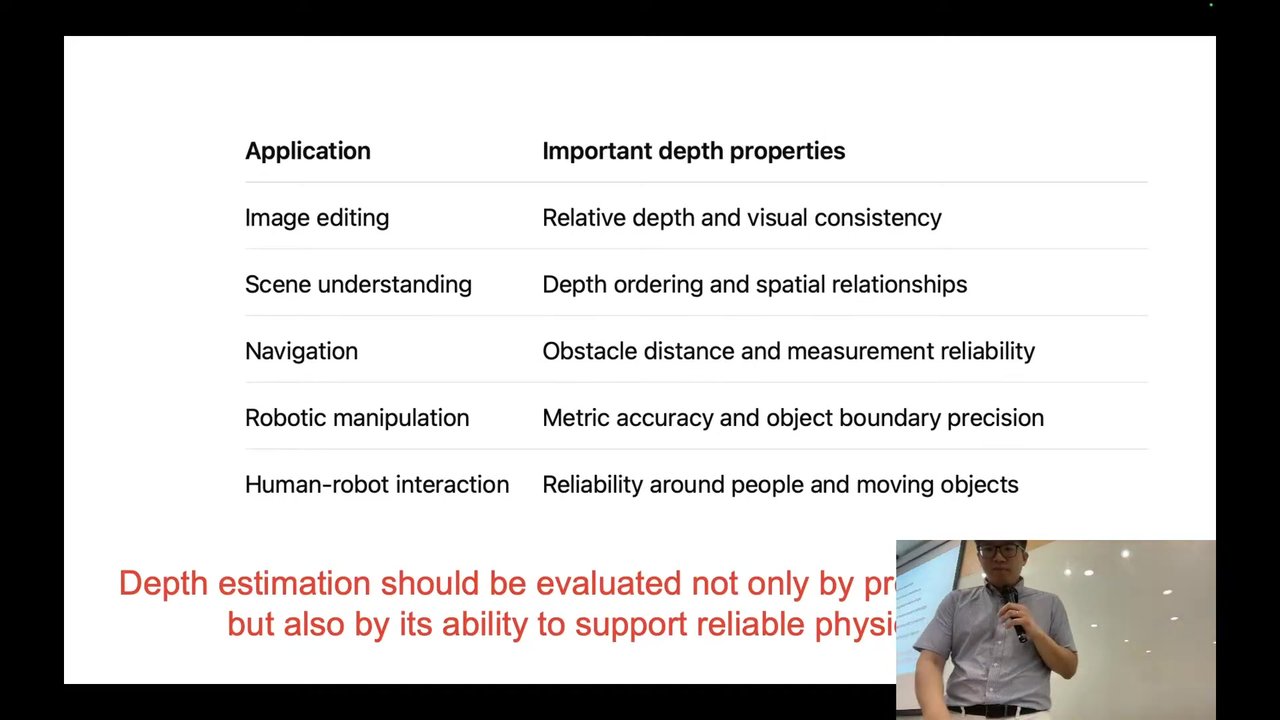
對影像編輯或場景理解,看預測準確度就夠了;應用一旦換成導航、操作或人機互動,就要知道物體與障礙物在哪裡,才能做出對應的反應。在表上拿到最好成績的方法,是不是就最適合物理行動?講者的回答是:不一定。
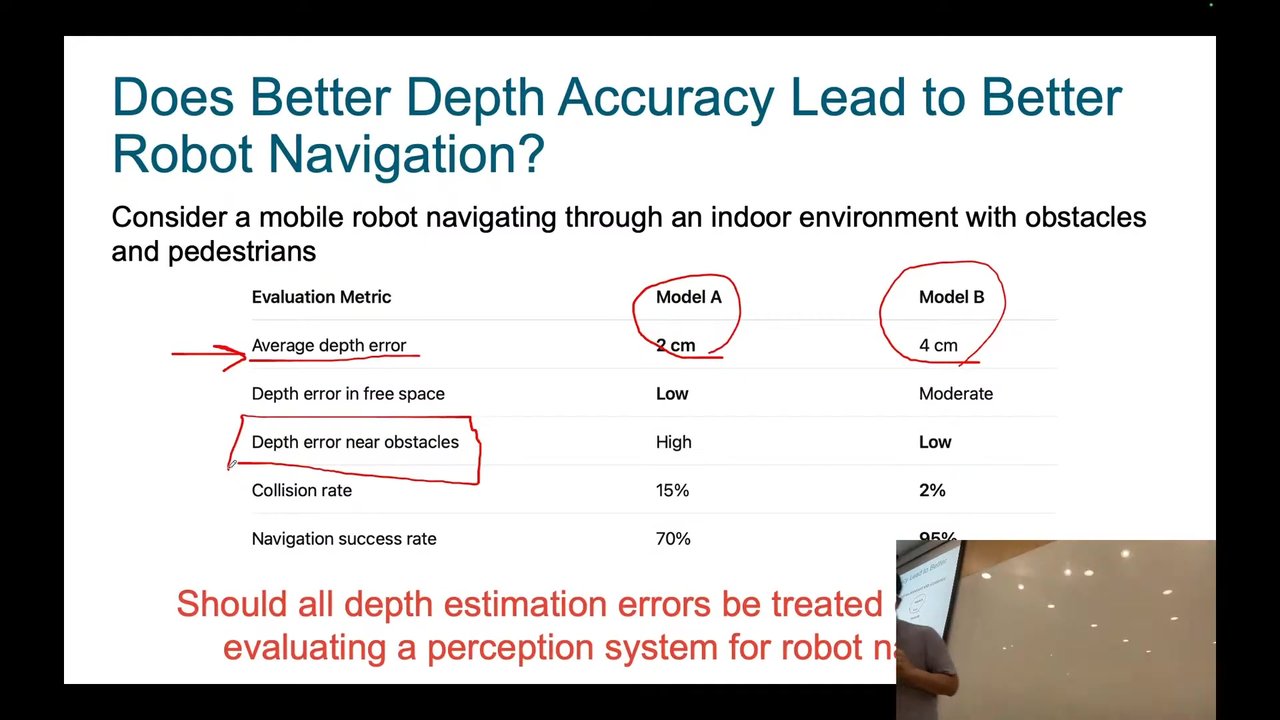
只看第一列,會以為模型 A 比較好;往下看,障礙物附近的誤差、碰撞率與導航成功率都是 B 勝出。可能的原因是:影像裡大部分像素都不是物體,模型 A 在這些像素上做得很好,物體附近卻比較差;但物體的像素少,全域平均時影響不大,平均誤差就顯得比較低。模型 B 在背景上做得沒那麼好,物體的深度卻估得相當準,而這正是導航最需要的資訊。
講者要大家記住:看到一個數字時要仔細檢查,不要把它當成金科玉律、只想著要打敗它。這個數字可能只在某些條件下成立,換個角度看,會看到完全不同的世界;為什麼平均表現好、導航卻不好,背後的落差要自己去挖。所謂魔鬼藏在細節裡,就是這個意思。
總結:精確重建不是最終目標
看老師講解(2:40:33)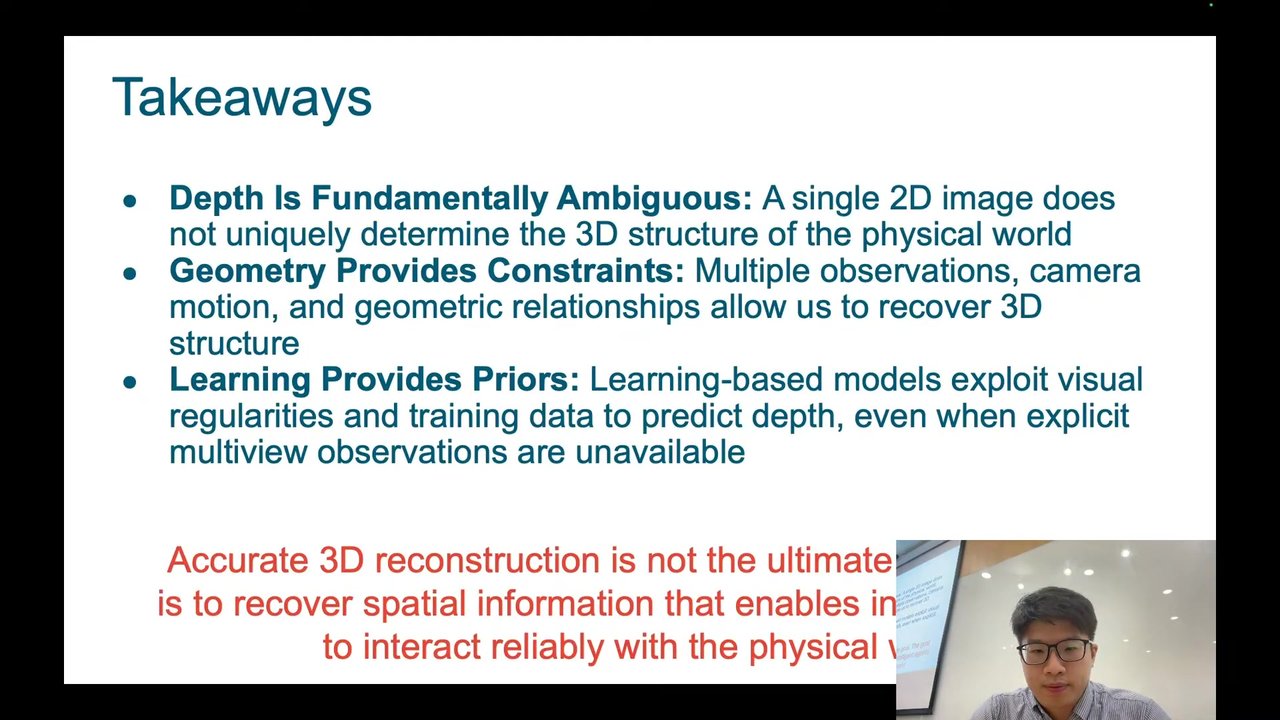
講者再次強調最後一點:精確重建很重要,但不一定是最終目標。對場景理解或影像編輯,重建精度就是重點;對這門課關心的應用,就算有完美的重建,如果接下來規劃怎麼行動、怎麼對物理世界做出反應、怎麼理解世界的性質都做不好,也不代表能可靠地與物理世界互動。不同應用有各自的目標,要先決定自己的目標是什麼。下週會補上這次沒講的第三部分(學習式深度估計),並接上第 7 週的路徑規劃與機器人導航。
複習與理解檢核
這一講要同時掌握演算法前提與應用後果。回答時請刻意指出:哪些量已知、哪些量要估、哪個假設若不成立就會失敗。
一、點雲配準與 ICP
- 兩組點雲做 registration 的目標是什麼?要求出的 ATB 如何被使用?
- 已知 3D 對應點時,為什麼旋轉與平移有直接最佳解?真正困難的是哪一部分?
- 按順序說明 ICP 的迭代流程:找對應、求轉換、更新、判斷停止。
- 「最近點」為什麼不一定是「同一個實體點」?錯誤對應會如何影響結果?
- ICP 為什麼需要好的初始猜測?誤差門檻、最大迭代次數、取樣方式各控制什麼?
- 特徵式取樣為什麼可能同時降低計算量並提高配準品質?白牆與門框哪個更有辨識度?
- 動態物體如何違反靜態世界假設,進而汙染姿態估計與地圖?
作答檢核
- 找旋轉和平移,使 B 轉到 A 後重疊區域距離最小,並用此轉換統一座標系。
- 固定配對後可最小化對應點距離並解析求解;難點是現實中不知道資料關聯。
- 最近點暫當對應→固定配對求最佳 R,t→轉換來源點並計算誤差→未達門檻且未超上限就重複。
- 相近可能只是幾何巧合;錯配會把最佳化拉向錯誤姿態,甚至收斂到局部錯解。
- 起點太遠時最近點假設失效;門檻定精度,迭代上限定成本,取樣影響速度與幾何約束力。
- 移除大量相似平面點、保留邊緣與角點;門框通常比白牆更容易唯一匹配。
- 同一實體點的位置不再固定,演算法會把物體運動誤認成相機運動,造成錯配與重影。
二、單目深度與 SfM
- 為什麼 monocular depth 是 ill-posed problem?請用「同一像素、同一射線」解釋。
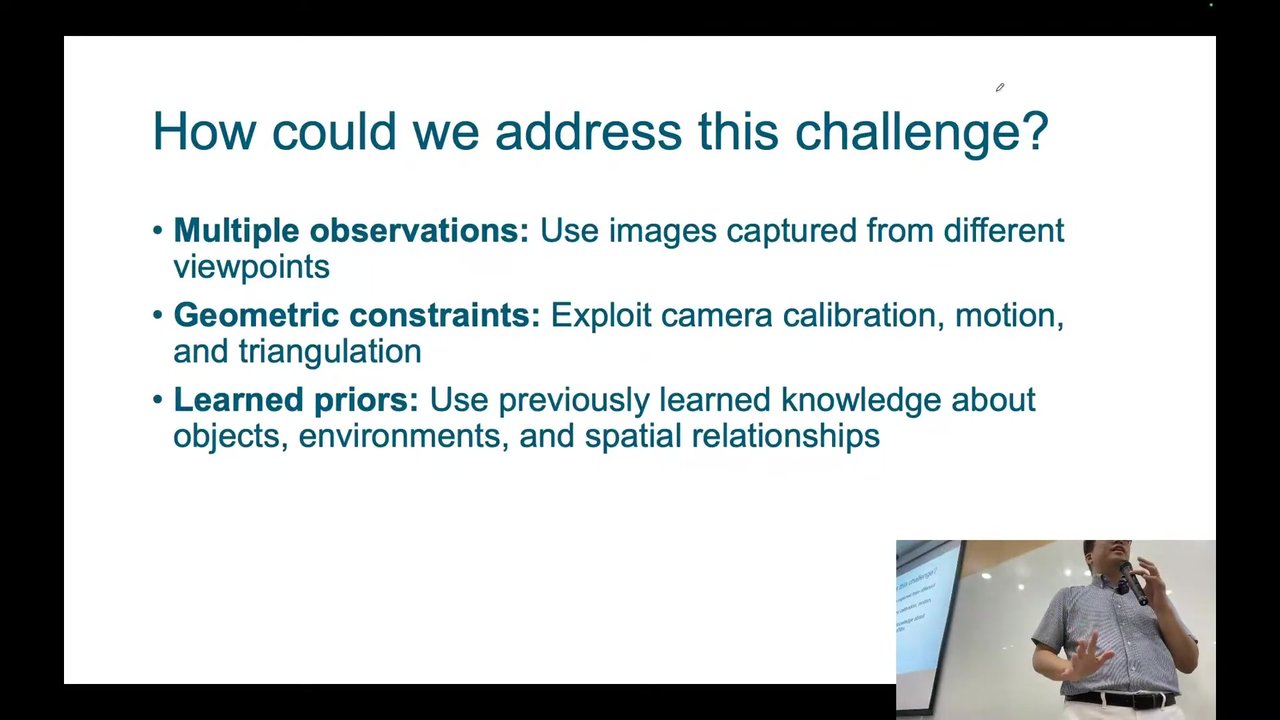
- 要解除單張影像的深度模糊性,可以加入哪三類資訊?
- 依序說明 SfM:特徵偵測、匹配、相機姿態、三角測量、bundle adjustment,各步驟解決什麼?
- SIFT 類特徵為什麼要對尺度、旋轉、光照與視角變化具有一定穩健性?
- 極線約束如何把兩張影像的 2D 對應點和相機相對姿態連起來?
- 三角測量時,視角太近與視角太遠各有什麼取捨?兩條射線接近平行時為什麼不確定性很大?
- bundle adjustment 比只做兩張影像三角測量多最佳化了什麼?重投影誤差代表什麼?
- COLMAP 在純旋轉、無紋理、動態物體、重複結構或視角重疊不足時,分別破壞了哪個必要條件?
作答檢核
- 3D 投影到 2D 時丟失 Z;射線上任意深度都能落到同一像素,單一觀測沒有唯一解。
- 多個觀測、相機與場景的幾何約束、從資料學到的物體/空間先驗。
- 找穩定點→建立 2D 資料關聯→估相機關係→恢復初始 3D 點→聯合修正相機與結構。
- 同一物理點在不同照片的大小、方向、亮度與外觀會改變,描述子仍須把它認成同一點。
- 對應點必須落在極線上,多組約束可求含相對 R,t 的本質矩陣。
- 近視角易匹配但基線小、射線近乎平行;大視角三角測量較準但外觀差異使匹配更難。
- 同時調整多台相機姿態與 3D 點;誤差是預測投影位置和實際 2D 觀測之差。
- 依序破壞視差、可靠特徵、靜態幾何、唯一資料關聯、共同可見結構。
三、尺度、立體視覺與誤差
- 用世界 A(0.1 m/1 m)與世界 B(1 m/10 m)說明 SfM 的 scale ambiguity。
- 立體相機如何用已知 baseline 補回公制尺度?SfM 與 stereo 的已知量、未知量有何不同?
- 從幾何意義解釋 Z = bf/d。物體越近時視差如何變化?
- 為什麼立體視覺最核心的問題仍是 correspondence?影像校正後,搜尋範圍如何被簡化?
- 用視窗 SSD 找對應點的流程是什麼?遮蔽、反光與無紋理區域為什麼容易失敗?
- 由 |ΔZ| ≈ Z²|Δd|/(fB) 說明遠距深度為何迅速不可靠。加大 baseline、提高焦距、改善視差各有何代價?
- ordinal depth、scale-ambiguous depth、metric depth 各提供什麼資訊?機器人抓取通常需要哪一種?
作答檢核
- 整個世界與相機位移等比例放大會產生相同投影,所以影像只能恢復相對結構,不能決定真實公尺數。
- 固定且校正過的 b 提供物理尺;SfM 要估相機姿態且尺度未知,stereo 的相對幾何已知、主要估視差。
- 深度和基線、焦距成正比,和視差成反比;近物體在左右影像位移較大。
- 必須確認左右像素來自同一 3D 點;rectification 後對應點位於同一水平掃描線。
- 沿掃描線比較小視窗並取 SSD 最小處;另一視角看不到、外觀隨角度變、或各位置長得相同時無唯一匹配。
- 誤差隨 Z² 增長;大基線增加遮蔽/視角差,高焦距縮小視野,精細視差增加演算法與計算需求。
- 只有前後順序、相對比例結構、真實物理距離;抓取與精確導航通常需要 metric depth。
四、評估與系統設計
- 模型 A 平均深度誤差較低卻碰撞更多,模型 B 平均誤差較高卻導航更成功。這如何可能?
- 為影像編輯、場景理解、導航、機器人操作、人機互動,各指出最重要的一項深度性質。
- 替室內導航設計一個比全域平均誤差更合理的評估:哪些區域應加權?還要量測哪些下游結果?
- ICP 的初始猜測可以從哪些感測器或先驗取得?你會用哪些訊號判斷它收斂到錯誤解?
- 桌面立體相機改拿去看 10 公尺外行人時,你會選擇換硬體、改演算法或縮小 ODD?請用誤差式和任務風險辯護。
作答檢核
- 大部分背景像素拉低 A 的平均誤差,但障礙物邊界較差;B 可能正好在決策關鍵區域更準。
- 可答視覺一致性、相對空間關係、障礙距離可靠度、公制與邊界精度、動態人周遭可靠度。
- 障礙物、邊界、行進路徑與動態人應提高權重;另測碰撞率、最小安全距離、成功率與緊急停止。
- IMU、輪速計、上一幀姿態、視覺特徵或已知運動;檢查殘差、對應比例、轉換突變、多感測器一致性與地圖重影。
- 沒有唯一選擇,但必須指出 Z² 放大、目標距離與可接受誤差,再連到感測範圍、安全後果與驗證成本。
五、最終口述挑戰
- 用三分鐘回答:「只有 2D 影像時,智慧 agent 如何取得可行動的 3D 資訊?」必須比較 SfM、stereo、學習先驗,並以應用導向評估收尾。
通過標準
能先指出單目模糊性,再說明多視角幾何可恢復結構但可能缺尺度、已知基線可提供公制深度、學習可加入先驗;最後強調最佳方法與指標取決於 agent 要做的物理行動,而非只看平均像素誤差。
內容整理自本專案 Lecture 6 影片及 YouTube 自動英文字幕;投影片截圖取自同一課程影片。繁中字幕已依台灣用語翻譯並通過格式驗證,專有名詞與數學符號依投影片與上下文校正,正式公開前仍建議人工複核問答與收音不清的片段。本講由每週排程自動整理上線。